字节笔记本
2026年10月7日 · 约 8 分钟读完
主键宽度按预期行数选
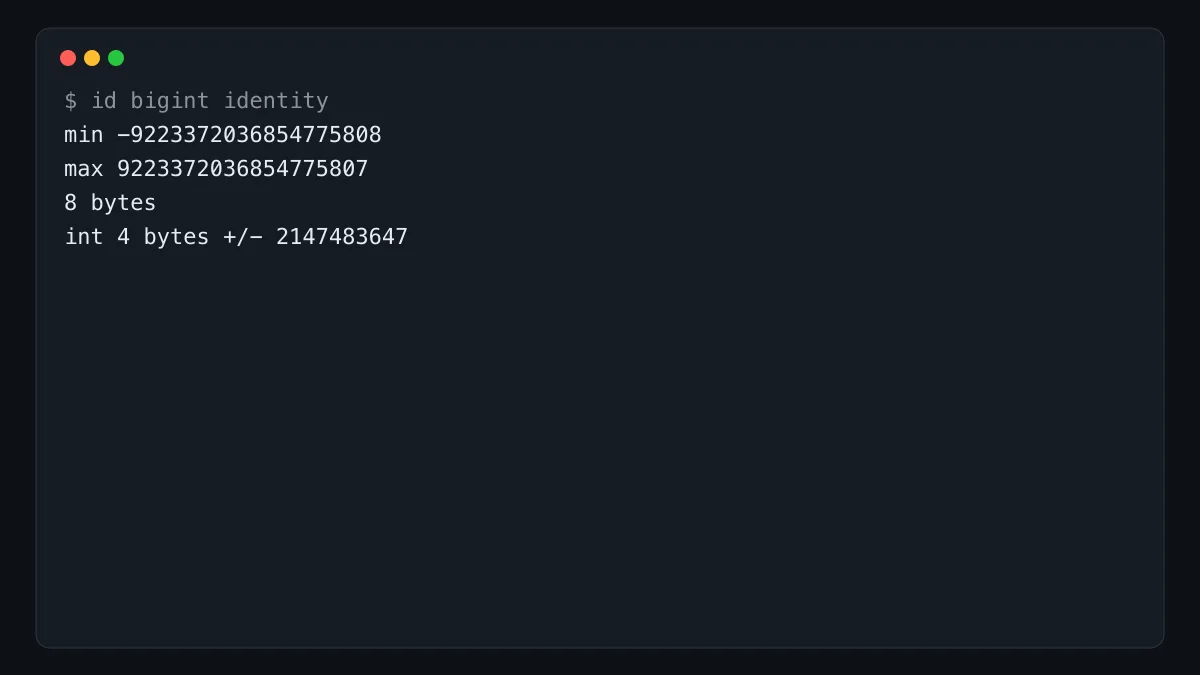
主键列若写成 bigint 再加 identity,插入时不用自己填这个数,范围是对话里给出的那一对界限:最小 -9223372036854775808,最大 9223372036854775807,也就是负的 2 的 63 次方,到 2 的 63 次方减一。存储是 8 字节。普通 int 是 4 字节,正负大约各 21 亿。没到那个规模时,对话认为 int 就够。
语法跟着数据库走
identity 表示值由库生成,通常递增,用来唯一标识一行。主键还要求不重复。自动生成解决的是“谁来填下一号”,主键约束解决的是“两行不能同号”。只开其中一个,另一个仍要写明。
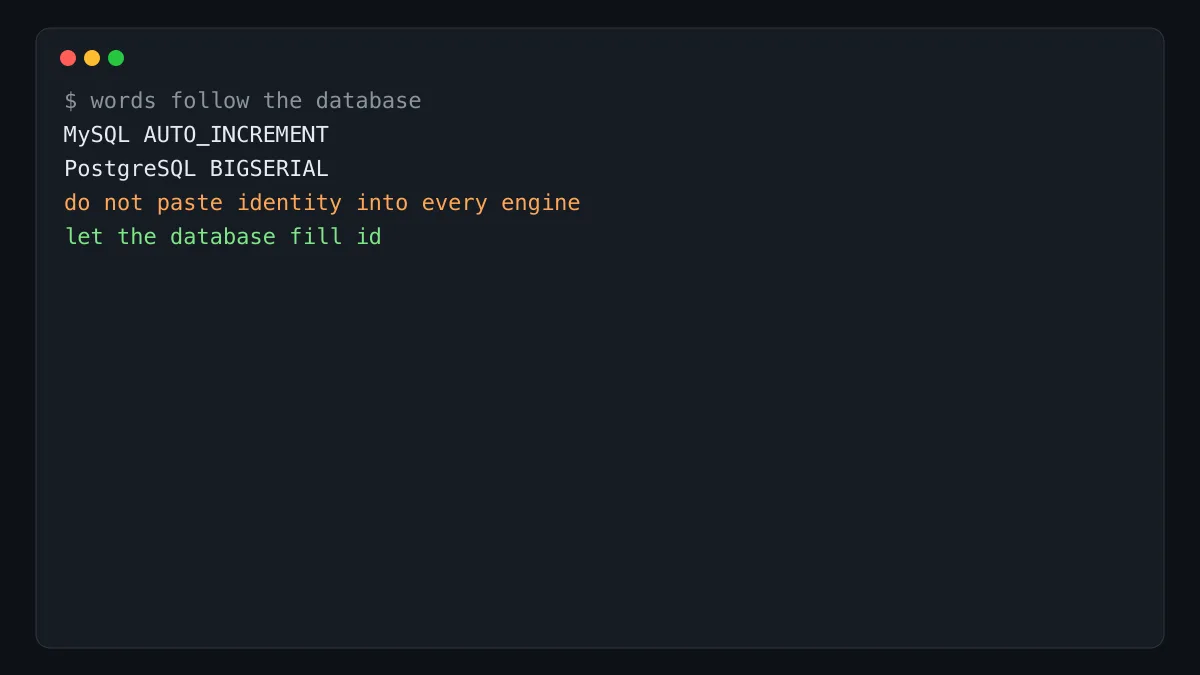
对话对比了写法。MySQL 里常见的是 AUTO_INCREMENT,不是 identity 这个词。PostgreSQL 里常见的是 SERIAL 或 BIGSERIAL。BIGSERIAL 才对得上 8 字节这一档。把 identity 原样贴进不认识这个词的库,语句会在建表时失败,不是在插入时才发现。先选定库,再选对应的自增写法。列名 id 只是习惯,没有魔法。
有符号的范围包含负数。自增主键一般从 1 往上走,用不到负的一半。对话把整段有符号范围都写了出来。容量按正数那一半估计就够用。不要把“从 -2 的 63 次方到正的上限”理解成可以插入这么多行而不碰撞,自增不会去填负数来扩大容量。
什么时候才用八字节
对话给出的比较是:int 大约到 21 亿,bigint 大到日常插行很难用完。它也写了,多数应用用 int 就够,除非行数会超过约 20 亿,或另有要求。八字节的索引比四字节占地方。表不大时,用大整数不会更正确,只是更宽。
选错的代价不对称。一开始用 int,行数接近上限再改成 bigint,要改列类型和引用它的外键。一开始就用 bigint,浪费的是每行多出来的字节。对话的建议是按预期行数选。没有“每秒大量插入、要跑很多年”的预期,就不必为了上限去用八字节。
identity 或自增在事务回滚之后,有的库不会把号收回。中间会缺号。缺号不破坏唯一,只是不能靠号的连续判断有没有删过行。业务若把“没有缺号”当成对账规则,自增对不上。对账用单独的序号,不要用主键的空洞。
插入时不要再给 id 指定一个手写值,除非明确关闭了自增并准备处理冲突。两处同时生成,会在主键上碰撞。让库填,代码里只填业务列。
先选库,再选宽度
列是 id,类型按行数在四字节和八字节之间选。界限用对话里的那一对 64 位有符号整数。MySQL 写自增关键字,PostgreSQL 用大序列类型,不要把 identity 四个字母贴到所有库。自增不保证连续。手写的号和自动的号不要一起填。
建表语句不要混用两家的词
选定 PostgreSQL 时,八字节自增用 BIGSERIAL,或该库支持的身份列语法。选定 MySQL 时,用 BIGINT 配合 AUTO_INCREMENT。把 identity 写进只认识 AUTO_INCREMENT 的语句,建表失败。把 AUTO_INCREMENT 写进 PostgreSQL,同样失败。失败信息在语法层,还没有主键冲突。对话把两种写法并列,就是为了避免这一步贴错。
四字节的上限约 2147483647,下限 -2147483648。八字节的上限是 9223372036854775807。从 1 递增时,比较的是正数这一头。四字节先到顶。到顶之后再改类型,引用该列的外键要一起改。所以预期会超过约 20 亿行时,一开始就用八字节。没有这个预期,对话认为四字节够用,索引也更窄。
自增不填补回滚留下的空洞。序号从 1 到 10,其中 4 回滚了,下一行可能是 11,中间没有 4。唯一性仍在。若业务用“最大 id 减最小 id 等于行数”去对账,会对不上。对账另做计数,主键只负责不重复。
应用插入时省略 id。手写一个已经存在的号,主键冲突。手写一个比当前自增还大的号,有的库会把下次自增推到这个号之后,有的不会,对话没有规定某一种库的推进规则,所以不要依赖手写去“跳号”。让库生成,代码只提供业务列。
id 这个名字可以换成别的,类型和自增写法才决定范围。换名字时,外键和查询要一起换。范围不会因为改名变大。
对话里的最小是 -9223372036854775808,最大是 9223372036854775807,占 8 字节。四字节 int 的最小是 -2147483648,最大是 2147483647。自增从正数往上走,用不到负的一半。比较上限时看正数这一头。四字节大约到 21 亿就到顶。对话说多数应用用 int 就够,除非行数会超过大约 20 亿。
后一句把正负加起来说成大约 92 亿亿。9.22 乘 10 的 18 次方只是正数上限这一头的量级,不是正负两端的总个数。总个数大约是 2 的 64 次方。写容量时用那一对明确的界限,不要用这句约数当精确倍数。对话还说 bigint 大约是 int 的 20 亿倍,那也是约数,不拿来做容量公式。
比八字节整数更宽的,对话列了 DECIMAL 或 NUMERIC,精度可变,并写最大通常为 38 位数字。PostgreSQL 的 numeric 受内存限制。浮点 FLOAT 和 DOUBLE 不是精确整数,不适合当自增主键。极大的数也可以放进字符串,但库就不会再按数值比较。主键仍优先用整数自增。没有科学计算或超高精度的需求,不必换掉 bigint。
MySQL 写 AUTO_INCREMENT,PostgreSQL 用 BIGSERIAL 才对得上八字节。identity 这个词不要原样贴到不认识它的库。自增解决谁来填下一号,主键约束解决不能重复。回滚留下的空号不收回,不能用号的连续去对账。插入时不要手写 id,占位符和自动生成撞在一起会主键冲突。
建表之前先选定数据库。PostgreSQL 用 BIGSERIAL 或该库文档里的身份列,MySQL 用 BIGINT 加 AUTO_INCREMENT。语句在语法层失败,说明词贴错了库,还没有发生主键冲突。四字节够不够,用预期行数去对 2147483647 这个上限,而不是用“大约 20 亿倍”去做乘法。八字节的上限用 9223372036854775807。索引会随列变宽。没有超过四字节上限的预期,就不必为了上限改成八字节。插入语句省略 id。手写已经存在的号会冲突。手写一个更大的号会不会推动下一次自增,对话没有给出统一规则,所以不要靠手写跳号。对账用单独计数。主键的空洞只说明有过回滚或删除,不说明行数等于最大号。
选定库之后再写建表语句。词用错会在执行建表时失败。宽度按行数预期选。没有超大行数的预期,四字节就够,索引也更窄。八字节用来躲开以后改类型。编号让库填。对账不要依赖编号连续。正数上限和存储宽度要一起看。四字节约到二十一亿,八字节用对话里写出的那一串上限。约数只帮助记忆,不参与计算。浮点能表示很大的量级,却不能当作精确的主键。定点类型更宽,但没有自增主键那种逐行加一的用法。日常表仍在两种整数里选。