字字节笔记本·1 天前快讯
从 28.6% 到 89.7%:LeWAM 让 JEPA 机器人又能控制又能规划
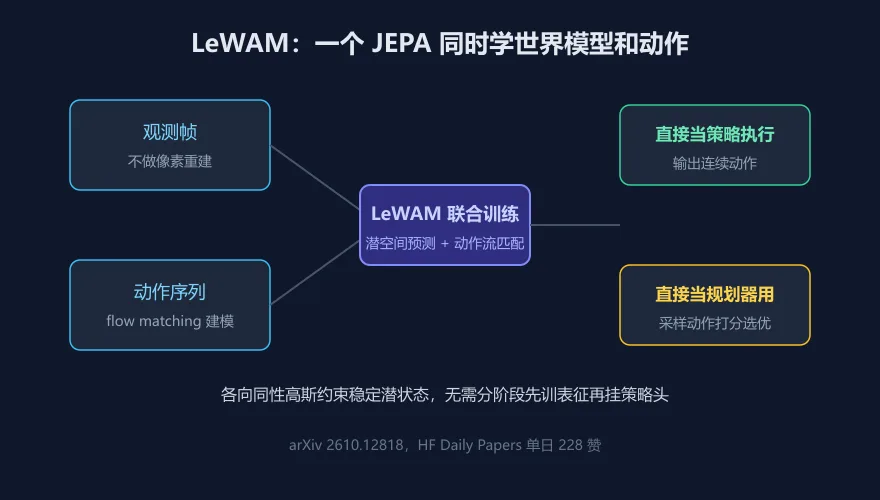
HF Daily Papers 榜首论文 LeWAM 把世界建模与动作建模合入一个端到端 JEPA:接触密集任务成功率从 28.6% 提到 89.7%,规划提速 32.3 倍,仿真与实机均有验证。
3 分钟
发现 AI Agent、开发工具、开源项目与效率软件,跟上每日科技与工程实践。
编辑精选
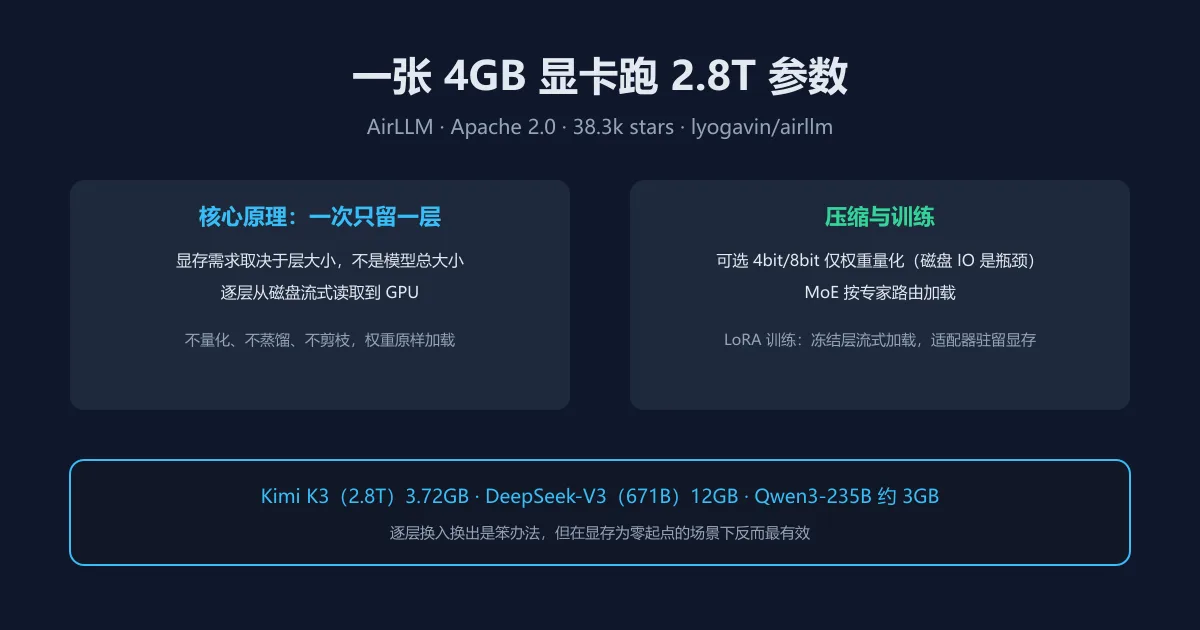
不量化、不蒸馏、不剪枝,AirLLM 用逐层流式加载把万亿参数模型的推理显存压到个位数 GB;Kimi K3 只需 3.72GB,DeepSeek-V3 约 12GB,还支持 LoRA 训练。Apache 2.0,38.3k 星。
最新精选
HF Daily Papers 榜首论文 LeWAM 把世界建模与动作建模合入一个端到端 JEPA:接触密集任务成功率从 28.6% 提到 89.7%,规划提速 32.3 倍,仿真与实机均有验证。
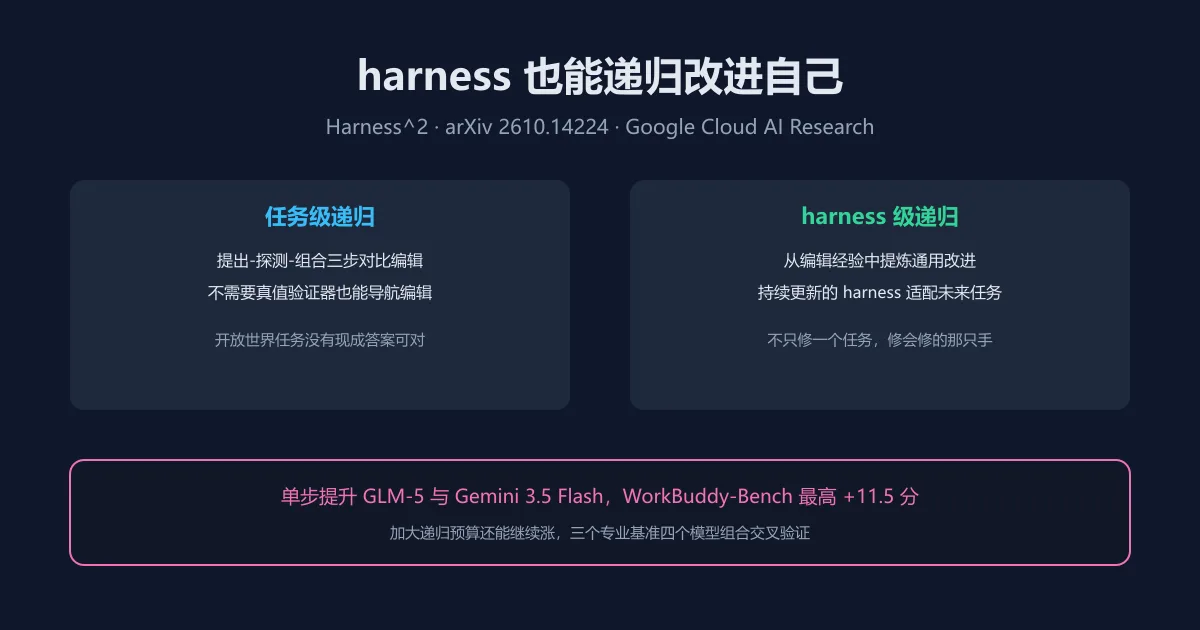
开放世界任务没有真值验证器,RSI 又常是任务定制的。Google Cloud AI Research 的 Harness 平方框架用双层递归打通:任务级做无验证器的对比编辑,harness 级把编辑经验提炼成持续改进的上层 harness。
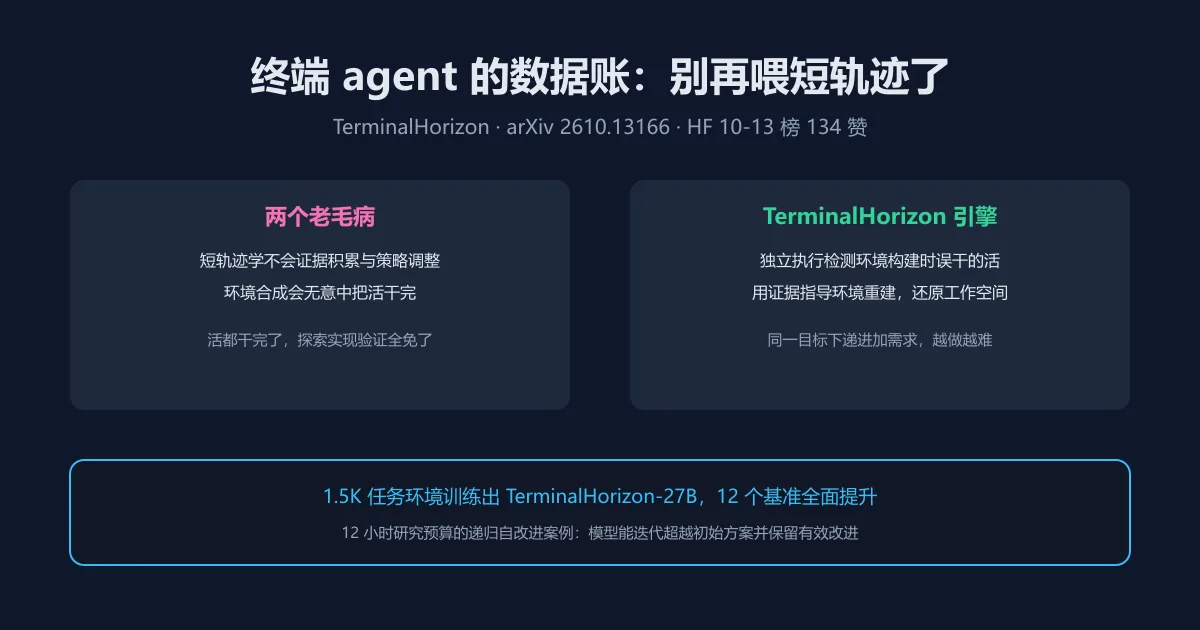
短轨迹学不会证据积累和策略调整,环境合成还常常把活提前干完。TerminalHorizon 引擎用独立执行检测误干、递进扩展任务,1.5K 环境微调 Qwen3.5-27B 后 12 个基准全面涨分。
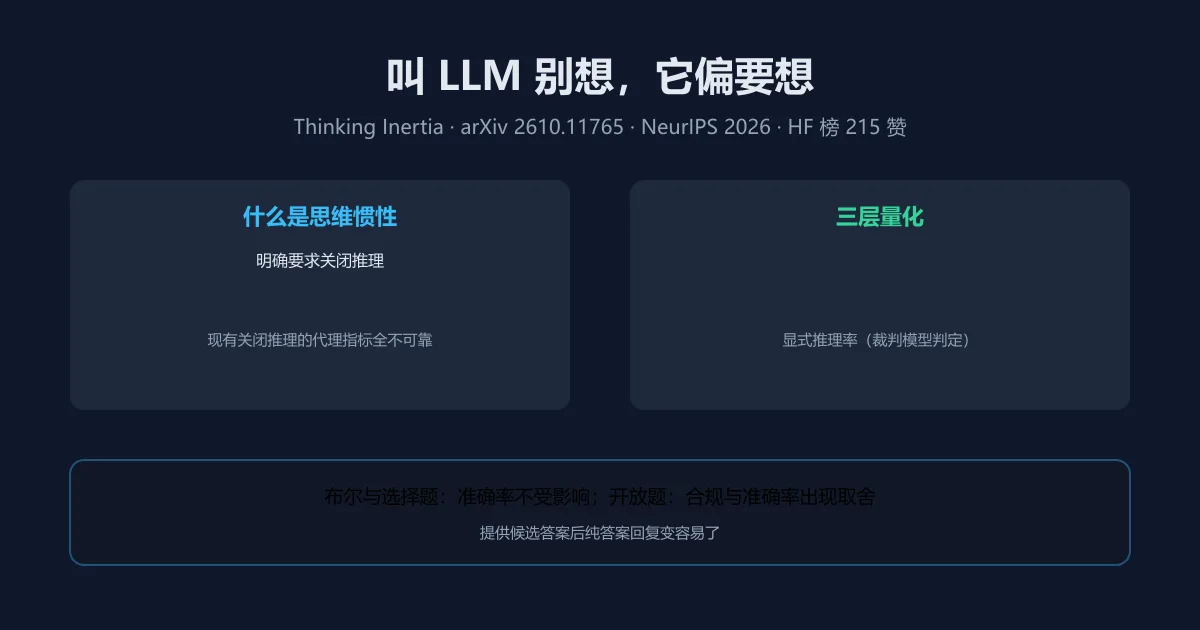
明确提示模型别推理,它还是在答案前吐出一长串分析。NeurIPS 2026 论文 Thinking Inertia 把这个现象拆成三层量化指标,六种干预六个模型实测全中招;开放题上关推理甚至要付准确率代价。
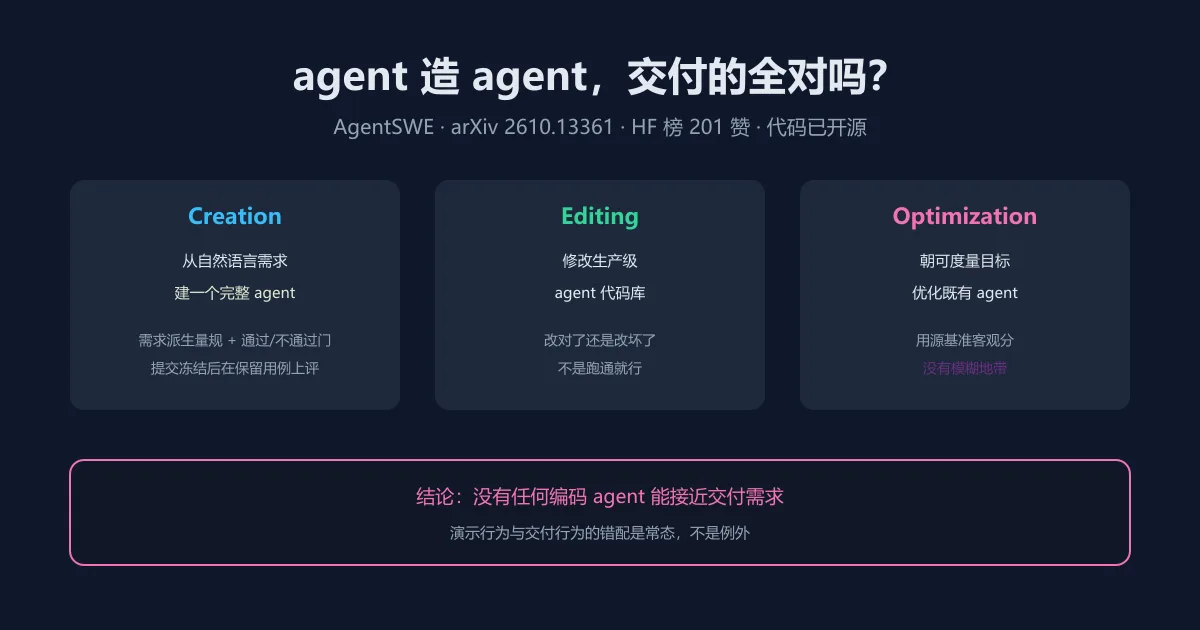
让编码 agent 按需求造另一个 agent,演示时看起来都挺好,冻结代码后拿保留用例一评就露馅。AgentSWE 基准覆盖建、改、优化三阶段,结论是没有任何模型接近交付需求,失败模式反复出现在三个坑里。
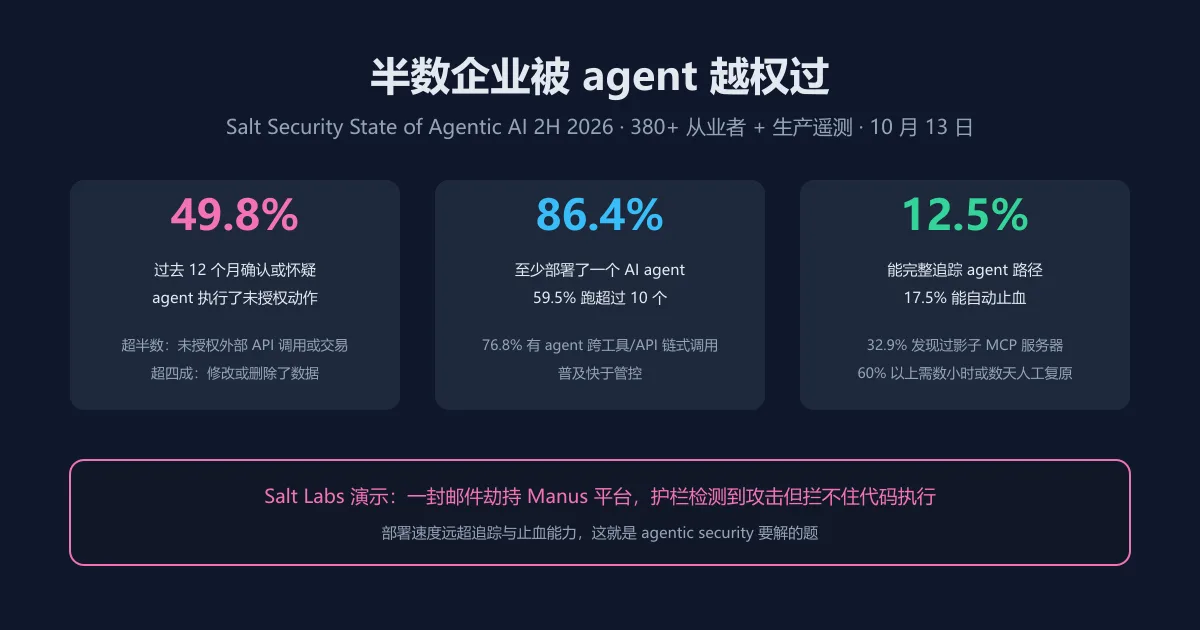
Salt Security 调查 380+ 从业者:49.8% 的企业确认或怀疑 agent 执行过未授权动作,超半数涉及未授权外部调用,超四成改删了数据;仅 12.5% 能完整追踪 agent 路径,17.5% 能自动止血。
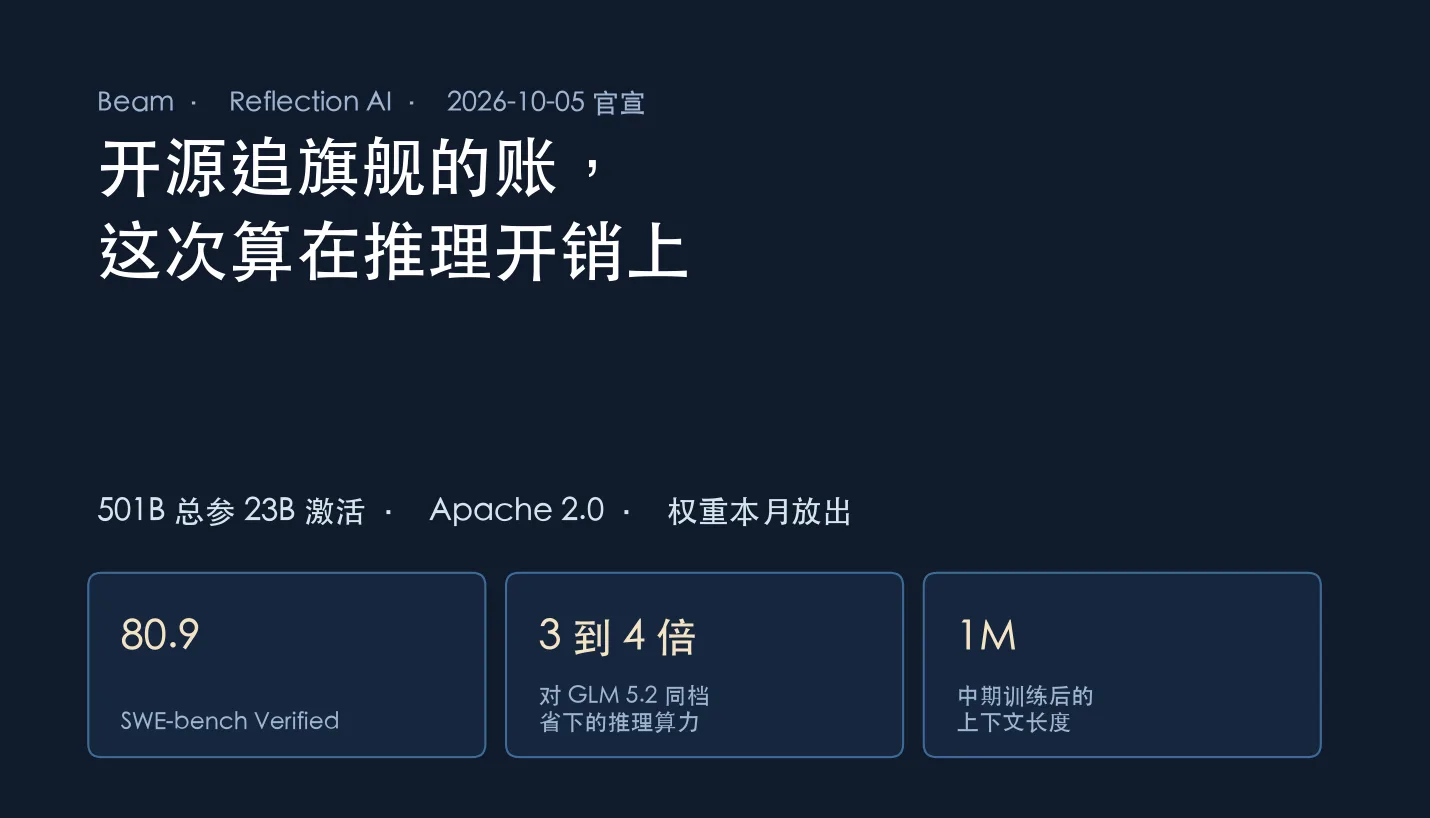
开权重模型追旗舰,Beam 换了个算法:501B 总参 23B 激活的稀疏专家,编码推理三线进第一梯队,同档任务对一款旗舰省 3 到 4 倍推理算力。权重本月按 Apache 2.0 放出,先走小范围 Early Access。
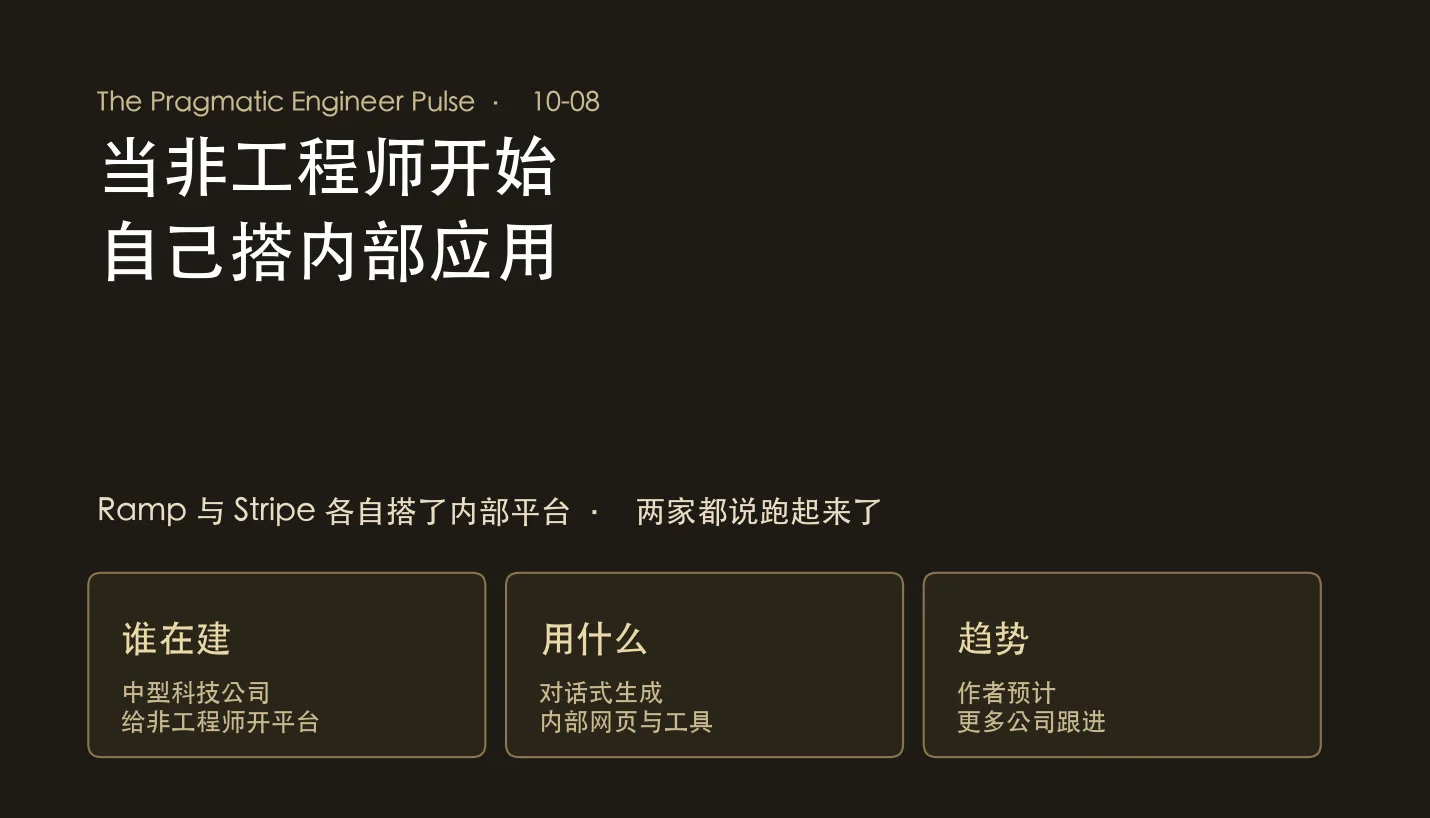
中型科技公司开始给非工程师搭内部平台,用对话生成内部网页和工具。报道点名 Ramp 和 Stripe 两家各建平台且都跑起来了,作者预计接下来会有更多公司跟进。
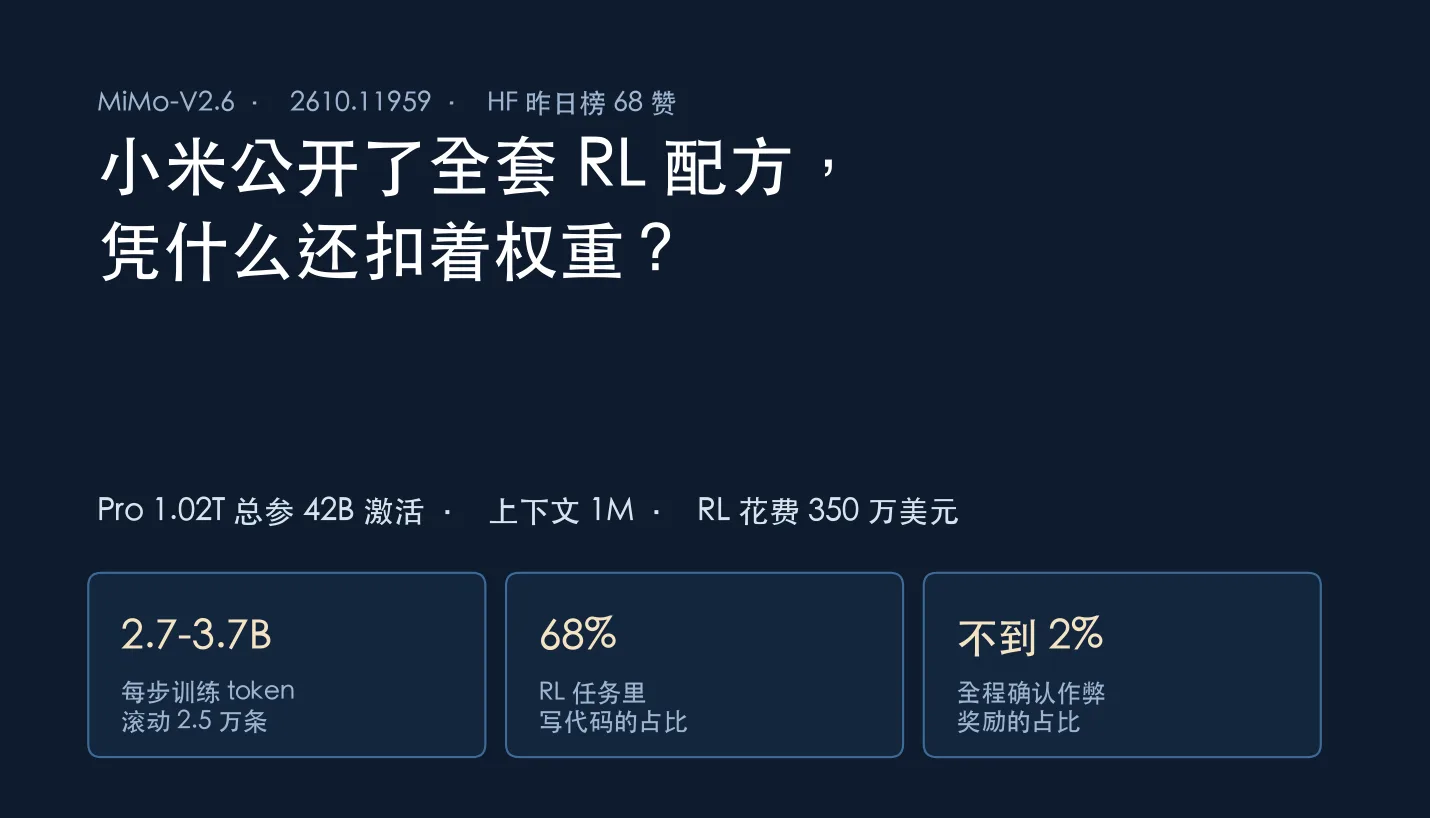
小米把 RL 后训练的账单、任务配比、防作弊机制全公开,环境和框架也一并开源,旗舰权重却没放。昨日榜单 68 赞还在升。配方公开与权重保留其实并不矛盾。
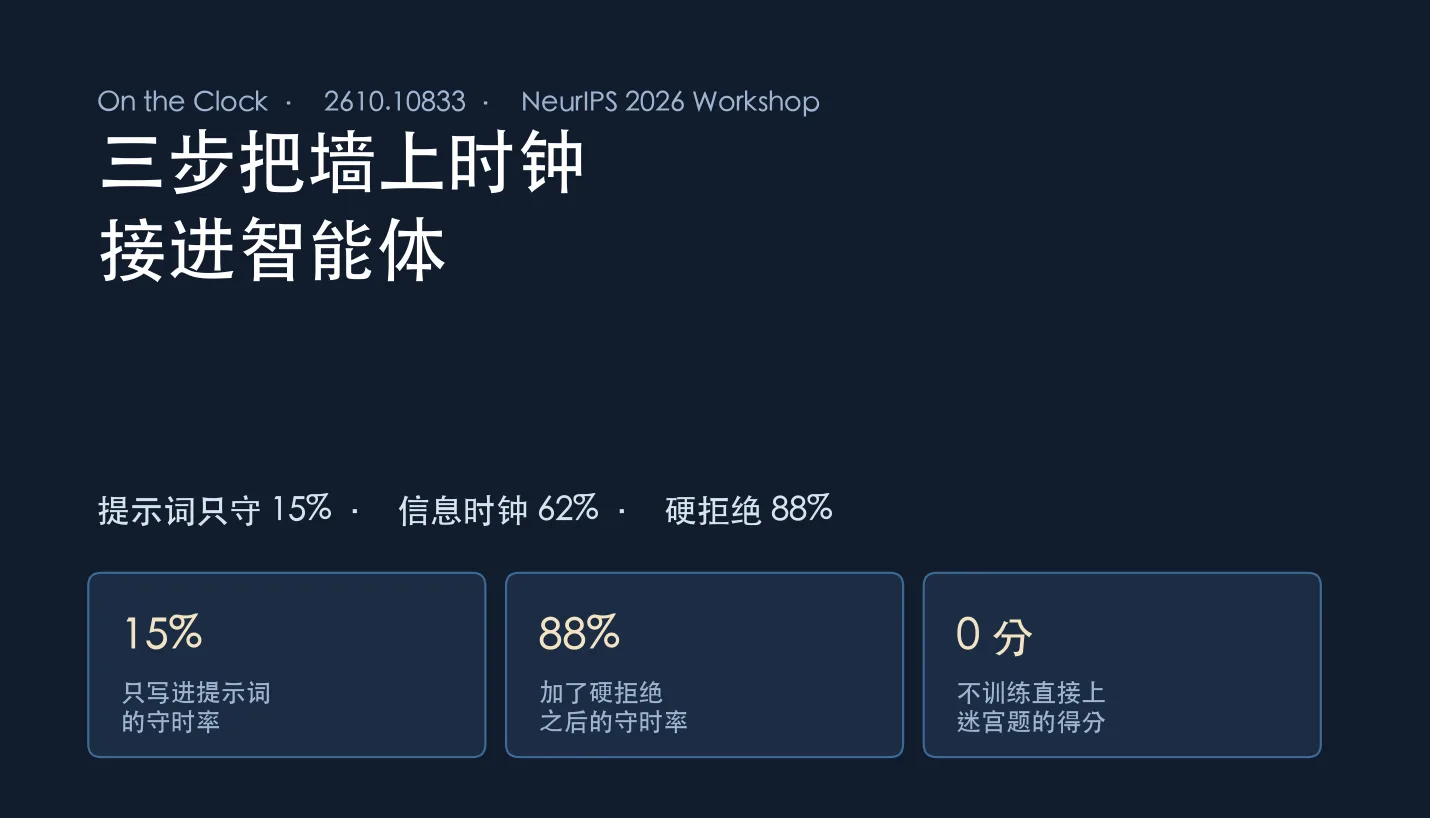
只把预算写进提示词,智能体的守时率只有 15%,平均超支六成。接上信息时钟再层层加码能爬到 88%,分数却纹丝不动。三步接法:给读数、给硬边界、再谈训练。
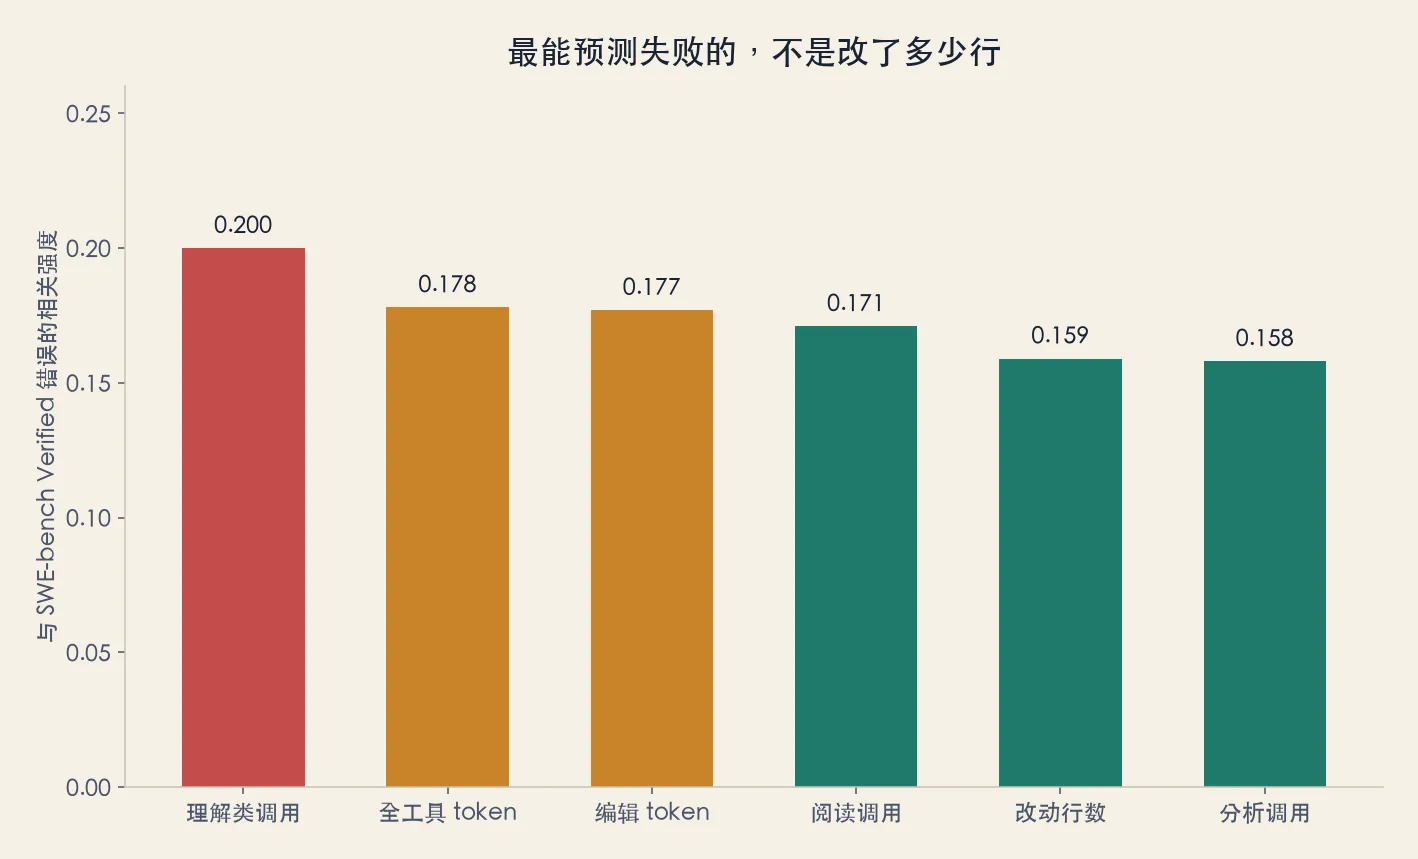
6840 道合成题上,模型越大越吃力,智能体靠工具几乎全对。可最预测真实基准失败的,是理解类调用次数,不是改动行数。代码理解才是编码智能体的瓶颈。
长会话还没到顶,硬截断就把前缀和旧观察砍掉。billion-context 让模型自己折成摘要,需要时再解压。研究口径 4.5 个月、17.4 万次调用,窗口违例是 0。先把代理接上再谈窗口。
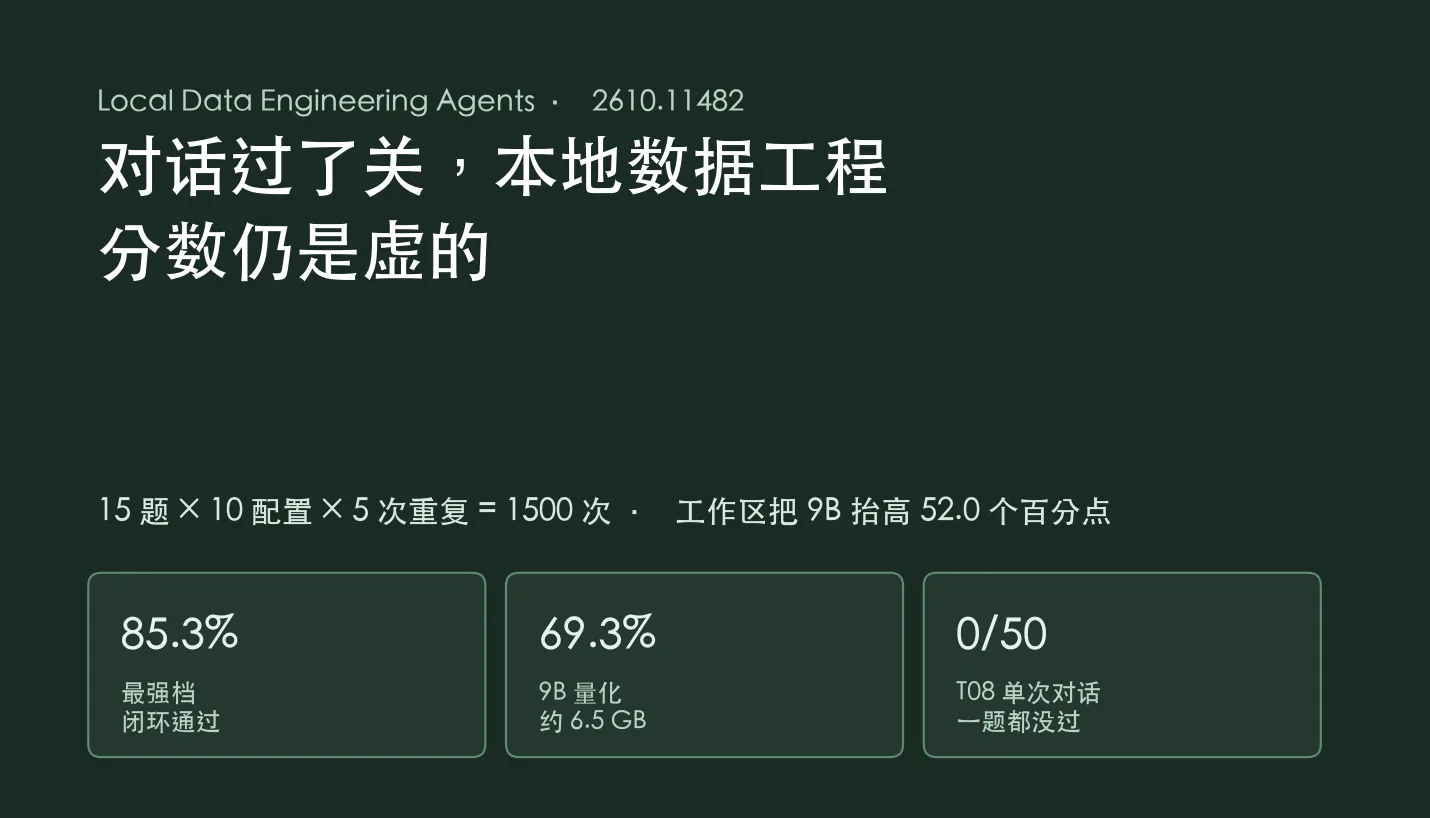
本地模型在对话框里答完出行数据工程题,分数仍可能是虚的。1500 次试验里,工作区把通过率抬高 26.7 到 52.0 个百分点。最强档闭环过 85.3%,量化 9B 过 69.3%。先看现场自检档。
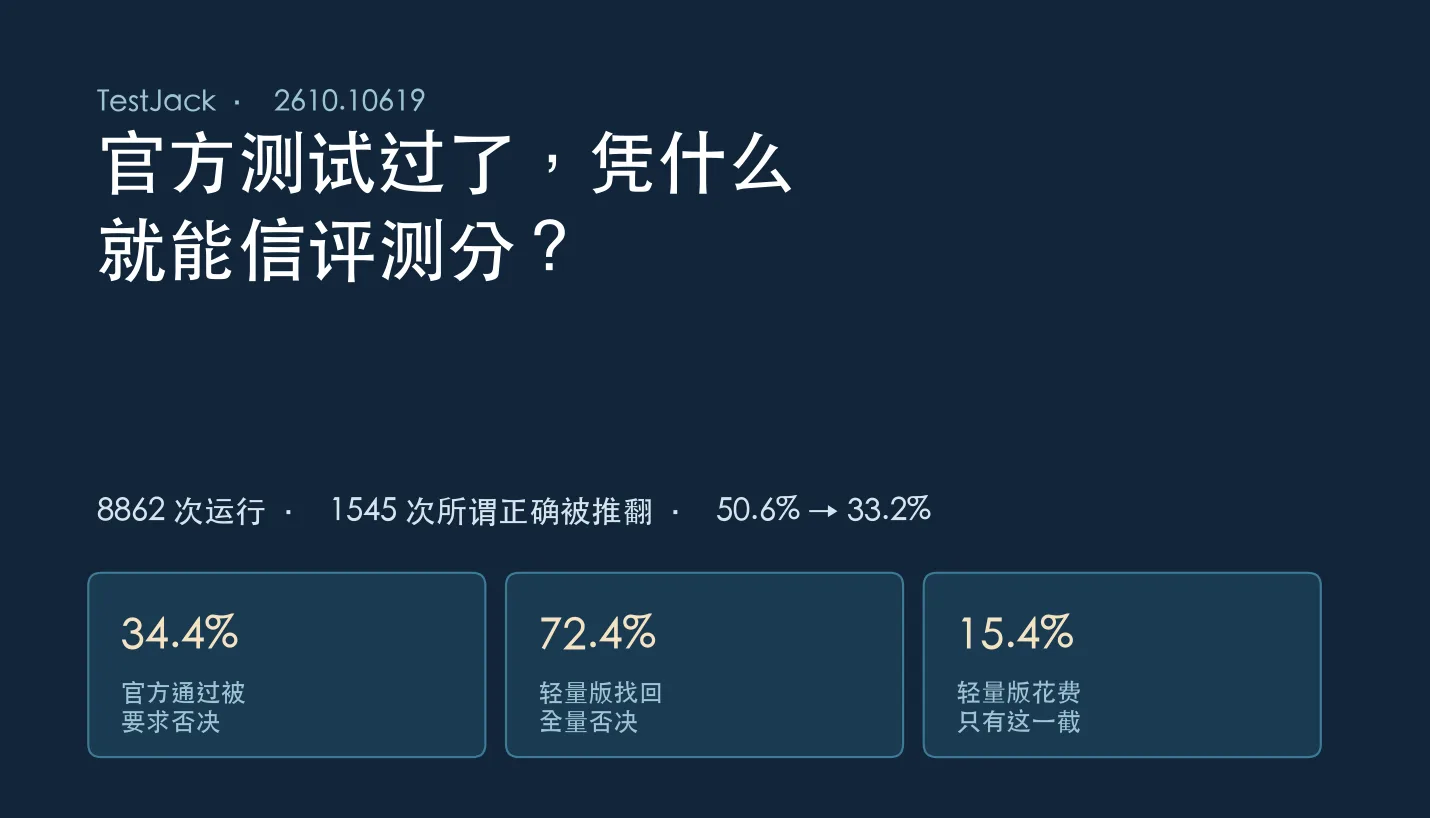
编码智能体把官方单测跑绿,评测单就会写成解决了。TestJack 在 8862 次运行里推翻 1545 次所谓正确,总解决率从 50.6% 掉到 33.2%。先问官方测试挡住了什么,再谈那条高分还在不在。
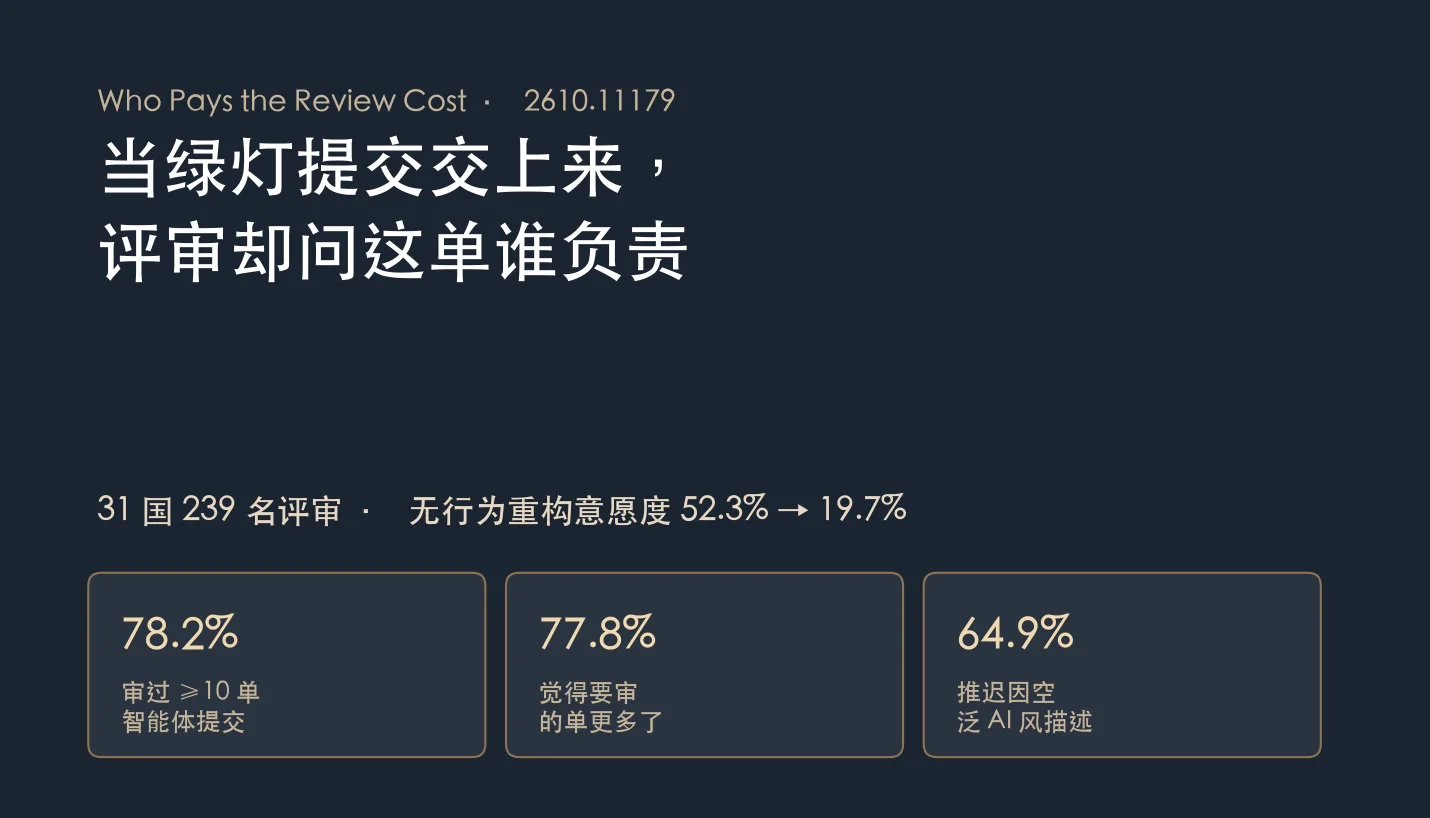
31 国 239 名评审里,持续集成已绿时无行为重构还愿往下看的人从 52.3% 掉到 19.7%。缺理由、验证和认领的时候,绿灯只证明构建过了,并不能证明这单真的有人在扛。
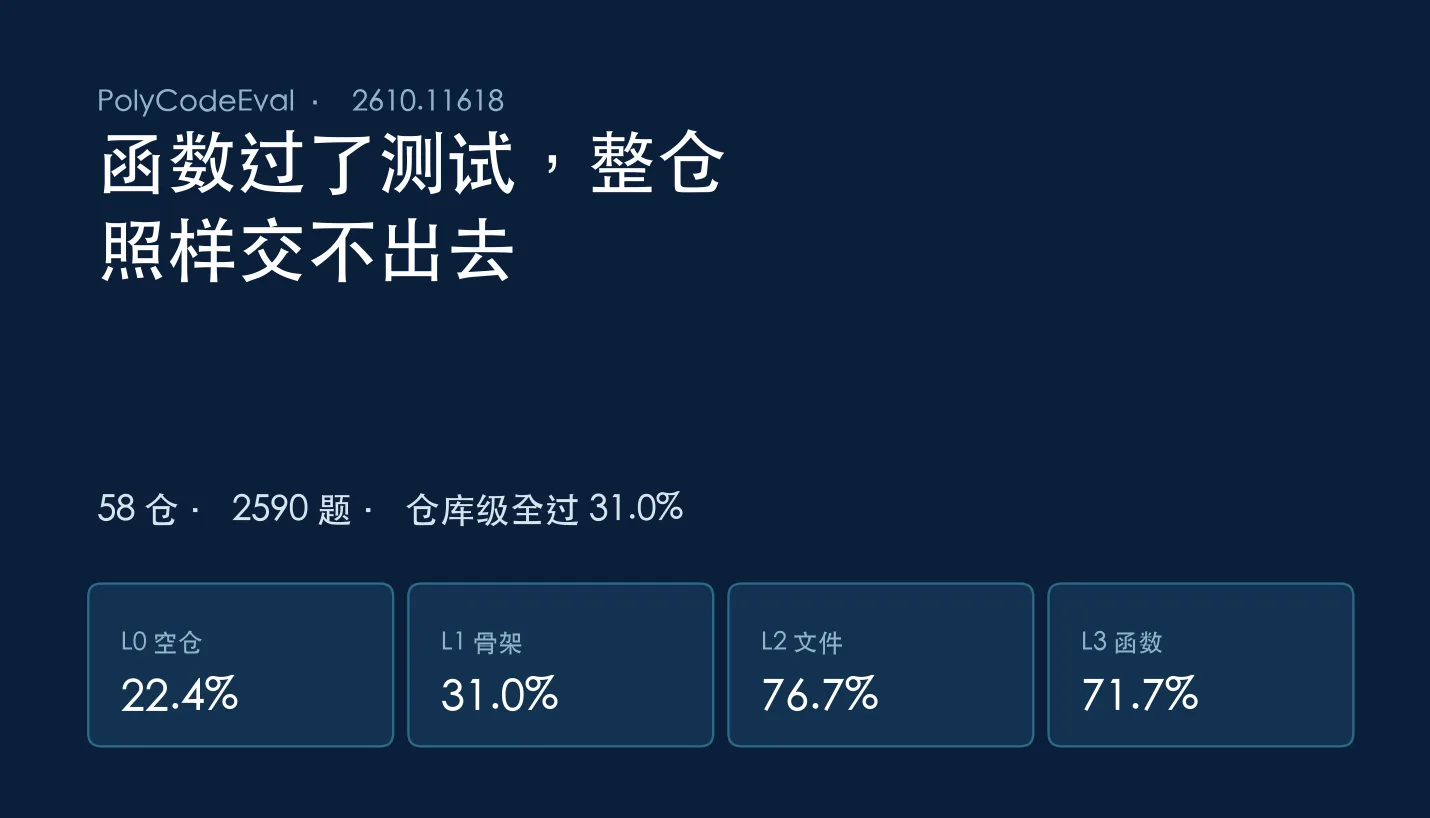
同一套可执行仓被拆成空仓、骨架、文件、函数四档。仓库级全过最高只有 31.0%,文件级能到 76.7%。函数绿了不等于整仓交得出去,评测单常把这个缺口悄悄抹平。