字节笔记本
2026年10月5日 · 约 14 分钟读完
别再收藏播客吃灰了:这个开源工具 30 秒把视频变成摘要
刷到一个两小时的播客,标题很吸引人,你点了收藏,心里说「回头听」。然后三个月过去了,它还躺在收藏夹里。
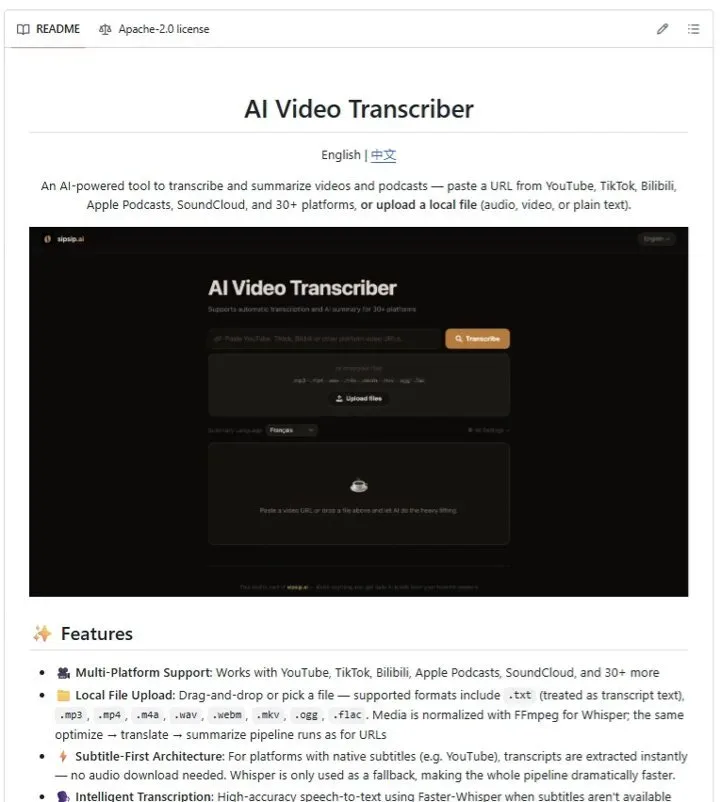
最近在 X 上走红的一个开源工具,专门治这个「收藏即吃灰」的毛病:粘个链接,30 秒读完摘要。YouTube、TikTok、Bilibili、Apple Podcasts、SoundCloud,30 多个平台都支持,代码 100% 开源,用 Apache-2.0 协议。
它叫 AI 视频转录器(AI-Video-Transcriber),今天就来拆一拆,看它怎么把「听不完的内容」变成「读得完的摘要」。
一、它解决什么问题
信息过载时代,最大的浪费不是「没好内容看」,而是「好内容看不过来」。
一个 90 分钟的播客访谈,真正有价值的观点可能就 5 到 10 分钟,但你得听完才知道是哪 5 分钟。视频和播客这类「线性时间媒体」的痛点就在这里:你必须按它的时间轴消费,没法像读文章那样跳读。
这个工具做的事,本质上是把时间线媒体转成文本媒体:
- 视频时长不等于阅读时长:90 分钟视频,先出全文转录,再出 5 分钟摘要
- 摘要可以扫读、跳读、Ctrl+F 搜索
- 想深入某一段,再回头看完整转录
它不是替代你看视频,而是给你一个「要不要花时间看完整版」的判断依据。
二、核心功能
1. 30+ 平台链接支持
粘个 URL 就行,支持的平台覆盖主流长短视频和音频:
- 视频:YouTube、Bilibili、抖音(TikTok)、Twitter/X 等
- 播客:Apple Podcasts、SoundCloud 等
- 本地上传:MP3、MP4、M4A、WAV、WebM、MKV、OGG、FLAC,甚至纯 .txt 文本
背后用的是 yt-dlp,一个开源的视频下载瑞士军刀,支持上千个站点。所以「30+ 平台」其实是 yt-dlp 能抓的站点子集。
2. 字幕优先架构(速度的关键)
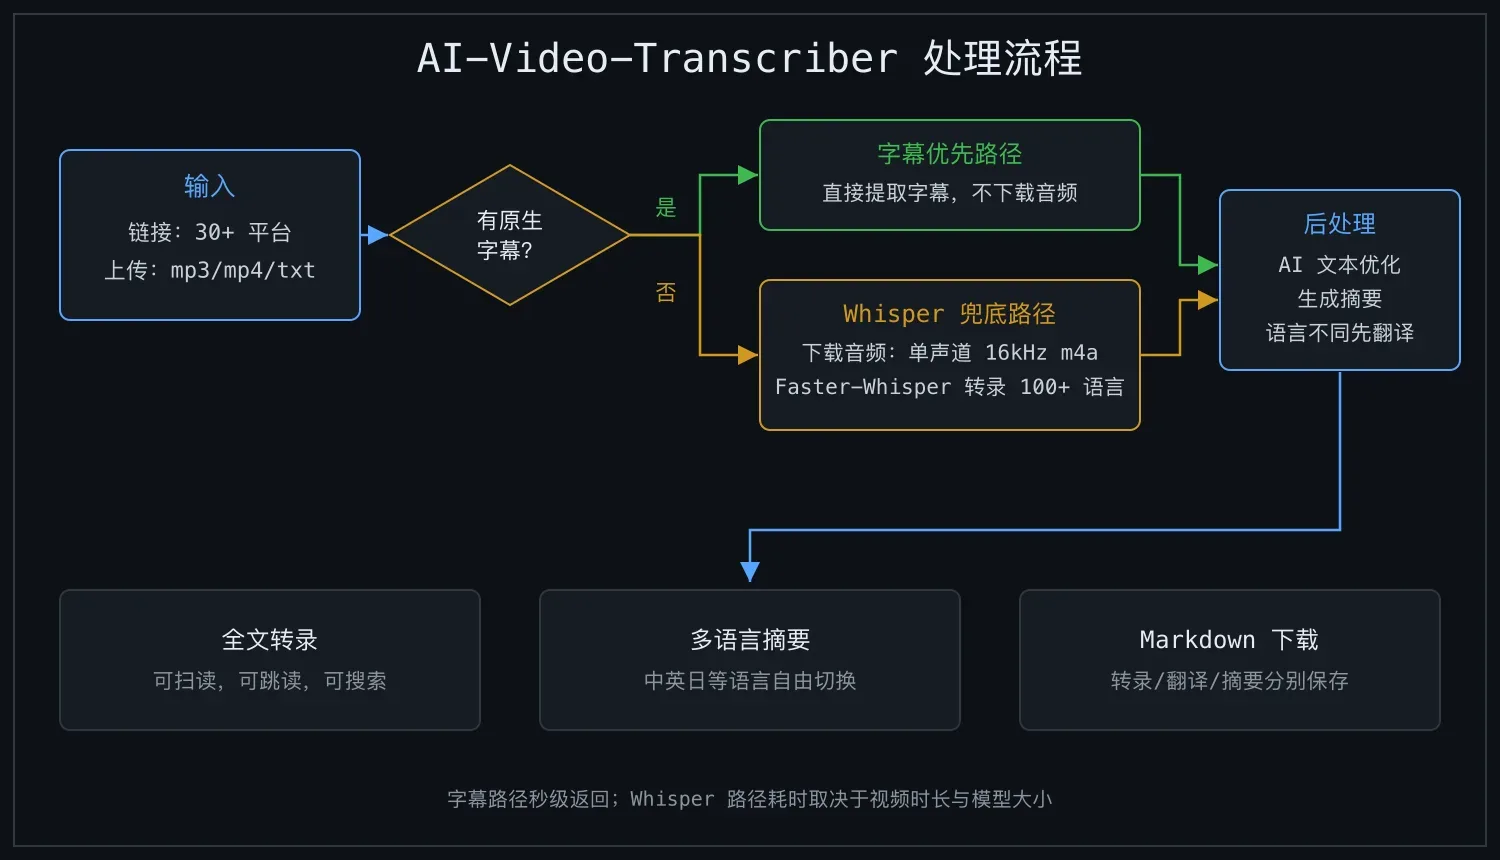
这是它 30 秒出摘要的秘密,逻辑分两条路:
- 有原生字幕的平台(如 YouTube):直接提取字幕文本,不下载音频,不跑语音识别,极快。带字幕的 YouTube 视频 10 秒内出结果。
- 没字幕:自动回退到 Faster-Whisper 做语音转文字。
能走捷径就走捷径,捷径走不了再上重型方案,这是典型的快速路径(fast path)工程哲学。
3. 100+ 语言转录
用 Faster-Whisper(Whisper 的高性能实现),支持 100+ 语言自动识别。你不用告诉它视频是什么语言,它自己判断。
4. 多语言摘要
摘要可以输出成不同语言:英文、中文、印地语、日语、西班牙语、法语等。当摘要语言和转录语言不一致时,自动加一步翻译。
这意味着你可以用中文读英文播客的摘要,或用英文读日语视频的总结,跨语言信息消费变得极其简单。
5. 自带模型(Bring Your Own Model)
这是最关键的设计:不锁定任何 AI 服务商。在 UI 里直接配任意 OpenAI 兼容接口:
- OpenAI 官方
- OpenRouter(聚合几百个模型)
- 本地 LLM(Ollama、LM Studio 等任何暴露 OpenAI 兼容 API 的)
- 国产模型:DeepSeek、通义千问、智谱 GLM
输入 API 地址和 Key,点 Fetch 自动拉取可用模型列表,选一个就用。你的 key 存你本地,不经过任何中间服务器。
6. AI 文本优化
转录完不直接用,还有一步清洗:自动修正错别字、补全残句、智能分段。这一步对口语化内容特别有用,因为人说话常有重复、口误、半句话。
三、技术架构:四个核心模块
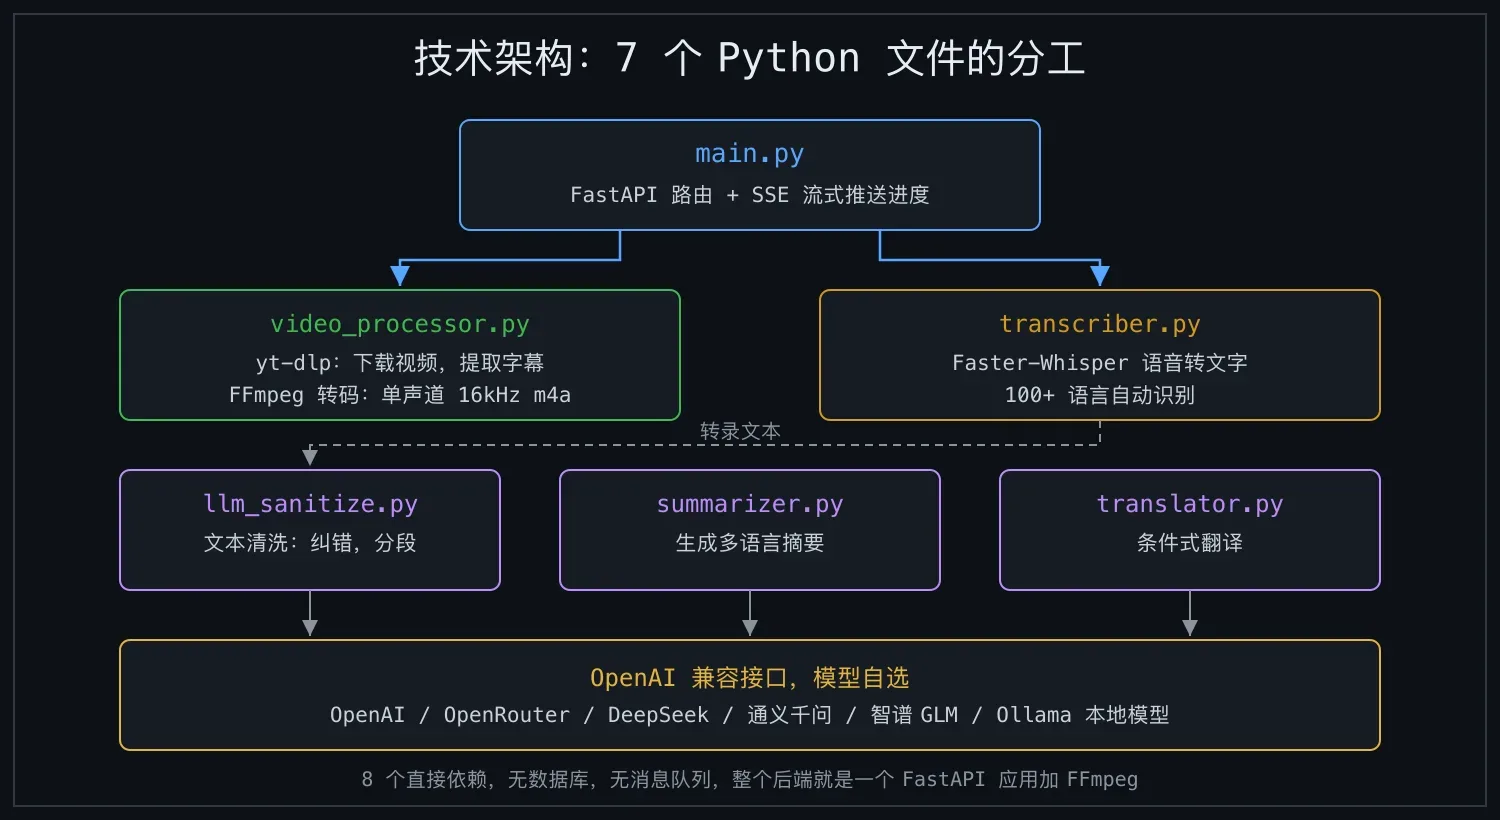
backend/ 目录只有 7 个 Python 文件,分工清晰:
| 文件 | 职责 | 用的库 |
|---|---|---|
video_processor.py | 下载视频/提取字幕/转码音频 | yt-dlp + FFmpeg |
transcriber.py | 语音转文字 | Faster-Whisper |
llm_sanitize.py | 文本清洗(错别字/分段) | OpenAI 兼容 API |
summarizer.py | 生成摘要 | OpenAI 兼容 API |
translator.py | 跨语言翻译 | OpenAI 兼容 API |
main.py | FastAPI 路由 + SSE 流式返回 | FastAPI + Uvicorn |
__init__.py | 包初始化 | 无 |
整套依赖极轻,只有 8 个直接依赖:
fastapi        # Web 框架
uvicorn        # ASGI 服务器
yt-dlp         # 视频下载/字幕提取
faster-whisper # 语音转文字
openai         # LLM 调用(兼容接口)
pydantic       # 数据校验
aiofiles       # 异步文件
python-multipart  # 文件上传
没有数据库、没有前端框架(纯静态 HTML/JS)、没有消息队列,整个工具就是一个 FastAPI 应用加 FFmpeg。这种「极简但够用」的依赖,让它很容易部署:本地、Docker、VPS 都行。
流式返回(SSE)
长视频转录时,用 SSE(Server-Sent Events)流式推送进度,浏览器实时看到「正在下载、正在转录、正在生成摘要」。README 特别提醒:处理 30 到 60 分钟的长视频时,用 --prod 模式启动(禁用热重载),避免 SSE 连接断开。这是个实打实的生产经验。
四、两种下载策略的权衡
video_processor.py 里有个值得说的设计,它对「只要音频」和「要字幕」用不同的 yt-dlp 选项。
字幕优先路径(快):
1. 先探测视频有没有原生字幕
2. 有:直接提取字幕文本,完全不下载音频
3. 10 秒内拿到全文
Whisper 兜底路径(慢但通用):
1. 探测发现没字幕
2. 下载音频,转成单声道 16kHz AAC m4a(Faster-Whisper 最爱的格式)
3. 跑 Whisper 语音识别,耗时取决于视频时长加模型大小
4. 拿到全文
这个「先试捷径再上重武器」的策略,跟软件工程里的快速路径优化(fast path optimization)是同一个道理:绝大多数 YouTube 视频有字幕,走捷径能省下 95% 的时间;少数没字幕的,才动用算力。
五、怎么装
三种方式,按你的技术背景选。
方式一:自动安装(最简单)
git clone https://github.com/wendy7756/AI-Video-Transcriber.git
cd AI-Video-Transcriber
chmod +x install.sh
./install.sh
方式二:Docker(推荐给不想折腾环境的人)
git clone https://github.com/wendy7756/AI-Video-Transcriber.git
cd AI-Video-Transcriber
cp .env.example .env
# 编辑 .env 填 API key(可选,也能在 UI 里配)
docker-compose up -d
镜像基于 Python 3.12(Debian Bookworm),docker-compose.yml 里限制了 2GB 内存上限,对 Whisper base 模型够用。
方式三:手动(开发者)
python3 -m venv venv
source venv/bin/activate
pip install -r requirements.txt
brew install ffmpeg          # macOS
python3 start.py
启动后访问 http://localhost:8000 。处理长视频记得加 --prod 参数:
python3 start.py --prod然后打开 UI,点 AI Settings,填入你的 OpenAI 兼容 API 地址和 Key,点 Fetch 选模型,就能用了。
六、几个实用技巧
1. 用便宜的模型做摘要
摘要不需要顶级模型。用 OpenRouter 接个免费的 Llama,或者用 DeepSeek、通义千问的廉价 API,成本几乎为零。转录是本地 Whisper 跑的(免费),只有摘要花 API 钱。
2. Whisper 模型大小怎么选
.env 里的 WHISPER_MODEL_SIZE:
tiny/base:快,英文还行,中文和小语种一般small/medium:精度高很多,但慢、吃内存large:最准,但没好显卡别用
日常用 base 够了,重要内容上 small。
3. 反向代理只放上传路径
README 提到,上传和链接处理共用 POST /api/process-video(multipart 带 file 字段)。如果你想公开部署但只允许上传、不允许任意 URL 抓取,反向代理只放行这个路径就行。这是个安全意识上的细节。
4. 本地文件也能处理
不只能粘链接,拖个本地音频/视频文件进去也行。甚至 .txt 文本也能直接走后续的「清洗、摘要」管线,等于它也能当长文本摘要工具用。
七、和同类工具的对比
| AI-Video-Transcriber | 闭源 SaaS(如 Summarize.tech) | 纯 Whisper + 脚本 | |
|---|---|---|---|
| 价格 | 免费(自付 API) | 订阅制 | 免费 |
| 平台 | 30+ | 通常只 YouTube | 看你下载能力 |
| 隐私 | key 存本地,数据不过第三方 | 数据上传到人家服务器 | 完全本地 |
| 可定制 | 换模型/换 prompt/改代码 | 不能 | 全靠自己写 |
| 易用性 | 有 UI,点点就行 | 最易用 | 命令行 |
| 多语言 | 100+ 转录,多语言摘要 | 看服务商 | 看 Whisper |
它的甜蜜点是:开源、有 UI、平台广、自带模型。比 SaaS 隐私好、可定制;比纯脚本易用、平台广。
八、谁该用
强烈推荐,如果:
- 你收藏了一堆「以后看」的播客和视频,从来没看
- 你做内容研究,需要快速判断一个长视频值不值得细看
- 你跨语言消费内容(看英文播客、日文视频)
- 你在意隐私,key 和数据都要在自己手里
- 你是开发者,想改造成自己的工作流(比如批处理、接 RAG)
不太适合:
- 想要「零配置即用」的人:毕竟要装 Python、FFmpeg,配 API key
- 需要极高精度转录的正式场合(医疗、法律):Whisper 仍会出错,要人工校对
- 实时转录需求:它是「事后处理」,不是「边说边转」
九、它背后的趋势
这个工具其实踩中了几个同时发生的趋势。
1. 富媒体转文本的工业化
从 Agent 把视频「读」成文本喂给模型,到这个工具把视频和播客转成转录加摘要给人读,方向是同一个:把时间线媒体降维成文本,因为文本是最通用、最高效的信息载体。
2. 「自带模型」成为标配
不锁定服务商、UI 里直接配 OpenAI 兼容接口,这已经是 2026 年开源 AI 工具的标准设计,翻译工具、剪辑工具、视频理解工具都在这么做。厂商锁定的时代在结束。
3. yt-dlp 成为事实基础设施
「30+ 平台」的背后是 yt-dlp。这个开源项目默默支撑了无数视频工具,没有它,这类「粘链接就处理」的工具几乎都做不出来。
十、小结
一句话:一个极简但够用的开源工具,粘链接,30 秒把视频和播客变成可读的摘要。字幕优先架构让它快,自带模型让它自由,Apache-2.0 协议让它属于你。
它不复杂:FastAPI、yt-dlp、Whisper、OpenAI 兼容 API,7 个 Python 文件。但正是这种「把对的技术组合在一起,解决一个真实痛点」的简洁,让它好用。
那个「三个月前收藏的播客」,现在终于可以 30 秒读完了。
本文基于 AI-Video-Transcriber 仓库(https://github.com/wendy7756/AI-Video-Transcriber )整理,Apache-2.0 协议,依赖 FFmpeg 加可选的 OpenAI 兼容 API。文中流程图与架构图依据仓库源码绘制。