字节笔记本
2026年10月6日 · 约 52 分钟读完
AI 工作流专栏 26:从 0 搭建企业级 AI 知识库
本文是「AI 工作流专栏」的综合实战篇。前面各章已经分别讲完全栈基础、数据库与缓存、Docker 部署、Prompt 工程、多模型接入、流式输出、RAG 检索、多步编排与人机协同、可观测性、护栏与成本治理这些拼图,这一章把它们组装成一个完整的项目:一个可以放进简历、也可以真正给企业用的 AI 知识库问答系统。这一章不引入新知识点,只讲怎么把已有的知识组装成产品。
读完本章你将得到:
- 一个完整 AI 产品的从 0 到 1 设计流程
- 需求拆解、架构设计、模块实现到部署上线的全链路演练
- 检索、生成、护栏、可观测等技能点到真实功能的映射方法
- 这个项目怎么写进简历、怎么在面试中讲解
一、项目背景与目标
1.1 我们要做什么?
做一个企业内部 AI 知识库问答系统,场景是:
员工上传公司文档(规章制度、产品手册、技术文档、FAQ),系统自动建立知识库;员工用自然语言提问,AI 基于文档给出有据可依、可溯源的答案;高风险问题(比如涉及 HR 政策)走人工审核。
这是企业落地 AI 最高频、最通用的场景,几乎每家公司都需要,也是招聘 JD 里「RAG 检索增强系统」最典型的落地形态。
1.2 为什么选这个项目?
因为它正好覆盖 JD 的所有核心要求:
| JD 要求 | 本项目对应 |
|---|---|
| 全栈开发(React + 后端 + DB) | 前端问答界面 + FastAPI 后端 + PostgreSQL |
| RAG 检索增强 | 文档解析 → 向量化 → 检索 → 生成 |
| Agent 编排 | 高风险问题转人工审核的 HITL 流程 |
| 向量数据库 | pgvector |
| 大模型集成 | DeepSeek / GPT-4o 多模型切换 |
| 流式输出 | SSE 流式回答 |
| 工作流可观测 | Langfuse 追踪 + Prometheus 监控 |
| 安全护栏 | 输入/输出过滤 + PII 脱敏 |
| 成本治理 | 模型路由 + 语义缓存 |
| Docker / CI/CD | 容器化 + GitHub Actions |
这一个项目等于一份完整的简历作品集,面试官能从这一个项目问出你 80% 的能力。
1.3 分三个阶段做
为了避免被复杂度吓到,把项目拆成三个阶段:
- MVP(最小可用版):能上传文档、能问答,核心闭环跑通(本章重点)
- 增强版:加流式、多模型、护栏、HITL,能进生产
- 运营版:加监控、评估、成本治理,能长期跑
本章主要带你做 MVP 和关键增强,运营版给出实现思路。
二、架构设计
2.1 全景架构
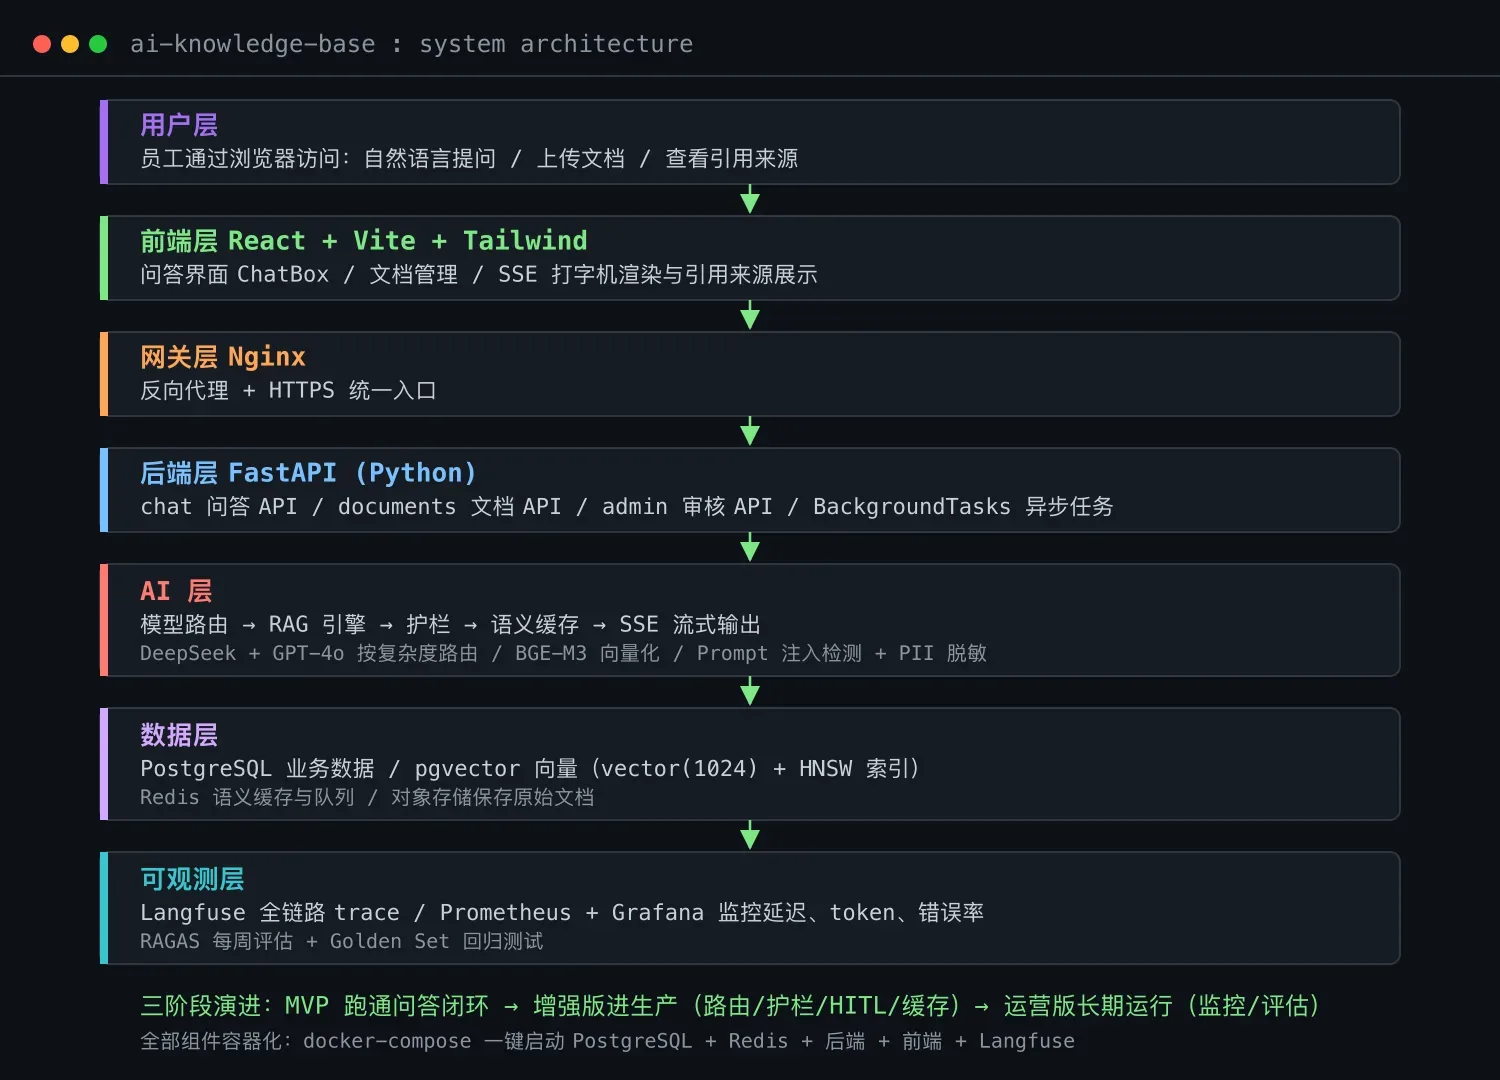
系统按七层组织,从上到下依次是:用户层(员工通过浏览器访问)、前端层(React + Vite + Tailwind,提供问答界面和知识库管理)、网关层(Nginx 反向代理 + HTTPS)、后端层(FastAPI,承载问答 API、文档管理 API、HITL 审核 API)、AI 层(模型路由 → RAG 引擎 → 护栏 → 语义缓存 → SSE 流式输出)、数据层(PostgreSQL 业务数据 + pgvector 向量 + Redis 缓存与队列 + 对象存储原始文档)、可观测层(Langfuse 全链路 trace + Prometheus + Grafana)。
2.2 技术选型清单
| 层 | 技术 | 为什么选 |
|---|---|---|
| 前端 | React + Vite + Tailwind | 主流、轻量、AI 工具友好 |
| 后端 | FastAPI (Python) | AI 生态原生、自动文档 |
| 业务数据库 | PostgreSQL | 和向量库统一、稳定 |
| 向量库 | pgvector | 长在 PG 上、统一管理 |
| 缓存 | Redis | 语义缓存、限流 |
| 文档解析 | pdfplumber + python-docx | 覆盖主流格式 |
| Embedding | BGE-M3(本地)或 text-embedding-3 | 中文友好 / API 便捷 |
| LLM | DeepSeek + GPT-4o(路由) | 省钱 + 兜底 |
| 框架 | LangChain(轻量用)+ 自研 | 平衡封装与可控 |
| 护栏 | 自研(moderation + 规则) | 简单可控 |
| 监控 | Langfuse + Prometheus | AI 原生 + 传统指标 |
| 评估 | RAGAS + Golden Set | 量化质量 |
| 部署 | Docker + docker-compose | 一致环境 |
2.3 项目目录结构
ai-knowledge-base/
├── frontend/              # React 前端
│   ├── src/
│   │   ├── App.jsx
│   │   ├── components/    # ChatBox, DocUploader
│   │   └── api/           # 调后端
│   └── package.json
├── backend/               # FastAPI 后端
│   ├── app/
│   │   ├── main.py        # 入口
│   │   ├── routers/       # chat / documents / admin
│   │   ├── rag/           # RAG 核心
│   │   ├── llm/           # 模型路由
│   │   ├── guardrails/    # 护栏
│   │   └── config.py
│   └── requirements.txt
├── docker-compose.yml
└── README.md
三、MVP 实现:核心问答闭环
先把「上传文档 → 提问 → 得到答案」这条核心链路打通。
3.1 数据库设计
-- 启用 pgvector 扩展
CREATE EXTENSION IF NOT EXISTS vector;

-- 文档表
CREATE TABLE documents (
    id SERIAL PRIMARY KEY,
    title VARCHAR(200) NOT NULL,
    source_type VARCHAR(20),         -- pdf / docx / md / url
    file_path VARCHAR(500),          -- 对象存储路径
    content TEXT,                    -- 全文
    chunk_count INTEGER DEFAULT 0,
    created_at TIMESTAMP DEFAULT NOW()
);

-- 文档切片表(带向量)
CREATE TABLE document_chunks (
    id SERIAL PRIMARY KEY,
    document_id INTEGER REFERENCES documents(id) ON DELETE CASCADE,
    chunk_index INTEGER,
    content TEXT NOT NULL,
    embedding vector(1024),          -- BGE-M3 是 1024 维
    created_at TIMESTAMP DEFAULT NOW()
);

-- 对话历史表
CREATE TABLE chat_sessions (
    id SERIAL PRIMARY KEY,
    user_id VARCHAR(50),
    title VARCHAR(200),
    created_at TIMESTAMP DEFAULT NOW()
);

CREATE TABLE chat_messages (
    id SERIAL PRIMARY KEY,
    session_id INTEGER REFERENCES chat_sessions(id) ON DELETE CASCADE,
    role VARCHAR(20),                -- user / assistant
    content TEXT,
    sources JSONB,                   -- 引用的文档片段 id
    tokens_used INTEGER,
    cost DECIMAL(10,4),
    created_at TIMESTAMP DEFAULT NOW()
);
设计要点:
documents存原始文档元信息document_chunks存切片和向量(一对多)chat_messages存对话历史和成本,供后续监控与成本统计使用- 向量字段用
vector(1024)(BGE-M3 是 1024 维),配套建 HNSW 索引:
CREATE INDEX idx_chunks_embedding ON document_chunks
USING hnsw (embedding vector_cosine_ops);
3.2 后端:文档上传与处理
# backend/app/routers/documents.py
from fastapi import APIRouter, UploadFile, File, BackgroundTasks
from typing import List
import os, uuid

router = APIRouter(prefix="/api/documents", tags=["documents"])

@router.post("/upload")
async def upload_docs(
    background_tasks: BackgroundTasks,
    files: List[UploadFile] = File(...),
):
    """上传文档,异步处理(解析→切片→向量化→入库)"""
    doc_ids = []
    for f in files:
        # 1. 保存到对象存储(这里简化为本地)
        file_id = str(uuid.uuid4())
        path = f"./storage/{file_id}_{f.filename}"
        with open(path, "wb") as out:
            out.write(await f.read())

        # 2. 写入 documents 表
        doc_id = await db.execute(
            "INSERT INTO documents (title, source_type, file_path) VALUES ($1,$2,$3) RETURNING id",
            f.filename, f.filename.split(".")[-1], path
        )
        doc_ids.append(doc_id)

        # 3. 异步处理(不阻塞上传响应)
        background_tasks.add_task(process_document, doc_id, path)

    return {"doc_ids": doc_ids, "status": "processing"}
文档处理是一条标准的 RAG 工程流水线:解析、切片、向量化、入库。
# backend/app/rag/pipeline.py
import pdfplumber
from langchain.text_splitter import RecursiveCharacterTextSplitter
from sentence_transformers import SentenceTransformer
import numpy as np

# 加载本地 BGE-M3 模型
embedder = SentenceTransformer("BAAI/bge-m3")

splitter = RecursiveCharacterTextSplitter(
    chunk_size=500,
    chunk_overlap=80,
    separators=["\n\n", "\n", "。", "!", "?", ".", " "]
)

async def process_document(doc_id: int, file_path: str):
    """完整流水线:解析 → 切片 → 向量化 → 入库"""
    # 1. 解析
    text = parse_file(file_path)       # PDF/Word/Markdown 各自的解析器

    # 2. 切片
    chunks = splitter.split_text(text)

    # 3. 向量化(批量)
    embeddings = embedder.encode(chunks, normalize_embeddings=True)

    # 4. 入库
    for i, (chunk, emb) in enumerate(zip(chunks, embeddings)):
        await db.execute(
            """INSERT INTO document_chunks (document_id, chunk_index, content, embedding)
               VALUES ($1, $2, $3, $4)""",
            doc_id, i, chunk, emb.tolist()
        )

    # 更新文档状态
    await db.execute(
        "UPDATE documents SET chunk_count=$1, content=$2 WHERE id=$3",
        len(chunks), text, doc_id
    )

def parse_file(path: str) -> str:
    """按文件类型解析"""
    if path.endswith(".pdf"):
        with pdfplumber.open(path) as pdf:
            return "\n\n".join(p.extract_text() or "" for p in pdf.pages)
    elif path.endswith(".docx"):
        from docx import Document
        return "\n".join(p.text for p in Document(path).paragraphs)
    elif path.endswith(".md"):
        with open(path) as f:
            return f.read()
    else:
        raise ValueError(f"Unsupported file type: {path}")
3.3 后端:问答接口(RAG 核心)
这是整个系统的心脏,把向量检索和流式生成串成一条链路:
# backend/app/routers/chat.py
from fastapi import APIRouter
from fastapi.responses import StreamingResponse
from openai import OpenAI
import os, asyncio

router = APIRouter(prefix="/api/chat", tags=["chat"])
client = OpenAI(api_key=os.getenv("DEEPSEEK_API_KEY"),
                base_url="https://api.deepseek.com")

@router.post("/ask")
async def ask(req: AskRequest):
    """用户提问,返回流式答案:向量化 + 检索 + LLM 流式生成"""
    # 1. 把问题向量化
    q_emb = embedder.encode([req.question], normalize_embeddings=True)[0]

    # 2. 向量检索 top-5
    results = await db.fetch("""
        SELECT content, document_id, 1 - (embedding <=> $1) AS score
        FROM document_chunks
        ORDER BY embedding <=> $1
        LIMIT 5
    """, q_emb.tolist())

    # 过滤低分的
    results = [r for r in results if r["score"] > 0.5]

    if not results:
        return {"answer": "知识库中未找到相关内容,请补充文档或换个问法。"}

    # 3. 拼 Prompt
    context = "\n\n".join(f"[{i+1}] {r['content']}"
                          for i, r in enumerate(results))
    sources = [{"doc_id": r["document_id"], "score": r["score"]}
               for r in results]

    prompt = f"""你是企业知识库助手。请根据【参考资料】回答问题。

【参考资料】
{context}

【规则】
1. 只基于参考资料作答,不要编造
2. 句末标注引用编号,例如 [1]
3. 资料不足时明确说"资料中未提及"
4. 回答简洁专业

【问题】{req.question}
"""

    # 4. 调 LLM 流式生成
    async def stream():
        full = ""
        stream = client.chat.completions.create(
            model="deepseek-chat",
            messages=[{"role": "user", "content": prompt}],
            stream=True,
        )
        for chunk in stream:
            delta = chunk.choices[0].delta.content or ""
            if delta:
                full += delta
                yield f"data: {delta}\n\n"   # SSE 格式
        # 最后发一个来源信息
        yield f"data: __SOURCES__:{sources}\n\n"

        # 异步存对话历史(监控与成本统计用)
        await save_message(req.session_id, "user", req.question)
        await save_message(req.session_id, "assistant", full, sources)

    return StreamingResponse(stream(), media_type="text/event-stream")
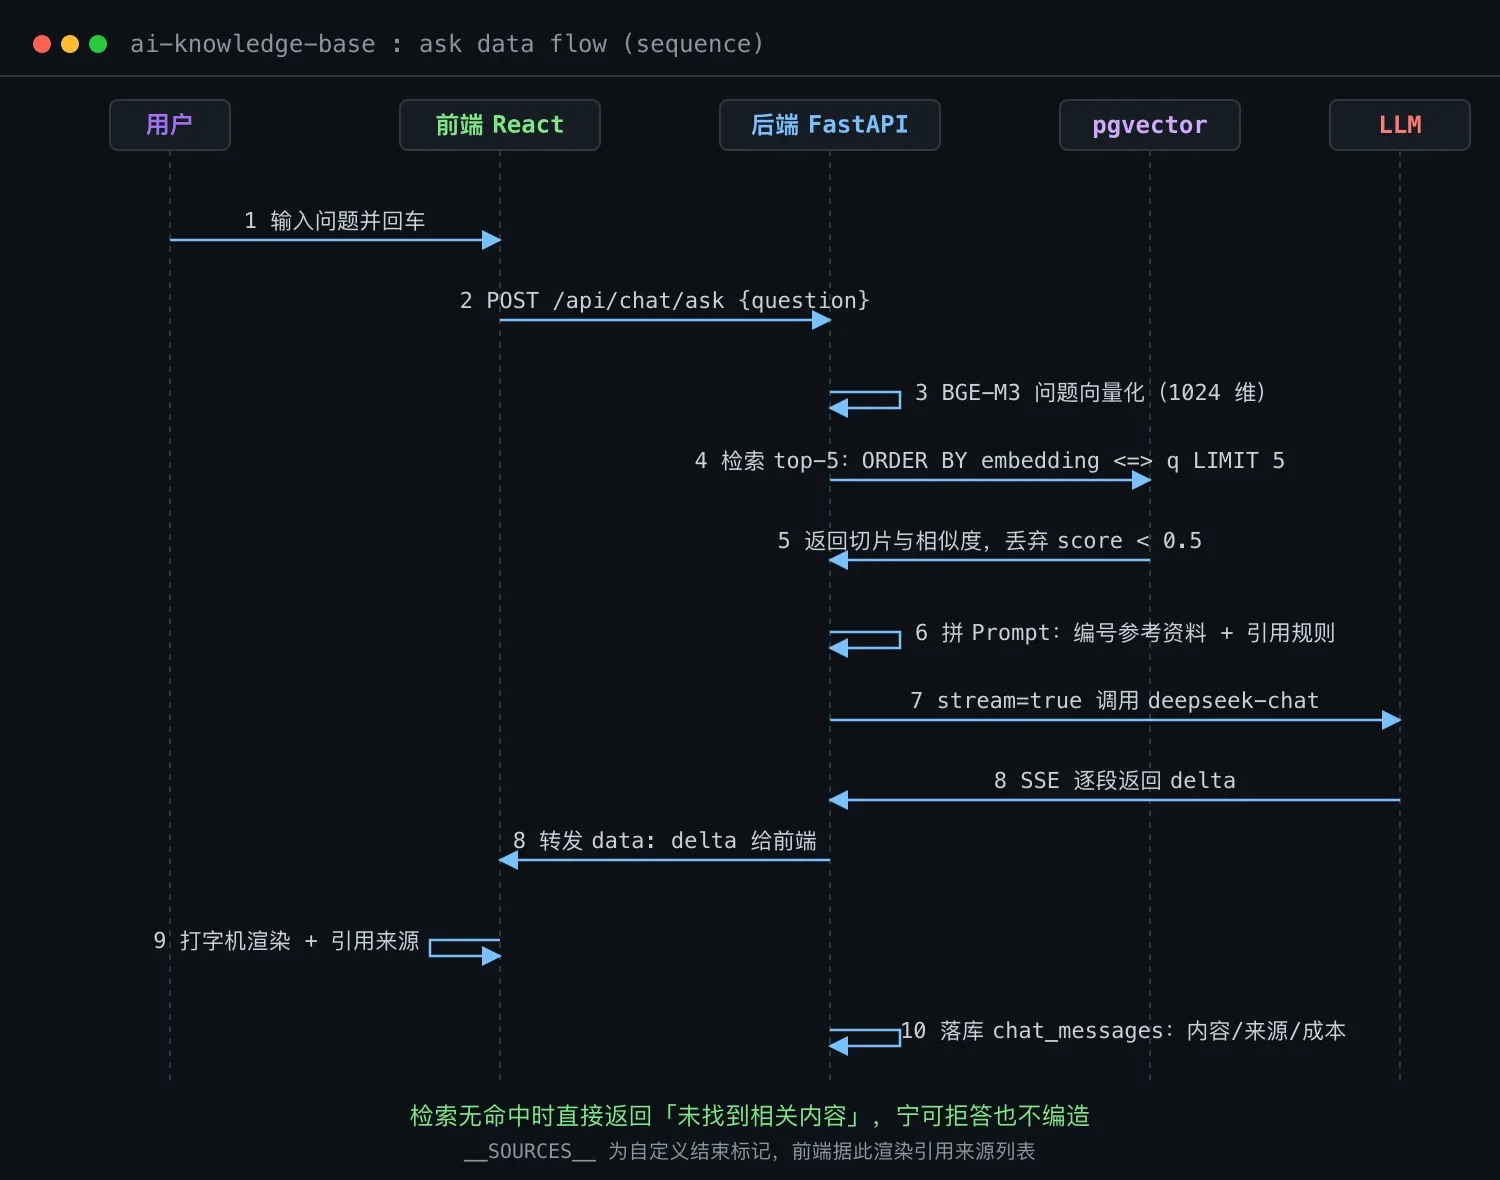
处理顺序值得注意:先把问题向量化,再去 pgvector 里按余弦距离检索 top-5,过滤掉相似度低于 0.5 的切片;如果一条都不剩,直接返回「知识库中未找到相关内容」,宁可拒答也不编造。命中则把切片编号后拼进 Prompt,并要求模型句末标注引用编号,答案因此可溯源。
3.4 前端:问答界面
// frontend/src/components/ChatBox.jsx
import { useState } from "react";

export default function ChatBox() {
    const [question, setQuestion] = useState("");
    const [answer, setAnswer] = useState("");
    const [sources, setSources] = useState([]);
    const [loading, setLoading] = useState(false);

    const ask = async () => {
        if (!question.trim()) return;
        setLoading(true);
        setAnswer("");
        setSources([]);

        // 用 fetch + ReadableStream 消费 SSE
        const res = await fetch("/api/chat/ask", {
            method: "POST",
            headers: { "Content-Type": "application/json" },
            body: JSON.stringify({ question, session_id: 1 }),
        });
        const reader = res.body.getReader();
        const decoder = new TextDecoder();

        while (true) {
            const { done, value } = await reader.read();
            if (done) break;
            const text = decoder.decode(value);

            // 解析 SSE
            for (const line of text.split("\n")) {
                if (!line.startsWith("data: ")) continue;
                const payload = line.slice(6);
                if (payload.startsWith("__SOURCES__:")) {
                    setSources(JSON.parse(payload.slice(13)));
                } else {
                    setAnswer(prev => prev + payload);   // 打字机效果
                }
            }
        }
        setLoading(false);
    };

    return (
        <div className="max-w-3xl mx-auto p-6">
            <h1 className="text-2xl font-bold mb-4">企业知识库</h1>
            <div className="flex gap-2 mb-4">
                <input
                    value={question}
                    onChange={e => setQuestion(e.target.value)}
                    onKeyDown={e => e.key === "Enter" && ask()}
                    placeholder="问任何关于公司的问题..."
                    className="flex-1 p-3 border rounded-lg"
                />
                <button
                    onClick={ask}
                    disabled={loading}
                    className="px-6 py-3 bg-blue-600 text-white rounded-lg disabled:opacity-50"
                >
                    {loading ? "思考中..." : "提问"}
                </button>
            </div>

            {answer && (
                <div className="p-4 bg-gray-50 rounded-lg whitespace-pre-wrap">
                    {answer}
                </div>
            )}

            {sources.length > 0 && (
                <div className="mt-4 text-sm text-gray-500">
                    引用来源:{sources.map(s => `文档#${s.doc_id}`).join(", ")}
                </div>
            )}
        </div>
    );
}
前端用 fetch 加 ReadableStream 消费 SSE:读到 data: 开头的行就往答案里追加,形成打字机效果;读到 __SOURCES__ 标记就把引用来源渲染在答案下方。
到这里,MVP 已经能跑了:
docker compose up -d启动所有服务- 上传几份 PDF
- 提问,得到有据可依的答案
四、增强版:流式、多模型、护栏与 HITL
MVP 跑通后,把它增强到「能进生产」。
4.1 模型路由(成本治理)
简单问题用便宜模型,复杂推理才用贵的模型:
# backend/app/llm/router.py
"""根据问题复杂度路由到不同模型:简单问题用便宜模型"""

def route_model(question: str, has_context: bool) -> str:
    """简单规则路由(生产可用 LLM 路由)"""
    # 简单问答用 DeepSeek(便宜)
    if len(question) < 30 and has_context:
        return "deepseek-chat"
    # 复杂推理用 GPT-4o
    if any(k in question for k in ["分析", "对比", "总结", "为什么"]):
        return "gpt-4o"
    # 默认用 DeepSeek
    return "deepseek-chat"
4.2 语义缓存
相似问题直接命中缓存,省下重复的 token 开销:
# backend/app/rag/cache.py
"""相似问题命中缓存,省 Token"""
import redis, json, numpy as np

r = redis.Redis(decode_responses=True)

async def get_cached_answer(question_emb, threshold=0.92):
    """语义缓存:找相似问题"""
    # 遍历缓存的问题向量(生产用向量库,这里简化)
    for key in r.scan_iter("qa_cache:*"):
        cached = json.loads(r.get(key))
        sim = np.dot(question_emb, cached["emb"])
        if sim > threshold:
            return cached["answer"], cached["sources"]
    return None

async def save_to_cache(question_emb, answer, sources):
    key = f"qa_cache:{hash(question_emb.tobytes())}"
    r.setex(key, 3600, json.dumps({  # 1 小时过期
        "emb": question_emb.tolist(),
        "answer": answer,
        "sources": sources
    }))
4.3 输入护栏
过滤不当输入,同时防 Prompt 注入、做 PII 脱敏:
# backend/app/guardrails/input_filter.py
"""过滤不当输入 + 防 Prompt 注入"""
import re

INJECTION_PATTERNS = [
    r"忽略.{0,10}(指令|规则|前面)",
    r"ignore.{0,10}(previous|above|all)",
    r"system\s*prompt",
    r"你的(指令|提示词)是什么",
]

PII_PATTERNS = {
    "phone": r"1[3-9]\d{9}",
    "id_card": r"\d{17}[\dXx]",
    "email": r"[\w.-]+@[\w.-]+\.\w+",
}

def check_input(text: str) -> tuple[bool, str]:
    """返回 (是否通过, 原因)"""
    # 检查 Prompt 注入
    for pattern in INJECTION_PATTERNS:
        if re.search(pattern, text, re.IGNORECASE):
            return False, "检测到潜在的 Prompt 注入"

    # PII 脱敏
    for pii_type, pattern in PII_PATTERNS.items():
        text = re.sub(pattern, f"[{pii_type}已脱敏]", text)

    return True, text
4.4 HITL 人工审核
对于涉及 HR、法务、财务的问题,不直接让模型回答,转人工:
# backend/app/routers/admin.py
HITL_KEYWORDS = ["薪资", "辞退", "解除合同", "理赔", "诉讼", "仲裁"]

@router.post("/ask")
async def ask(req: AskRequest):
    # ... 前面的 RAG 逻辑 ...

    # HITL 检查:高风险关键词触发人工
    if any(k in req.question for k in HITL_KEYWORDS):
        # 不直接答,转人工审核
        review_id = await create_review(req.question, context, sources)
        return {
            "answer": f"您的问题涉及敏感话题(HR/法务),已转人工审核。审核单号:{review_id},"
                      f"预计 4 小时内回复。",
            "needs_review": True,
            "review_id": review_id
        }

    # 正常流式回答 ...
管理员审核接口支持三种处置:直接发送、修改后发送、拒绝:
@router.post("/admin/review/{review_id}")
async def review(review_id: int, decision: ReviewDecision):
    """人工审核:approve(直接发)/ edit(修改后发)/ reject(拒绝)"""
    if decision.action == "approve":
        await send_answer_to_user(review_id, decision.draft_answer)
    elif decision.action == "edit":
        await send_answer_to_user(review_id, decision.edited_answer)
    else:  # reject
        await notify_user(review_id, "您的问题暂时无法回答,请联系管理员")

    await log_audit(review_id, decision)   # 审计日志
五、运营版:监控、评估与 CI/CD
5.1 给每个请求加 Langfuse Trace
# backend/app/rag/traced_rag.py
from langfuse import Langfuse
from langfuse.decorators import observe

langfuse = Langfuse()

@observe()    # 自动 trace 这个函数
async def rag_answer(question: str):
    # 每一步作为子 span
    with langfuse.start_as_current_span(name="embedding") as span:
        q_emb = embedder.encode([question])[0]

    with langfuse.start_as_current_span(name="retrieval") as span:
        results = await retrieve(q_emb)
        span.set_attribute("retrieved_count", len(results))

    with langfuse.start_as_current_span(name="generation") as span:
        answer = await generate(question, results)

    return answer
在 Langfuse 面板里,你能看到每次问答的完整链路、耗时、token 与成本,这就是 JD 里说的「工作流可观测」。
5.2 建立评估流水线
每周用 Golden Set 跑一次评估,监控质量漂移:
# backend/scripts/evaluate.py
"""每周用 Golden Set 跑评估,监控质量漂移"""
from ragas import evaluate
from ragas.metrics import faithfulness, answer_relevancy, context_precision

GOLDEN_SET = [
    {"q": "公司年假多少天?", "ground_truth": "入职满一年 5 天,满三年 10 天..."},
    {"q": "怎么申请退款?", "ground_truth": "登录后台→我的订单→申请退款..."},
    # 50-200 条人工标注
]

async def run_evaluation():
    results = []
    for item in GOLDEN_SET:
        answer, sources = await rag_answer(item["q"])
        results.append({
            "question": item["q"],
            "answer": answer,
            "contexts": [s["content"] for s in sources],
            "ground_truth": item["ground_truth"]
        })

    # 用 RAGAS 自动评分
    scores = evaluate(
        dataset=results,
        metrics=[faithfulness, answer_relevancy, context_precision]
    )
    print(f"忠实度: {scores['faithfulness']:.2f}")
    print(f"相关性: {scores['answer_relevancy']:.2f}")

    # 低于阈值告警
    if scores['faithfulness'] < 0.8:
        await send_alert(f"告警:知识库忠实度下降到 {scores['faithfulness']:.2f}")
忠实度低于 0.8 就触发告警,避免知识库悄悄变差却没人发现。
5.3 docker-compose 完整版
# docker-compose.yml
version: "3.9"
services:
  db:
    image: pgvector/pgvector:pg16     # 自带 pgvector 的 PG 镜像
    environment:
      POSTGRES_PASSWORD: ${DB_PASSWORD}
      POSTGRES_DB: knowledge_base
    volumes:
      - pgdata:/var/lib/postgresql/data
    ports: ["5432:5432"]

  redis:
    image: redis:7
    ports: ["6379:6379"]

  backend:
    build: ./backend
    environment:
      DATABASE_URL: postgres://postgres:${DB_PASSWORD}@db/knowledge_base
      REDIS_URL: redis://redis:6379/0
      DEEPSEEK_API_KEY: ${DEEPSEEK_API_KEY}
      OPENAI_API_KEY: ${OPENAI_API_KEY}
      LANGFUSE_PUBLIC_KEY: ${LANGFUSE_PUBLIC_KEY}
      LANGFUSE_SECRET_KEY: ${LANGFUSE_SECRET_KEY}
    depends_on: [db, redis]
    ports: ["8000:8000"]

  frontend:
    build: ./frontend
    ports: ["80:80"]
    depends_on: [backend]

  langfuse:
    image: langfuse/langfuse:latest
    ports: ["3000:3000"]
    environment:
      DATABASE_URL: postgres://postgres:${DB_PASSWORD}@db/langfuse
      NEXTAUTH_SECRET: ${NEXTAUTH_SECRET}

volumes:
  pgdata:
5.4 CI/CD
# .github/workflows/deploy.yml
name: Deploy
on:
  push:
    branches: [main]
jobs:
  test:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - name: Run tests
        run: |
          cd backend && pip install -r requirements.txt && pytest
  deploy:
    needs: test
    runs-on: ubuntu-latest
    steps:
      - name: Deploy to server
        uses: appleboy/ssh-action@v1
        with:
          host: ${{ secrets.SERVER_HOST }}
          key: ${{ secrets.SSH_KEY }}
          script: |
            cd /opt/knowledge-base
            git pull
            docker compose up -d --build
六、项目演进路线图
建议按这个节奏推进:
| 阶段 | 时间 | 功能 | 简历亮点 |
|---|---|---|---|
| MVP | 1-2 周 | 上传 + 问答 | 独立完成 RAG 知识库系统 |
| 增强 | 2-3 周 | 流式 + 路由 + 护栏 + HITL | 生产级工程化:成本降 60%、安全可控 |
| 运营 | 持续 | 监控 + 评估 + CI/CD | 建立评估体系,质量可量化 |
| 进阶(可选) | 视需求 | 多租户 + 权限 + 微调 | 支持 100+ 部门、效果可量化 |
七、这个项目怎么写进简历?
简历项目段落范例(直接套用,数字务必换成你的真实数据):
企业级 AI 知识库系统(个人项目 | GitHub 链接 | 在线 Demo)
- 技术栈:React + FastAPI + PostgreSQL + pgvector + Redis + Docker + Langfuse
- 核心能力:员工上传文档(PDF/Word/Markdown),AI 基于文档回答问题,有据可依、可溯源
- RAG 引擎:自研文档处理流水线(解析→递归切片→BGE-M3 向量化→pgvector HNSW 检索→重排),召回率从 62% 优化到 87%
- 工程化:模型路由(DeepSeek 处理 80% 简单问题,GPT-4o 兜底复杂问题)+ 语义缓存,单次问答成本降低 65%
- 安全合规:输入护栏(Prompt 注入检测 + PII 脱敏)+ 输出 Moderation + 高风险问题 HITL 人工审核
- 可观测性:Langfuse 全链路追踪 + Prometheus 监控(延迟、Token、错误率)+ RAGAS 自动评估 + Golden Set 回归测试
- 部署:Docker Compose 一键部署 + GitHub Actions CI/CD,支持 SSE 流式输出
面试讲解可以用 STAR 法则组织:
- S(场景):企业需要让员工快速查到内部文档,传统搜索体验差。
- T(任务):做一个基于文档的 AI 问答系统,要求准确、可溯源、低成本、安全。
- A(行动):用 RAG 架构(讲清楚五步),加模型路由和缓存降本,加护栏和 HITL 保安全,加 Langfuse 监控。
- R(结果):用量化数据说话,例如召回率、成本降幅、已支持的文档数与问答次数。
八、本章小结
- 一个完整的 AI 产品 = 全栈(前后端 + DB)+ AI 能力(RAG + Agent)+ 工程化(部署 + 监控 + 护栏 + 评估)。
- 这个项目把全栈、数据库、容器化、Prompt、多模型、流式输出、RAG、HITL、监控、护栏、评估等知识全部串了起来。
- 分三阶段做:MVP 跑通闭环,增强版能进生产,运营版能长期跑,别一上来就想做全。
- 项目是简历的核心,一个做透的项目胜过十个半成品。
- 简历要写出量化结果(召回率、成本、延迟),用 STAR 法则讲清楚。
九、动手练习
练习 1(必做):照着本章搭出 MVP,能上传 3 份 PDF 并完成问答,截图存档。
练习 2(进阶):加模型路由和语义缓存,跑一周统计成本下降多少、缓存命中率多少,写进简历。
练习 3(面试准备):把本项目用 STAR 法则写成 200 字的简历项目描述,并准备 5 个可能的面试问题及答案,例如「你的召回率怎么算的」「怎么防 Prompt 注入」「为什么用 pgvector 不用 Pinecone」。
练习 4(开放):找一个你身边真实的知识查询痛点(比如学习笔记、社区 FAQ、家庭账本),用这套架构做一个解决它的版本,真实场景的项目最有说服力。
十、延伸阅读
- Langfuse 文档:https://langfuse.com/docs
- RAGAS 文档:https://docs.ragas.io
- pgvector 官方示例:https://github.com/pgvector/pgvector
- OpenAI Cookbook 的 RAG 章节:https://cookbook.openai.com
- 开源知识库项目参考:Dify、FastGPT、MaxKB 的架构设计
- 论文《Searching for Best Practices in Retrieval-Augmented Generation》(RAG 最佳实践综述)