字节笔记本
2026年10月4日 · 约 3 分钟读完
Redis 作者用 C 写推理引擎,专跑 DeepSeek
写 Redis 的 Salvatore Sanfilippo(antirez)又开工了,这次是给大模型写本地推理引擎。仓库 antirez/ds4,昵称 DwarfStar,用 C 写成,MIT 协议,23.3k stars。定位一句话:在消费级硬件上跑好几款优秀大模型的最佳方式。作者自己把品质定为 beta,迭代速度很快,README 里还诚实注明了项目在 llama.cpp 与 GGML 基础上做了裁剪复用。
项目简介
ds4 是专用引擎而不是通用 GGUF 播放器:只认项目自家的量化文件。支持的模型包括 DeepSeek V4 Flash(实验性视觉)、DeepSeek V4.1 Flash、DeepSeek V4 PRO,以及 GLM 5.2、5.3、5.3 Flash 和 Qwen3.8 Flash Next。三条 GPU 后端线各有主场:Metal 是第一目标,96GB 内存级 Mac 优先,内存不够就走 SSD 流式把模型摊开;CUDA 阵营把 DGX Spark 当主要目标,多卡、Ada Lovelace、L40S 都在支持列表;ROCm 则瞄准 Strix Halo 平台,Framework Desktop 这类机器直接受益。
核心功能
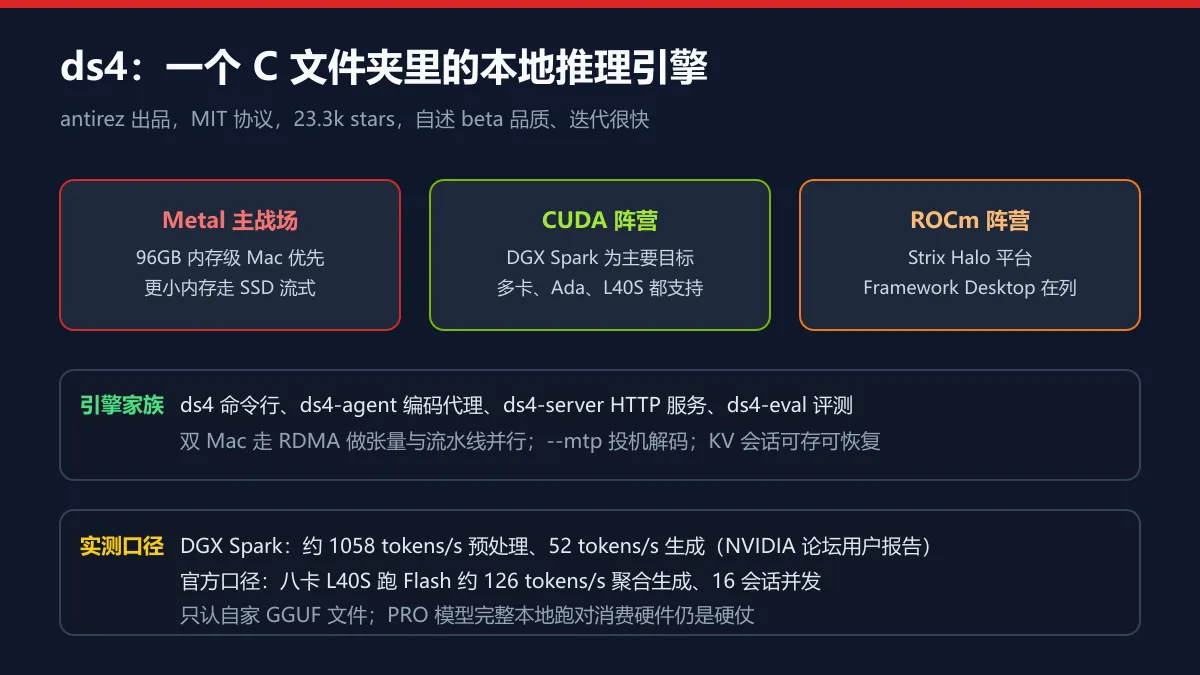
- 一族四个可执行:ds4 命令行直接对话,ds4-agent 是原生编码代理,ds4-server 起 HTTP 服务,ds4-eval 自带评测工具。
- 越算越大的招:两台 Mac 可走 RDMA 做张量并行与流水线并行;--mtp 开投机解码提速;KV 会话可保存恢复,长任务不用从头算。
- 实测口径:NVIDIA 论坛用户报告 DGX Spark 上约 1058 tokens/s 预处理、52 tokens/s 生成;官方口径八卡 L40S 跑 Flash 达到约 126 tokens/s 聚合生成、16 会话并发。
- 诚实的一面:HN 讨论指出完整本地跑 PRO 级模型对消费硬件仍是硬仗,Flash 的 2-bit 量化才是普通玩家的现实选项。
快速上手
make                 # Metal
make cuda-spark      # CUDA
make strix-halo      # ROCm
./download_model.sh ds4f-q2
./ds4 -p "你的提示词"
./ds4-server --ctx 32768
按平台选一条 make 目标编译,下载脚本拉官方量化,然后命令行、代理、HTTP 服务随用随起。
适合谁用
手里有 96GB 级 Mac 或 DGX Spark 的本地模型玩家是第一批受益者,尤其想把 DeepSeek Flash 常驻本地跑编码任务的。喜欢读好代码的工程师也值得 clone 一份:antirez 的 C 代码风格本身就是教材,README 里「AI 强力辅助、人类主导思路与测试」的开发披露也值得借鉴。要提醒的是它不通用:想跑自家 GGUF 的玩家请继续用 llama.cpp,ds4 只服务它名单里那几个模型。