字节笔记本
2026年10月6日 · 约 7 分钟读完
DeepSeek Harness 会话查询子系统解析
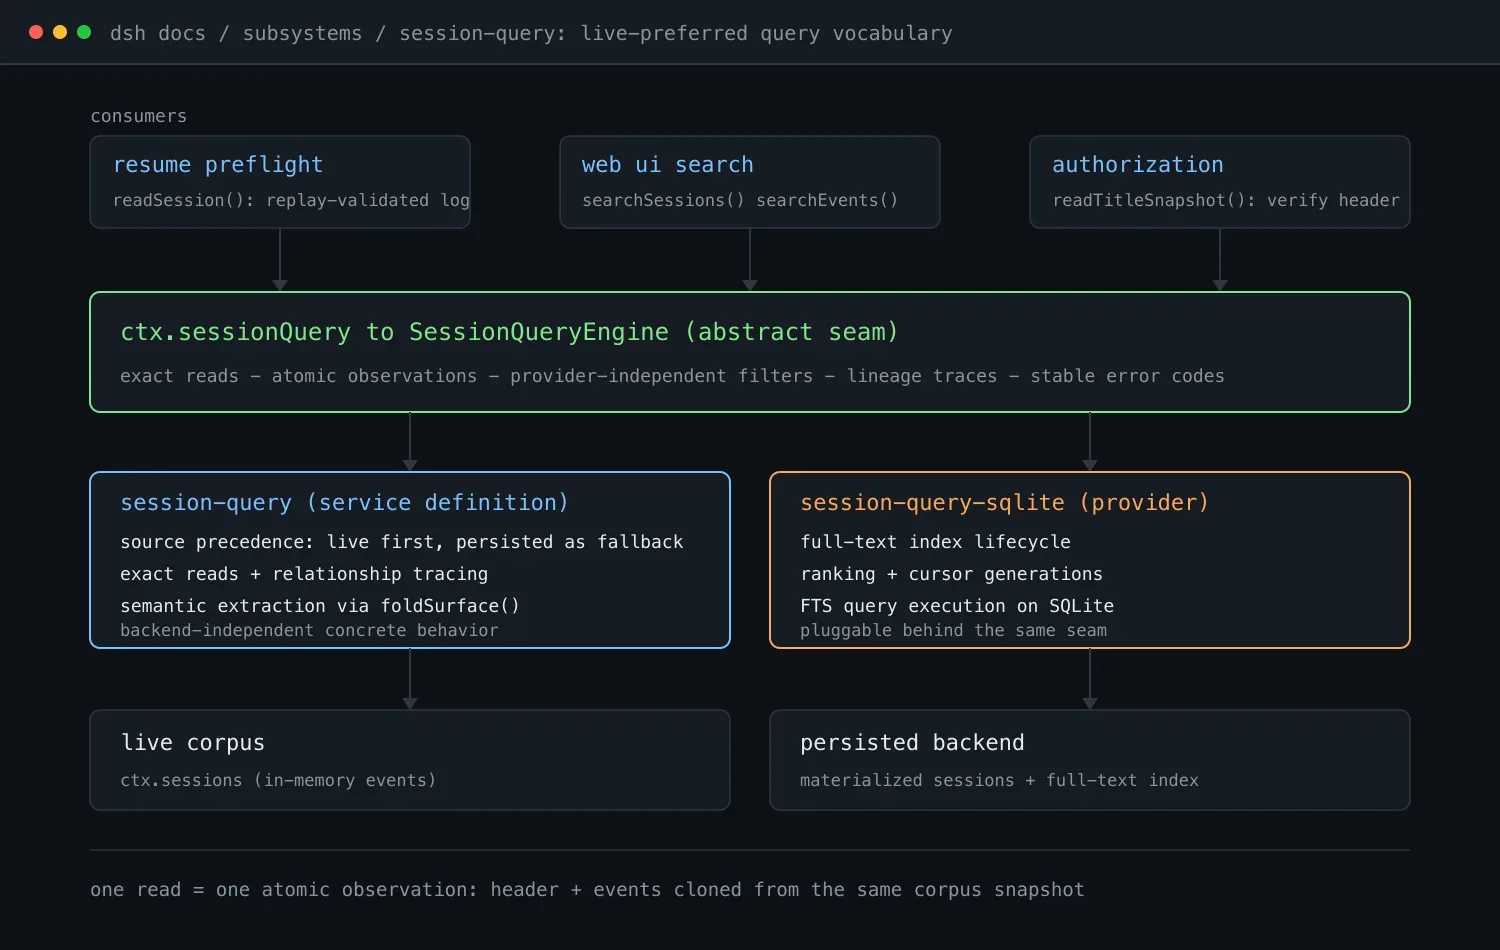
Agent 跑完一轮,有价值的产出都留在会话日志里:消息、推理、工具调用、待办、失败详情。要让这些数据可用,光落盘还不够,还得有一套能读、能筛、能搜、能追血缘的查询接口。DeepSeek Harness 是 DeepSeek AI 开源的智能体框架,主打「一切皆插件」,由 Cordis 驱动,目前处于开发者预览阶段。它把「怎么读会话」收敛成一个独立接缝,挂载后以 ctx.sessionQuery 访问。本文基于其官方文档,拆解这套查询词汇的设计。
live 优先的逻辑语料库
第一个关键决定是读哪个源。会话可能同时存在于两处:内存里的活跃运行时,和持久化后端落盘的副本。查询子系统把两者折叠成一个 live 优先的逻辑语料库:同一个会话 id,live 数据存在就用 live,否则落到持久化副本,调用方感知不到拼接痕迹。
interface SessionRecord {
  header: SessionHeader   // 从 live 优先语料中克隆的会话头
  live: boolean           // 该 id 当前是否存在于活跃运行时
  persisted: boolean      // 当前持久化后端是否已物化该 id
}
live 与 persisted 是两个独立标志,而不是一个「在哪里」的枚举:一个会话可以只在内存、只在磁盘,或两边都有。事件用轻量的 SessionEventRecord 投影表示,每个事件带一个 surface 标注,分 current、shadowed、log-only 三种,分别表示当前模型上下文、已被替换的旧上下文、只存在于原始日志。这个分类与模型历史推导共用同一套 foldSurface() 状态转换,两处读到的口径不会分叉。
一切读取都是原子观测
第二个关键是一致性语义。文档反复使用「观测」这个词:SessionLogSnapshot 是一次脱离运行时的完整原始日志快照,供恢复预检使用,先经持久化修复再经回放验证;SessionSurfaceSnapshot 是对当前模型表面的一次精确读取,不是一份持续保留的订阅。标题同理,SessionTitleObservation 把最新折叠出的标题和提供它的会话头绑定为同一次观测,做授权检查的消费方因此能验证标题确实来自那个头。
批量标题读取的失败语义也划分得很细:结果按输入顺序逐个返回,单会话的解析失败只影响自己那一条,标记为 rejected 并携带原始原因;取消信号则拒绝整个操作。局部失败与全局取消分成两条路径,调用方不必自己猜。
提供方无关的过滤器
过滤器系统刻意与存储后端解耦。会话级过滤支持 id、工作目录、创建时间区间、父会话与可用性;事件级支持 seq 与时间区间、类型、surface,以及文本子句。组合规则只有两条:过滤器数组之间取 AND,单个子句的值列表内部取 OR,区间两端都含。
文本子句值得单独说:它对提取出的语义文本做字面量正则扫描,按 Unicode 规则不区分大小写,空白字符弹性匹配,完全不依赖全文索引。哪些内容会进入语义文本也有明确清单:消息、推理、工具调用与工具结果、被阻止的提示词、待办事项、失败与状态详情都算;纯结构性事件和流分片不算。换句话说,哪怕全文索引损坏或没有部署,filterSessions 与 filterEvents 这条路仍然完整可用。
两个范围的全文搜索
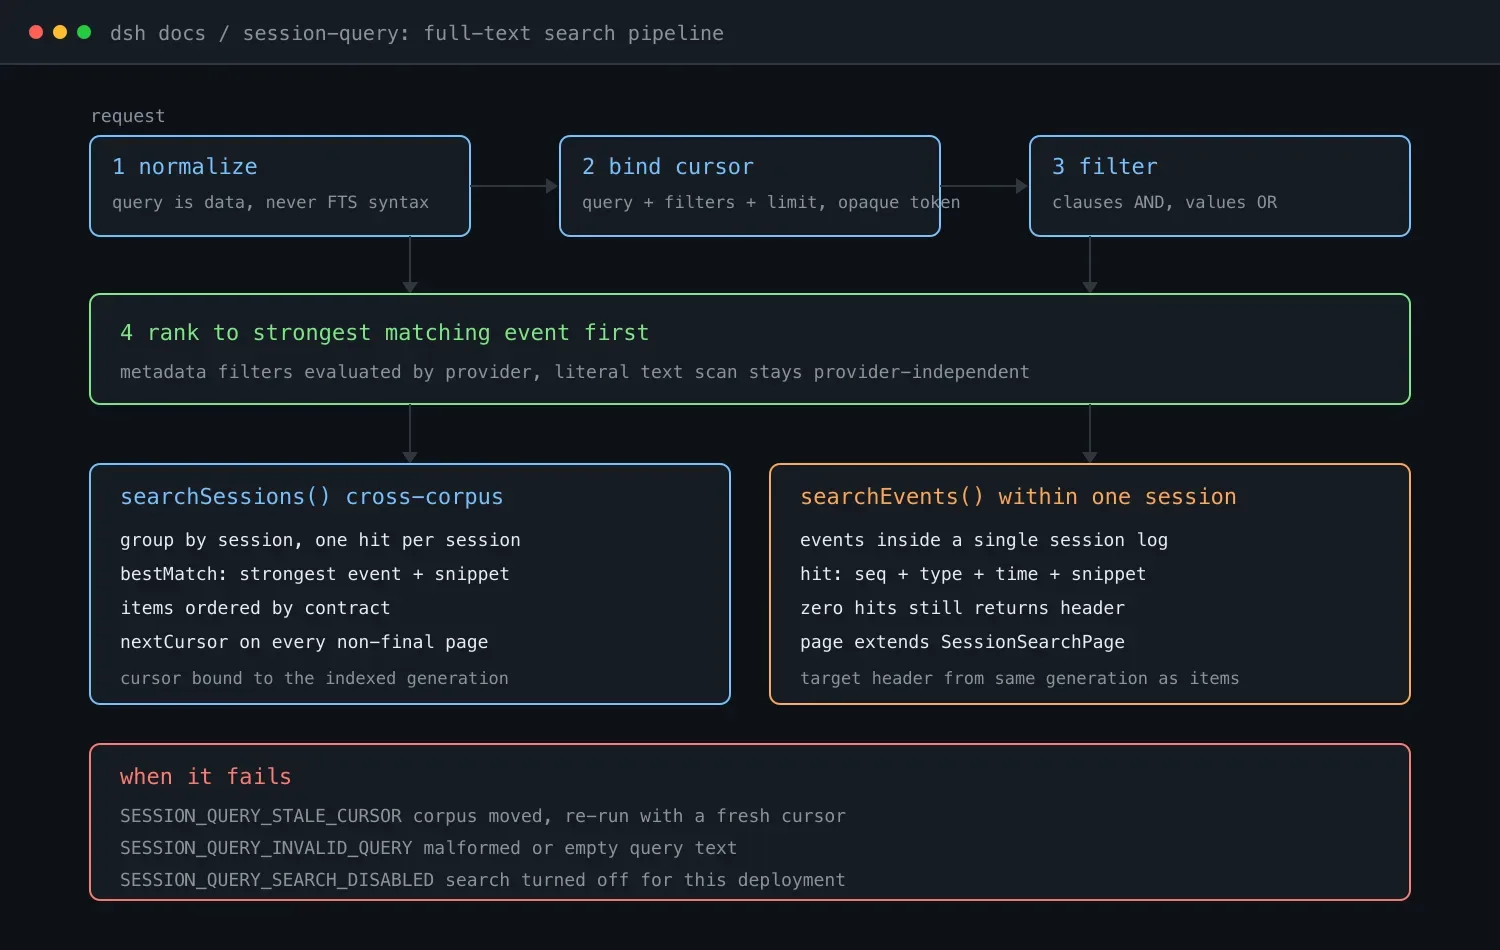
全文搜索在 ctx.sessionQuery 上开了两个范围。searchSessions 面向整个语料库,按会话分组返回命中,每个会话由匹配度最强的事件代表排序;searchEvents 面向单个会话内部。两者都把不透明游标与规范化后的查询、元数据过滤器、页大小绑定,翻页时带游标回来即可继续。
安全设计有两条:查询文本永远按数据处理,绝不解释为可执行的全文检索语法,注入无从谈起;提供方的元数据过滤器里有意不含事件文本扫描,避免两套文本匹配语义打架。还有个贴心细节:会话内搜索即使某一页零命中,也必须把观测到的目标会话头一并返回,调用方至少能确认会话本身的状态。
谱系、窗口与事件关系
会话可以派生子会话,于是需要谱系追踪。traceSession 返回已知祖先,按由近及远排列,外加一棵由直接后代递归嵌套成的森林,并用一个互斥判别收尾:父链完整时给出根会话,链条断在语料库之外时给出第一个解析不到的父 id,两者不会同时出现。
单事件读取走有界窗口:指定目标 seq 与前后各取多少条,返回完整目标事件、窗口内全部原始事件以及首尾 seq。结果携带会话头而非可用性标志,已知的 live 目标不必受持久化健康状态牵连。
事件关系追踪则区分两类完全不同的关联:位置替换与来源引用。事件被 shadowed 时,replacementChain 沿一个个直接替换者追到最终占据该位置的事件;sourceEventSeqs 与 derivedEventSeqs 分别列出它引用的更早事件,和直接引用它的更晚事件。重放调试时,这条链能回答「这个位置的内容为什么变成了现在这样」。
封闭的错误码
最后看错误面。子系统把全部失败收敛成一个封闭的 code 联合类型,共 17 个值,按语义分组:请求校验类,包括非法查询、过滤器、窗口、谱系、游标与页大小;目标缺失类,会话或事件不存在;数据健康类,损坏会话与非法 surface;运行类,持久化失败、索引构建失败与中止;部署类,搜索被关闭;还有源元数据自相矛盾的 SOURCE_CONFLICT。错误机器可路由,插件按码分流处理,不必解析报错字符串。
写在最后
这套查询词汇最值得借鉴的,是把一致性做成了类型:每个读取结果都携带与本次观测同源的会话头,日志快照、表面读取、标题、搜索命中无一例外,消费方永远能回答「我看到的是哪一版的会话」。再配合 live 优先的语料折叠、后端无关的过滤器兜底和封闭错误码,会话数据就从一堆日志文件变成了可以放心编程的数据源。对想给自己的 agent 运行时加检索、审计或回放能力的开发者来说,这份设计本身就是一份现成的清单。项目以 MIT 协议在 GitHub 开源,仓库名 deepseek-harness。