字节笔记本
2026年10月7日 · 约 13 分钟读完
Ent 一对一要在边上写 Unique
Ent 的关联写在 schema 的 Edges 里,不写在字段标签上。一对一靠 Unique(),一对多只在“多”的那一侧的反向边上加 Unique(),多对多两边都不加。改完 schema 要重新 go generate,查询方法是生成出来的,不是手写的。
字段和边分开写
安装命令是 go get entgo.io/ent/cmd/ent。用户实体的字段在对话里是三样:name 字符串、默认 "unknown",age 用 Positive(),email 用 Unique()。邮箱唯一是字段约束,和边的 Unique() 不是一件事。
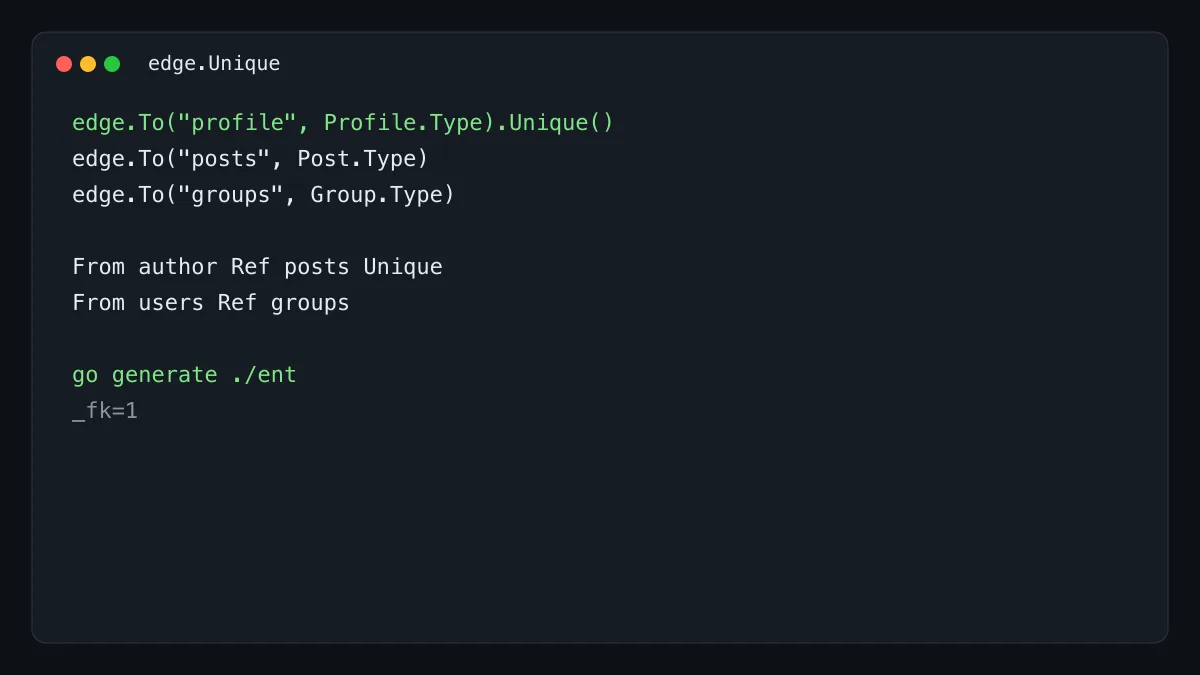
边的第一版是用户到文章:edge.To("posts", Post.Type)。文章侧是 edge.From("author", User.Type).Ref("posts").Unique()。To 是正向,From 加 Ref 指回正向的名字。文章的作者只有一个,所以反向边上有 Unique()。用户的文章有多篇,正向边上没有。
生成命令是 go generate ./ent。schema 改了不生成,Create()、QueryPosts() 这些方法对不上新字段,编译会停在旧代码。
打开数据库的样本是 SQLite 内存库:ent.Open("sqlite3", "file:ent?mode=memory&cache=shared&_fk=1")。_fk=1 把外键打开,边才有约束。接着 client.Schema.Create(ctx) 做自动迁移。内存库进程一停就没了,只适合把关联跑通。
创建用户是 client.User.Create().SetName("John").SetAge(30).SetEmail("john@example.com").Save(ctx)。文章用 SetTitle、SetContent、SetAuthor(u1)。查询是 client.User.Query().Where(user.NameEQ("John")).All(ctx),再 QueryPosts().All(ctx)。NameEQ 来自生成代码,字符串要和字段名一致。
三种边差在 Unique 放哪
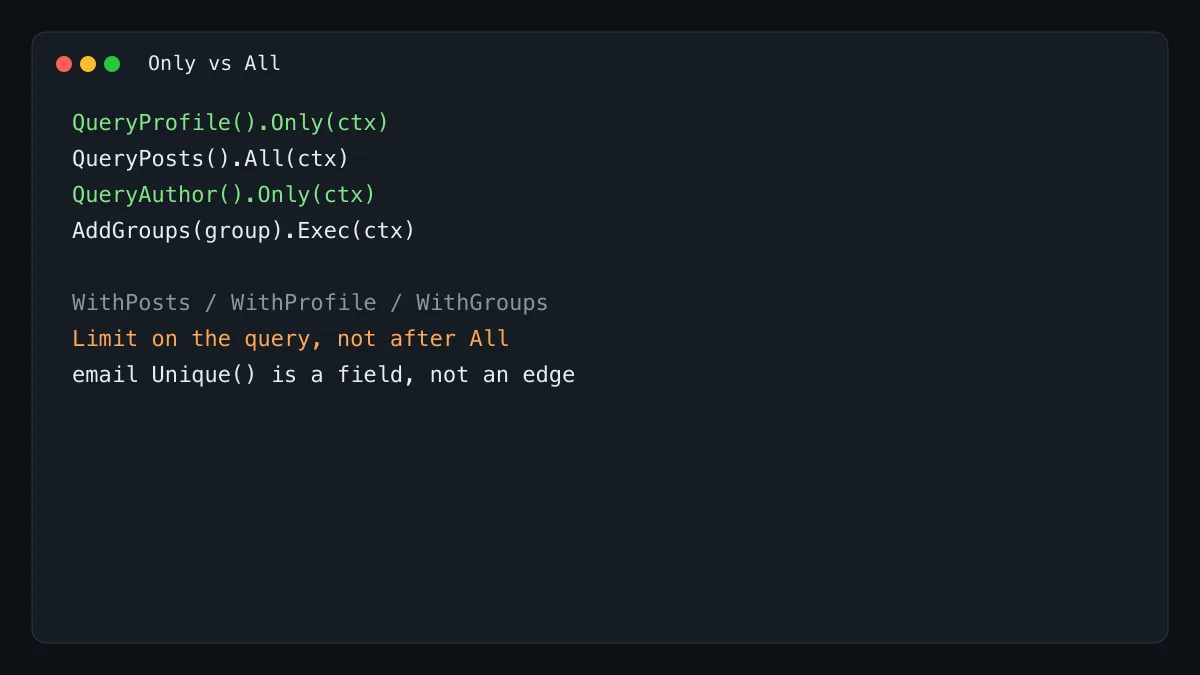
一对一是用户和个人资料。用户侧 edge.To("profile", Profile.Type).Unique()。资料侧 edge.From("user", User.Type).Ref("profile").Unique().Required()。两个 Unique() 把两侧都收成一个。Required() 表示资料必须挂着用户。创建时先存用户,再 client.Profile.Create().SetUser(user).SetBio("Software Developer").Save(ctx)。读取用 user.QueryProfile().Only(ctx)。Only 要求正好一条,零条或多条都会错。一对一用 Only,一对多不要用 Only。
一对多是用户和文章。正向 edge.To("posts", Post.Type) 不加 Unique()。反向 edge.From("author", User.Type).Ref("posts").Unique(),每篇文章一个作者。创建用 SetAuthor(user)。用户侧 QueryPosts().All(ctx),文章侧 QueryAuthor().Only(ctx)。
多对多是用户和群组。用户侧 edge.To("groups", Group.Type),群组侧 edge.From("users", User.Type).Ref("groups"),两边都没有 Unique()。关联表由 Ent 生成,schema 里不用再写一张中间表。加关系是 user.Update().AddGroups(group).Exec(ctx)。读取是 QueryGroups().All(ctx) 和 group.QueryUsers().All(ctx)。
edge.To("profile", Profile.Type).Unique()
edge.To("posts", Post.Type)
edge.To("groups", Group.Type)
三条正向边放在一起就能看见差别:只有资料加了 Unique()。文章和群组不加。把 Unique() 加到群组上,一个用户就只能进一个群。
预加载和条件都在查询上
带条件的文章查询是 user.QueryPosts().Where(post.TitleContains("Hello")).Order(ent.Asc(post.FieldCreatedAt)).Limit(10).All(ctx)。过滤、排序、条数都在这条链上,不要先 All 再在内存里切。
避免一轮用户再每人查一次文章,用预加载:client.User.Query().WithPosts().WithProfile().WithGroups().All(ctx)。对话里点了这三项的名字。只预加载页面要用的边。三边一起上,列表接口会把资料和群组也查出来。
schema 变更之后必须再生成。关系查询注意数量:列表页用 Limit,详情页才 Only。对话里提到关联操作适合放进事务,样本没有展开事务的写法,所以先把 Save 和 AddGroups 的错误各自处理,不要忽略 err 继续查。级联删除在对话里只作为一个能力被提到,没有给出调用,不要自己编一个删除钩子算成框架的默认行为。外键已经在连接串里打开,删除顺序至少要先处理还被引用的一侧,否则 SQLite 会拒。
把样本从打开库跑到查询
连接串 file:ent?mode=memory&cache=shared&_fk=1 里,内存模式适合试验,cache=shared 让同一个进程里的连接看到同一份库,_fk=1 打开外键。没有外键时,边看起来能 Save,库却不阻止悬空引用。ent.Open 失败就退出。defer client.Close() 放在成功之后。
client.Schema.Create(ctx) 按 schema 建表。这之前 go generate ./ent 已经根据 Fields 和 Edges 生成了客户端。用户字段是 name 默认 unknown、age 为正、email 唯一。没调用 SetName 时名字会落到默认值。年龄用 Positive(),零和负数在创建时就应该失败。邮箱重复时 Save 返回错误,不要再查一次来“确认”。
文章 SetAuthor(u1) 用的是已经 Save 过的用户。先有用户,再有文章。查询 user.NameEQ("John") 来自生成出来的 user 包,和字段名对应。All 返回切片,长度可能是零。样本接着用 users[0].QueryPosts(),在长度为零时会越界。先看 len,再取第一项。
个人资料是 SetUser(user) 加 SetBio。QueryProfile().Only 在没有资料或意外多了一条时返回错误。文章列表用 All。作者用 QueryAuthor().Only。群组用 AddGroups 之后 QueryGroups 和 QueryUsers,两边都是 All。这四个方法对上三种边,不要用 Only 去取文章列表。
条件和预加载留在链上
TitleContains("Hello")、ent.Asc(post.FieldCreatedAt)、Limit(10) 是在 SQL 侧限制。先 All 再在 Go 里过滤,会把不要的文章也查出来。FieldCreatedAt 要这个字段真的在 schema 里。对话的 Post 字段只列出了 title 和 content,排序字段若没定义,生成代码里不会有这个常量。把要排序的时间字段加进 schema,再生成,再写 Order。
WithPosts、WithProfile、WithGroups 一次把边带上。列表接口若只显示名字,不要三边全开。详情页再按需要预加载。对话把这三种预加载放在同一次 Query 里,是为了说明 API 的形状,不是说每个接口都要三者齐上。
事务在对话里是建议,没有具体的 Tx 代码。多个 Save 要同时成功时再查事务的写法。单个 Save 的 err 必须处理。级联删除同样只被提到,没有调用样本,删除时按外键约束自己安排顺序。连接串已经要求外键,数据库会拒绝仍被引用的删除。
schema 改完不生成,是这一套最常见的“方法不存在”。Unique() 放错边,是最常见的“关系数量不对”。两件事都在生成之前就能从 schema 里看出来。
生成之后方法才存在
Ent 的边用 edge.To 和 edge.From().Ref 配成一对。一对一两侧 Unique(),需要必填时再加 Required()。一对多只在“一”的那一侧加 Unique()。多对多两侧都不加,用 AddGroups 建立关系。连接串带上 _fk=1,迁移用 Schema.Create。改 schema 就 go generate。列表用 All 加 Limit,单个关联用 Only。预加载只开用得到的 With 方法。
用内存库把三条边走一遍再换真正的数据库。连接串保持 file:ent?mode=memory&cache=shared&_fk=1。生成之后 Schema.Create。用户 SetName("John")、SetAge(30)、SetEmail("john@example.com")。资料 SetUser 后 QueryProfile().Only 得到一条。文章 SetAuthor 后 QueryPosts().All 得到列表,QueryAuthor().Only 回到这个用户。群组 AddGroups 后两边都能 All。users 切片为空时不要访问下标 0。
TitleContains 和 Limit(10) 留在查询链上。排序用的创建时间若 schema 的 Post 里还没有,先加字段再生成,不要引用一个不存在的 FieldCreatedAt。列表接口不要同时 WithPosts、WithProfile、WithGroups。邮箱的 Unique() 是字段约束,和边上的 Unique() 分开看。改完 Edges 必须 go generate ./ent,否则方法还是上一版的形状。
正向边用 edge.To,反向边用 edge.From 加上 Ref,Ref 里的字符串要和正向的名字一致。posts 对 posts,profile 对 profile,groups 对 groups。名字写错,生成出来的查询方法会对不上,运行时不是“查不到数据”,而是编译就过不了或者查到另一条边。一对一两侧都有 Unique(),资料侧还可以 Required()。一对多只在作者那一侧 Unique()。多对多两侧都不加,用 AddGroups 而不是 Set 一个单独的群。Only 只用于期望正好一条的查询。All 用于文章和群组成员。Save 和 Exec 的错误各自返回,不要在 err 还在时继续 Query。内存库把流程跑通之后,再把驱动换成真正要上线的数据库,schema 和 Unique() 的位置不用为了换库重写。邮箱唯一约束写在字段上,一对一的 Unique() 写在边上,两处同名但不是同一个方法。生成代码之后才能调用 QueryPosts 和 QueryProfile。schema 改完却不生成,编译器仍指向旧方法。列表用 Limit,不要一次把三边都预加载出来。详情页再按需要去打开它。