字节笔记本
2026年10月7日 · 约 2 分钟读完
把能力装进瓶子:最省 657 倍,但多数不及格
agent 能不能把自己的通用能力装成便宜的任务专用方案?周三批次的两篇新论文,一篇给这个能力立了基准并泼了冷水,一篇在模型结构层面给出了自适应路线。
BOTTLED:装瓶能力大考
Ankit Sonthalia 等五人的论文(arXiv:2610.08775)定义了一个新能力叫装瓶:面对百万级同质查询的工作负载,agent 在固定时间、算力与 API 预算内自选路线,训个小模型或写可复用代码都行,目标是质量与摊销成本的平衡。基准给了十模型三任务的考场。
结果一冷一热。冷的是普遍不及格:四十八次运行低于自家零样本成绩的 95 置信下界,三十一次运行不如同 token 预算的小模型蒸馏基线,零样本强不等于装瓶强。热的是上限惊人:Opus 5 在查询商品相关性分类上保住约 82 个百分点的宏 F1,报告成本约省 657 倍;在 Jev 决策场景找回约 94 个百分点宏 F1,只花四分之一投影成本。结论很工程:自动降本的真实潜力存在,但大多数模型还接不住,需要人盯方案选择。页面未见代码链接。
AnyBottle:概念用到哪算哪
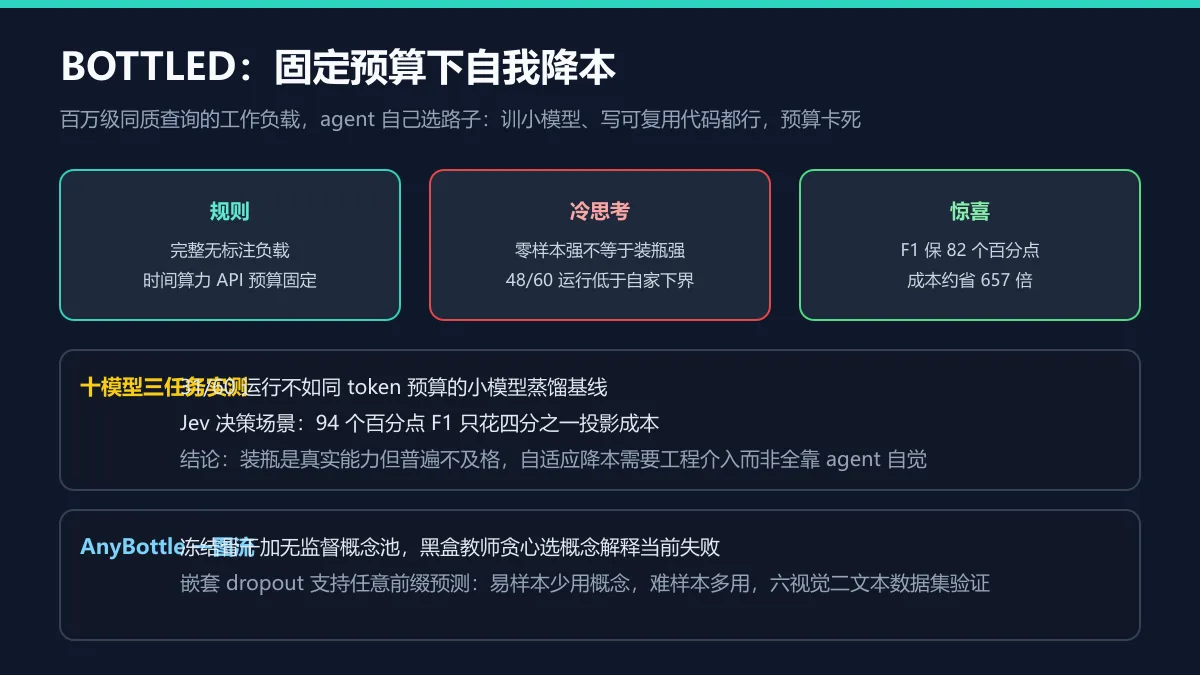
Wolfgang Stammer 等人的 AnyBottle(arXiv:2610.08552)从结构侧回答同一个问题的另一面:怎么只留真正需要的概念。条件要求很低:一个冻结骨干加一个无监督概念池(比如稀疏自编码器),不需要任何概念标注。
方法是黑盒教师引导的贪心选择:每轮挑最能解释瓶颈当前失败的概念,且只在师生分歧区域做挑选。训练用嵌套 dropout 做前缀任意化,推理时易样本少用几个概念、难样本多用几个,概念数随难度自适应。六个视觉与两个文本数据集、两种教师范式下,瓶颈更小、概念一致性更高,且精度贴近黑盒教师。
放在一起读
一篇证明降本的收益上限是百倍量级、但当前 agent 普遍接不住;一篇把按需用概念做成了结构能力。对运营大规模同质任务负载的团队,装瓶思路值得现在就内部试点,方案选择这道关先留给人。