字节笔记本
2026年10月7日 · 约 7 分钟读完
Gin 缓存键用整段 URL
Gin 的接口每次都查库,重复的 GET 可以用 Redis 把响应存下来。中间件要做的是:用什么当键,过期时间多长,什么请求不缓存,以及很多人同时打到一个过期键时,只让一个请求去回源。
键是整段 URL 的摘要
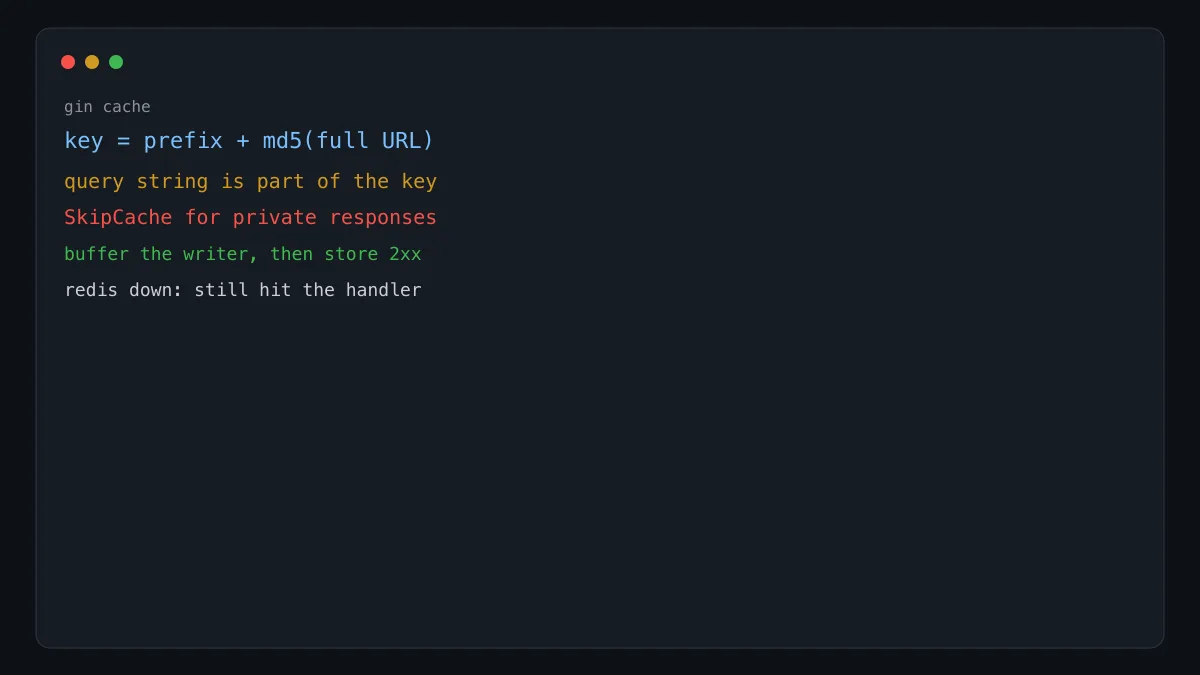
配置里有 Redis 客户端、过期时间、键前缀,还有一个 SkipCache。跳过函数返回真,这次请求直接 c.Next(),不读也不写缓存。登录后的个人数据、带一次性令牌的请求,应该走这里。不要靠默认“所有 GET 都缓存”。
键的样本是前缀加上 URL 的 MD5。URL 用 c.Request.URL.String(),查询参数也算进去。/items 和 /items?page=2 不是同一条缓存。只哈希路径、不哈希查询,分页会串页。
func generateCacheKey(c *gin.Context, prefix string) string {
    sum := md5.Sum([]byte(c.Request.URL.String()))
    return prefix + ":" + hex.EncodeToString(sum[:])
}
MD5 在这里不是安全签名,只是把可变长度的 URL 收成固定长度。不要把原始 URL 当键又不做长度限制,查询串很长时会顶到 Redis 的键上限。前缀用来区分环境和接口组,清缓存时可以按前缀扫,而不是把整个库删掉。
先读缓存,未命中再把响应抄下来
命中时把存下的状态码和正文写回 c,然后 Abort,后面的处理函数不要再跑。未命中时换掉 c.Writer,用一块缓冲区接住后续写出的字节。c.Next() 之后,如果状态码是成功,再把缓冲区设进 Redis,过期时间用配置里的 Expiration。
非 GET、或者处理函数返回了 4xx 和 5xx,不要写入。把错误页缓存下来,修完数据之后用户仍会看到旧的失败。SkipCache 为真时连读都跳过,避免一个不该公开的响应因为 URL 相同被下一位访客拿到。
缓冲区要在写完后把内容再抄给真正的 ResponseWriter,否则客户端收到空正文,Redis 里却有一份。这是这种中间件最常见的漏。
过期瞬间用 singleflight 并成一次回源
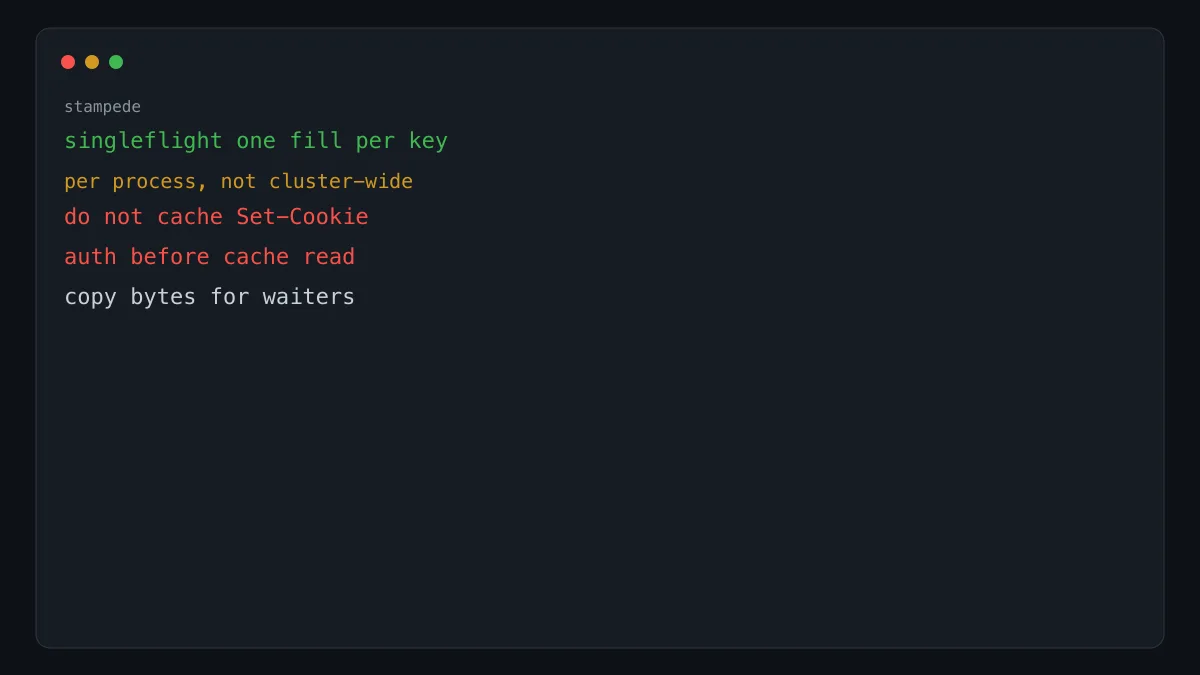
键刚好过期时,一百个请求会同时未命中,同时打到数据库。后一版样本引进了 singleflight。同一个键在飞行中的回源只有一个,其余等待那一次的结果。这和分布式锁是同一类问题的两种写法。singleflight 只并本进程里的并发。多实例时,每个进程仍会各回源一次。样本后半还提到了锁和多级缓存,那是下一步。先把单进程里的击穿挡住,再谈跨机器的锁。锁的错误如果处理成“缓存正在锁定就直接 500”,用户会在过期的那一秒集中失败。等结果或短暂重试,比立刻报错合适。
监控可以以后再加。先确认三件事在日志里能看见:命中、未命中、写入失败。写入失败不应该让接口失败,顶多这次不缓存,下次再写。Redis 挂了,接口仍要能回源。
键、跳过、击穿
缓存中间件的正确性在键和跳过规则,性能在过期瞬间不要放进一百次回源。URL 连同查询一起哈希,个人数据走 SkipCache。未命中用缓冲区抄响应,成功才写入。同一键的并发回源用 singleflight 收成一次。Redis 不可用时退回直接查库,不要把缓存故障变成接口故障。
缓冲和状态码要一起看
替换 Writer 之后,处理函数里的 c.JSON 写的是缓冲区。中间件在 Next 返回后读取缓冲区的字节和状态码。只缓存字节、不缓存状态码,命中时你会用 200 吐出一份当年的 404 正文,或者相反。键相同、状态不同,是两份响应。样本把成功才写入说清楚了,命中时也要把当时的状态写回去。
头也要有选择地保存。Content-Type 必须在,否则客户端把 JSON 当文本。不要把 Set-Cookie 和与用户相关的头放进所有人共享的缓存项。一个带登录 Cookie 的响应被按 URL 缓存后,下一位访客会收到别人的 Set-Cookie。这就是 SkipCache 要存在的原因:只要响应依赖调用者身份,就不要进这层缓存。
过期时间是配置项,不是写死在中间件里的常量。列表可以短,几乎不变的配置接口可以长。改了数据却等不到过期,是缓存的正常表现,要有按前缀删除的办法。没有删除办法的缓存,只能靠把过期时间设得很短来补救,短到失去意义。
singleflight 的键用缓存键,不用用请求指针。不同请求对象、同一个 URL,应该并成一次。用请求指针,每次都是新键,并没有发生。等待方拿到的是第一次回源的正文拷贝,不要共享那块还会被改写的缓冲区。拷贝之后再发给等待的请求。
多实例时 singleflight 不够。每个进程各放一个请求进数据库,仍然比一百个好,但不是全局一次。样本把锁和多级缓存放在后一版里。锁要有过期,避免持有者崩溃后键永远锁住。等待超时之后退回自己回源,而不是一直等。这些是生产加固。第一版先保证键正确、错误不缓存、Redis 故障时接口仍可用。
MD5 碰撞不是这个设计的主要风险。主要风险是把不该共享的响应放进了按 URL 共享的键。审查时先看 SkipCache 的条件,再看哈希用了 URL 的哪一段。 前缀建议带上接口版本或环境。同一 Redis 给测试和生产用时,没有前缀会互相读到对方的列表。样本的 KeyPrefix 就是这个位置。空前缀不是默认安全,空前缀是所有键挤在根上。
跳过函数里读取头部或 Cookie 时,不要把这些值拼进键再缓存。那样等于按用户分键,命中率极低,而且键里出现了凭据的材料。要么完全跳过,要么键里只有公开的 URL。没有第三种“把用户 id 哈希进键还当作公开缓存”的中间态,除非你清楚这是私有缓存,并且过期和删除都按用户来。
上线时先对一个只读、与身份无关的接口打开缓存,看命中日志。确认缓冲区把正文原样交回去、状态码没丢,再扩大路径。一开始就包住整个路由组,登录接口一旦被缓存,事故范围就是全部用户。 缓存的正文是当时的字节,不是处理函数的再次执行。上线后改了 JSON 字段,旧缓存仍是旧字段,直到过期。客户端要能容忍缺失字段,或者在发布时按前缀清掉相关键。不清又立刻改契约,是缓存中间件最容易背锅的一次发布。
命中路径不要再跑后面的鉴权之外的逻辑,但鉴权本身如果决定了能不能看这份数据,就要么放在缓存之前,要么这个接口根本不缓存。把鉴权放在命中之后,等于用缓存绕过了鉴权。顺序是:跳过规则和身份,然后才读键。