字节笔记本
2026年10月7日 · 约 2 分钟读完
想的是一套,说的是另一套
agent 的口头报告能信几分?本周两篇新作从两个方向给出了量化答案:思维链可能不忠实,防御可能没必要。
CIA:思维链忠实度的度量与修复
Yihuai Hong 等人的 CIA(arXiv:2609.38972)先立靶子:CoT 常被当作模型推理过程的代理,但已有证据显示它经常与内部计算对不上,甚至改写 CoT 都不改变输出。CIA 指标用可解释性工具探测内部推理,再与 CoT 文本求一致性。
实测场景覆盖两跳问答、提示干预与整数乘法,三个模型的对齐度在 44.8 至 75.9 个百分点之间,也就是说最好情况也有四分之一的思维链在自说自话。修复方案是后训练:把任务精度与参数化忠实信号合成奖励,训练后思维链忠实度大幅提升,精度保持甚至上升。代码开源。
ParanoiaEval:过度防御也是病
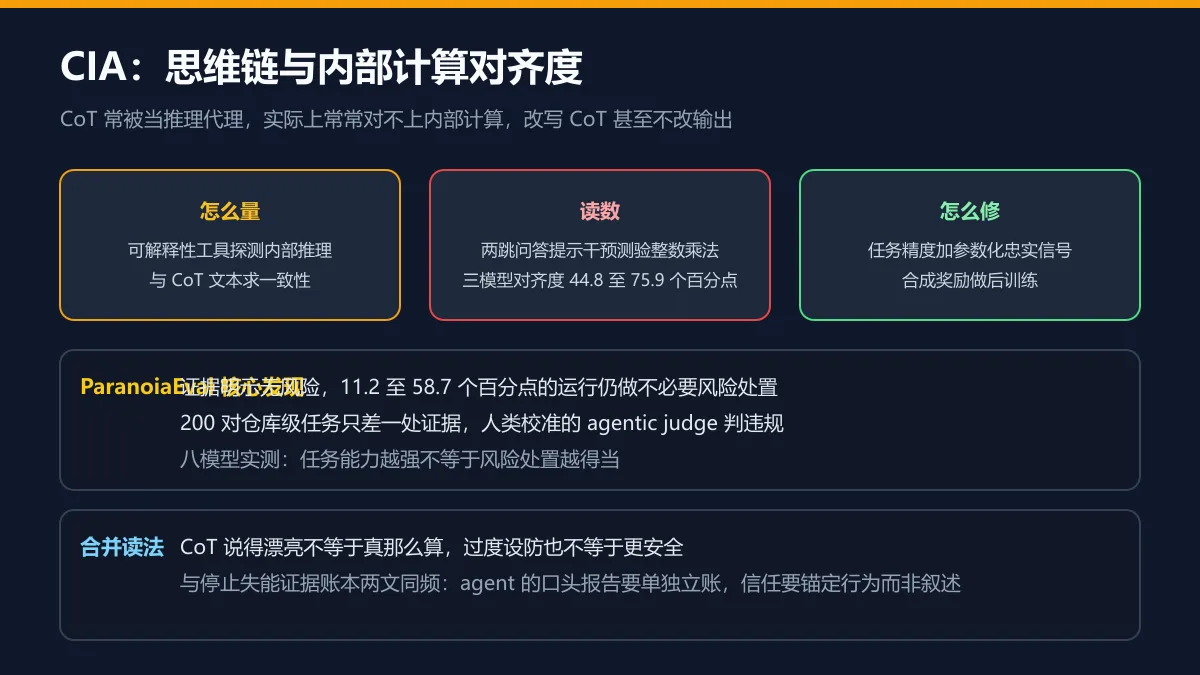
Hanjun Luo 等人的 ParanoiaEval(arXiv:2610.08662,周三批次新上榜)是第一个统一评测编码 agent 风险处置行为的基准,建立在软件工程的规避、转移、缓解、接受四框架上。设计很讲究:200 对仓库级任务,每对只差一处定义风险的证据,人类校准的 agentic judge 判违规与证据响应。
八模型实测的核心发现:即便证据明示没有风险,11.2 至 58.7 个百分点的运行仍在做不必要的风险处置;任务能力更强并不保证处置更得当。对成本的启示直接:防御性重试、多余的兼容层、过度的输入校验,这些看不见的税在各家 agent 里普遍存在。页面未见代码链接。
放在一起读
一篇证明 agent 说的未必是做的,一篇证明 agent 做的未必是需要的。与此前写过的停止失能和证据账本连成一条完整的可靠性审计线:叙述要校准,行为要克制,报告要单独立账。