字节笔记本
2026年10月7日 · 约 3 分钟读完
多开 agent 反而更慢:SquidAgent 算清并行的两笔隐藏账
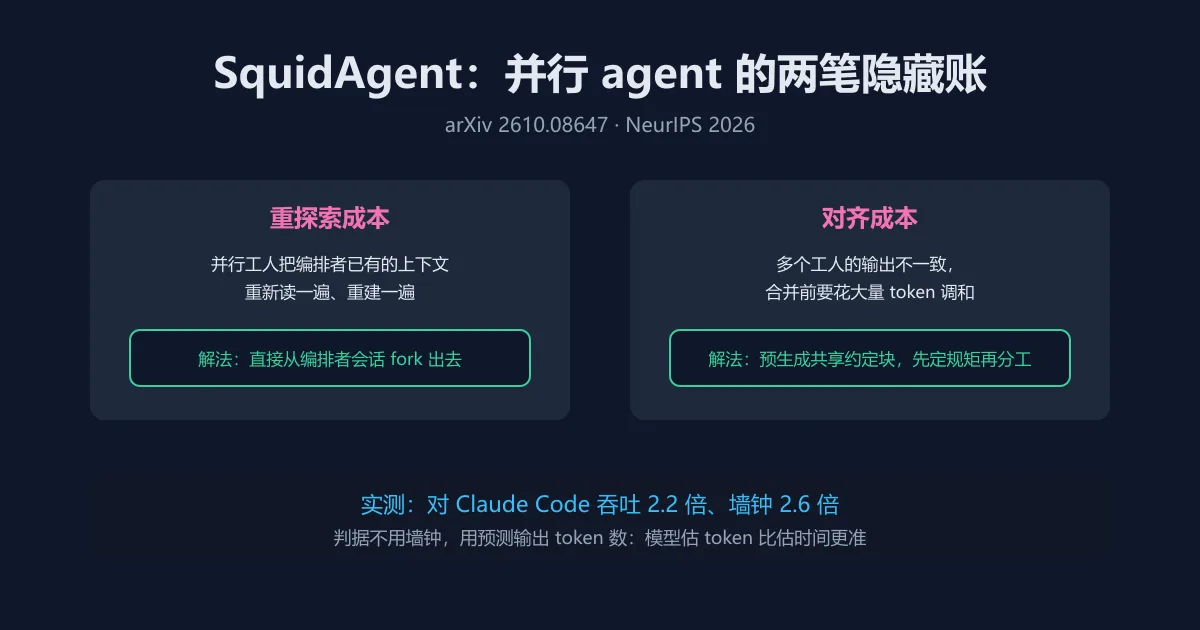
把任务拆给多个 agent 并行跑,听起来就该更快,实际用过的团队多半遇到过反面:编排者把活分下去,等工人交回来再合并,总时间反而比一个 agent 顺着做更长。NeurIPS 2026 接收的论文 SquidAgent(arXiv 2610.08647,作者 Yexiong Lin 等)正面回答了这个问题:并行多 agent LLM 系统常常跑不过单 agent 基线,原因不在模型不够强,而在两笔一直没被算清的隐藏成本。
两笔隐藏账
第一笔叫重探索成本。编排者把子任务分给并行工人时,工人拿到的是任务描述而不是上下文:编排者已经读过哪些文件、已经确认过哪些事实,工人一概不知,只能把这部分工作重做一遍。并行省下的推理时间,被重复读代码、重复查证吃掉一截。第二笔叫对齐成本。多个工人各自产出后风格和口径不一致,合并阶段要花大量 token 去调和:这个工人用了驼峰命名那个用了下划线,这个工人改了接口那个没同步,来回拉扯的成本全藏在合并里。
SquidAgent 的三个动作
论文的解法直接对着两笔账去。其一,要不要把某一层拆并行,判断标准不用墙钟时间,而用预测输出 token 数来度量,理由很实际:LLM 对自己要输出多少 token 的估计远比对耗时的估计可靠。这个方向选择本身就很关键:把并行决策建立在 token 预算上,规划阶段就能算出拆分到底划不划算,不用真的跑一遍再回头复盘。其二,规划阶段一次性估出各部分的 token 预算,工人直接从编排者的会话 fork 出去,父会话里已有的上下文原样继承,重探索成本被砍掉。其三,分工前先预生成一块共享约定块,命名风格、接口边界、输出格式提前定死,工人按同一套规矩产出,对齐成本有了上界。
实测数字
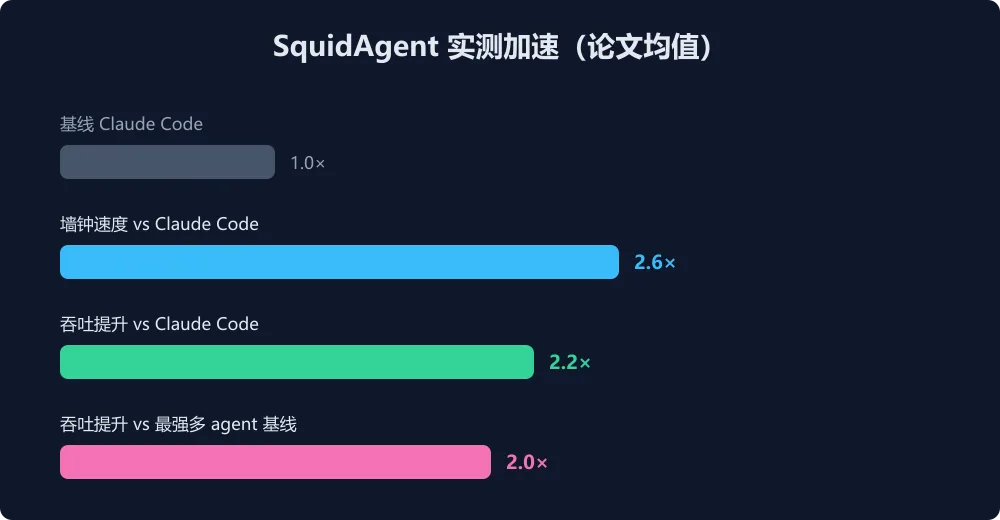
在论文的实验里,SquidAgent 对 Claude Code 取得平均 2.2 倍吞吐提升和 2.6 倍墙钟加速,对最强多 agent 基线也有 2.0 倍吞吐提升。这两个倍数说明的正是隐藏账的体量:同样的模型、同样的任务,仅靠把上下文继承和约定前置做对,并行才真正变成加速而不是仪式。论文连同附录共 37 页,已获 NeurIPS 2026 接收,方法本身不绑定特定模型,任何支持会话分支的编排框架都可以借鉴这套估账、fork、立约定的三段式思路。
对工程团队的启示有三条:并行之前先估 token 账,估不出收益就别拆;能 fork 就别让工人重新读一遍世界;先立约定再分工,合并阶段才不会变成谈判桌。Claude Code 重度用户可以对照检视自己的 subagent 编排,多数人缺的不是并行能力,而是这两笔账的意识。