字节笔记本
2026年10月5日 · 约 2 分钟读完
学会折蛋白质,大模型更会推理了
语言模型从人类文本里学到的大多是表面答案,答案背后的空间与结构逻辑很难从文字里传下来。今日 Hugging Face 论文榜的榜首工作给了一个漂亮的解法,同榜的另一篇机器人论文则在动作侧呼应了同一个思想:结构先于语言。
Fold2Reason:一个已解结构,数千条推理教材
Yong Liu 等七位作者的论文(arXiv:2609.38879,今日榜 90 赞)选蛋白质折叠当训练场,理由很硬:每一个已解出的蛋白质结构,都能产出数千条精确可查的空间与拓扑陈述,天然就是可验证的推理教材。他们构建了蛋白质衍生问答数据集 FoldingCorpus,并提出 Fold2Reason 训练配方,用两路互补信号做后训练:离散的结构化答案走模型原生语言头,连续的三维几何从同一共享表示解码。
成绩分两层看。域内,FoldBench 上的结构预测得分达到 Qwen3.5-9B 的 2.7 到 3.5 倍;域外,空间、图、科学与通用推理共十个基准全部提升,宏平均 accuracy 从 45.09% 升到 48.33%。最有说服力的是对照实验:用随机、合成、打乱结构构造的匹配对照组,增益大幅缩水甚至为负。结论落得很稳:非语言、结构密集的科学数据可以系统性地提升语言模型的通用推理,已解科学问题本身就是后训练监督的富矿。页面未见代码链接。
ProWAM:先想清楚画面,再动手
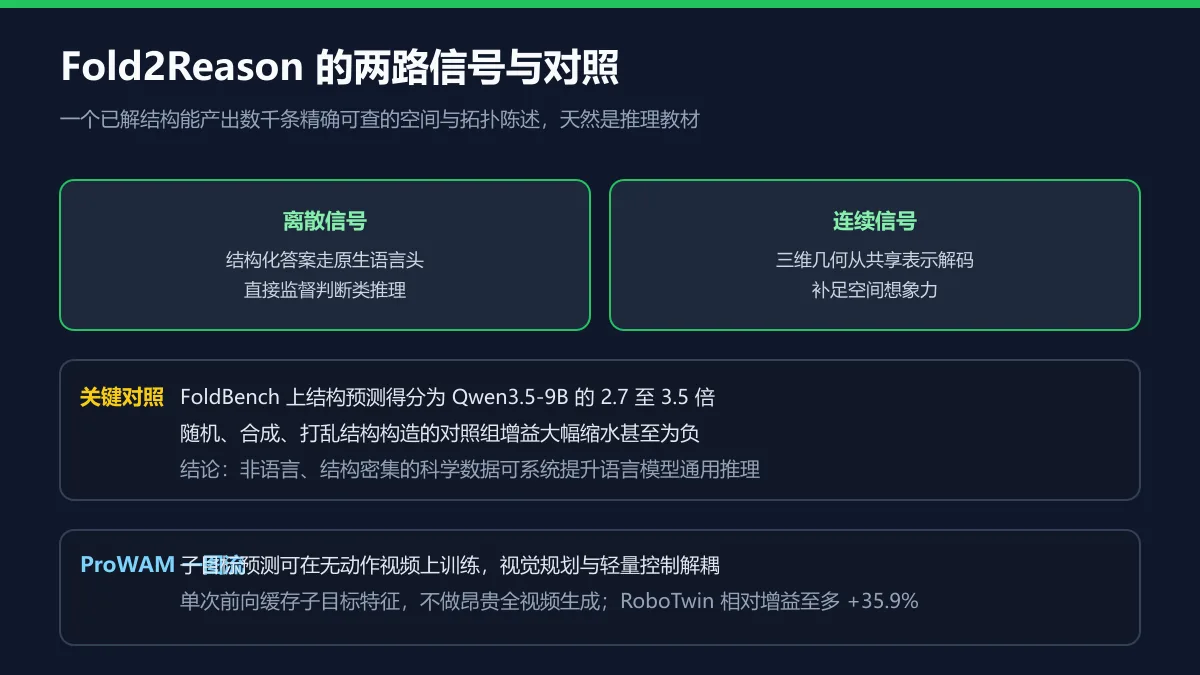
Fei Zhang 等人的 ProWAM(arXiv:2610.02508,30 赞)把同样的思想搬进机器人:渐进式世界动作模型联合预测机器人动作与一串有序的稀疏视觉子目标,让动作生成有明确的画面指引。架构上的巧劲在于子目标预测可以在无动作标注的视频上训练,视觉规划交给视频底座,控制交给轻量动作策略,两者解耦;推理时单次前向就缓存子目标特征,不做昂贵的全视频生成。
数字同样漂亮:LIBERO-Plus 达到 85.8%,随机化 RoboTwin 达 75.7%(相对增益至多 +35.9%),零样本真实世界实验成功率 70%,比 55% 的基线高出一截。项目页已开放,代码入口见项目页链接。
放在一起读
一篇证明结构密集的监督能迁移成通用推理,一篇让结构化的视觉规划带着动作走。两篇加起来支持同一个判断:推理能力的下一批养料,未必在更多网页文本里,而在几何、物理与视频这些天然带结构的模态里。