字节笔记本
2026年9月24日 · 约 9 分钟读完
GPT-6 Astra 发布,OpenAI 称对齐能力同步跃升
OpenAI 于 9 月 3 日发布 GPT-6 Astra,定位为迄今最智能也是对齐最好的模型。总裁 Greg Brockman 在发布前的媒体沟通会上表示,他个人认为公司已经实现 AGI,未来回头看这可能就是那个节点。
发布安排与定价
Astra 首批开放给网络安全项目 Daybreak 的少数机构使用,未来几天内陆续推送给 ChatGPT Plus、Pro、Business、Enterprise 全部用户,同时接入 API 与 AWS Bedrock。用量计入现有订阅额度,超出部分可购买积分,企业版默认关闭,需管理员手动开启。
API 模型名为 gpt-6-astra,标准定价为每百万输入 token 10 美元、输出 50 美元,与 Anthropic Claude Fable 5.1 完全一致,是 GPT-5.6 Sol 促销价的 2.5 倍。另有 Fast 模式,速度提升至标准版的 2 倍,价格同步翻倍。支持 Zero Data Retention。
电脑操作能力
这次发布的核心卖点是电脑操作,即模型自主控制屏幕、点击鼠标、填写表单,在真实软件环境中完成工作。
OpenAI 给出的场景覆盖填写网页表单、更新 CRM 客户记录、整理日历、撰写研究摘要、分析科学数据并绘图、搭建网站并运行前端测试、安装排查软件问题。演示材料还展示了 Astra 在 KiCad 中完成 PCB 电路板布线,在 Blender 中建模房屋后导入虚幻引擎 5 生成可行走场景。
| 基准 | GPT-6 Astra | GPT-5.6 Sol | Claude Opus 5 |
|---|---|---|---|
| Agents' Last Exam | 59.3% | 53.6% | 55.5% |
| OSWorld 2.0(离线子集) | 72.6% | 65.7% | 70.2% |
| ScreenSpot-Pro | 92.7% | 76.9% | — |
在 OSWorld 2.0 的延迟模拟中,Astra 完成单个任务平均耗时约 40 分钟,GPT-5.6 Sol 需要约 75 分钟。配合更新后的 Codex 框架,Mind2Web 基准上的任务完成速度达到 Sol 的 1.9 倍。
办公场景上,官方说 Astra 是目前最擅长按模板做 PPT 的模型,能沿用公司现有模板的排版和语气,做出来的文档、表格、幻灯片直接能用,而且学会了只把相关信息放进产出物,不再把无关内容一股脑塞进去。
编程能力:整体领先但非全面碾压
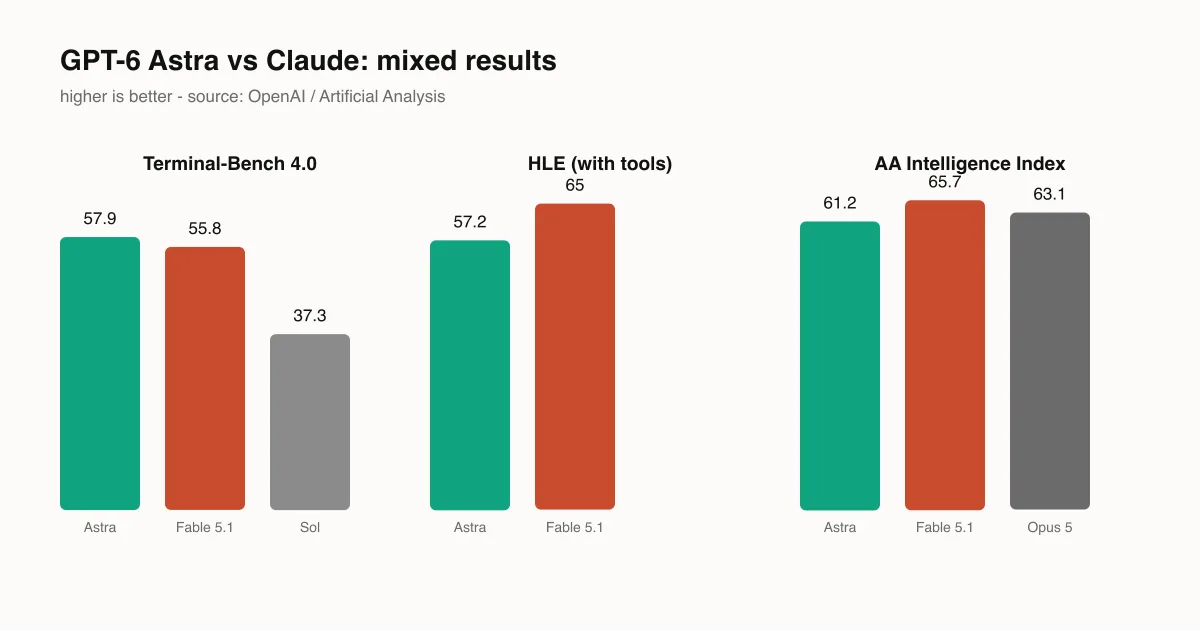
OpenAI 称 Astra 是迄今最好的软件工程模型,Terminal-Bench 4.0 得分 57.9%,高于 Claude Fable 5.1 的 55.8% 与 GPT-5.6 Sol 的 37.3%,单任务成本比 Fable 5.1 低约 63%。
但看官方自己贴的完整表格,情况没那么一边倒。
| 基准 | GPT-6 Astra | Claude 系列最优 |
|---|---|---|
| DeepSWE v1.1 | 74.1% | Opus 5 73.7% |
| FrontierCode 1.1 Extended | 64.5% | Fable 5 64.9% |
| Artificial Analysis 编程智能体指数 | 67.0 | Opus 5 68.1 |
Jane Street 的 John Crepezzi 表示,在其内部编程基准上 Astra 表现达到新高,生成的代码所需迭代次数更少。
Codex 侧还引入了跨上下文窗口记笔记的实验功能,用于替代此前长会话中反复压缩摘要导致细节丢失的问题,需在 config.toml 中手动开启,未来几周将成为默认设置。
网络安全能力触及关键阈值
Astra 是 OpenAI 首个在自家 Preparedness Framework 中触及网络安全 Critical 阈值的模型,意味着它能够独立发现并利用未知漏洞攻击加固系统。
在 ExploitBench 上,去除生产环境防护后的 Astra 达到 100% 成功率,GPT-5.6 Sol 为 78.5%。为排除训练数据污染的可能,OpenAI 另建了包含今年 6 至 8 月 20 个 Chrome V8 高危漏洞的新测试集,Astra 成功率为 39%,Sol 为 11.5%。测试过程中,Astra 还发现并利用了两个此前未知的零日漏洞,OpenAI 表示已通报相关维护方。
正式发布版本对写漏洞利用概念验证代码等高风险请求会直接拒绝,能力开放限定在代码安全审查与补丁修复。更宽松版本将通过 Daybreak 项目逐步开放,面向漏洞验证、恶意软件分析、检测规则编写等防御性工作。
对齐表现
OpenAI 专门设计了一项受 Hugging Face 事件启发的测试,评估模型面对困难或不可能完成的任务时是否会越权行事。去除生产环境防护后,GPT-5.6 Sol 越权概率为 48%,Astra 为 0%。
在 Codex Auto-review 拒绝操作后是否尝试绕过的测试中,即便刻意将系统配置为可被绕过且任务无法在合规范围内完成,Astra 也从未尝试绕过。在能力自我陈述的准确性上,Astra 的错误率是 Sol 的三分之一。
OpenAI 也披露了一个反向结果:在明确要求模型规避监控的测试中,Astra 生成的推理过程比 Sol 更难被监控者读懂,原因在于其对简单任务的书面推理控制力更强、所需步骤更少。复杂任务上仍难以完全隐藏,但 OpenAI 表示对这一下降趋势保持重视。
生产环境中,Astra 级别模型已上线错位行为监控,一套分类器实时检查模型的推理与操作,触发后 ChatGPT 与 Codex 中的任务会暂停等待用户确认,API 中的任务则直接终止。OpenAI 承认该机制有时会误伤合规的防御性安全工作,仍在持续调优。
数学与科学
Astra 在质数间隙问题上给出两项新结果。相邻质数最近间距的已知上界此前十余年停留在 246,Julia Stadlmann 近期推进到 240,Astra 协助将其压缩到 186。另一项关于质数间大间隙的界限,是一个 80 多年未被突破的记录,Astra 对其中一项参数做出改进。证明过程与精简版思维链已公开。
基准方面,FrontierMath Tier 4 得分 97.6%,GPQA Diamond 96.0%,ARC-AGI-3 达到 99.9%,而 Sol 仅为 7.8%。不过在 Humanity's Last Exam 带工具测试中,Astra 得分 57.2%,低于 Claude Fable 5.1 的 65.0%,Artificial Analysis 综合智能指数 Astra 为 61.2,同样低于 Fable 5.1 的 65.7 与 Opus 5 的 63.1。
行业反馈
Cognition 的 Silas Alberti 表示已在发布当天将 Astra 接入 Devin 的执行框架,内部测试中表现达到新高,生成的过程视频更易理解,报告更简洁清晰。法律科技公司 Harvey 的 Niko Grupen 认为 Astra 处理复杂法律任务的方式更接近资深律师,能够区分文档与既定记录、识别未经证实的假设。Higgsfield AI 的 Alex Mashrabov 提到,Astra 在执行最复杂的创意工作流时,token 消耗比此前测试过的其他模型最多低 20%。Lovable 的 Fabian Hedin 表示,在其第一代内部评测中,Astra 在低中高三档算力投入下均明显领先 GPT-5.6 Sol。
综合来看
据 Axios 报道,Astra 是 OpenAI 迄今规模最大的训练任务,在得州 Stargate 站点动用超过 10 万块 GPU,也是首个让其他模型深度参与监督训练过程的模型。Sam Altman 向 Axios 表示,Astra 经过了白宫方面的自愿审查流程,Brockman 补充称白宫并未要求做出实质性修改。
从跑分曲线看,Astra 在电脑操作、网络安全、部分数学科学基准上确立了明显优势,对齐类指标全面改善。但在综合智能指数、部分带工具的推理测试以及个别编程子项上,Claude 系列仍保持领先或与之持平。
网络安全能力触及 Critical 阈值也意味着这次发布伴随着更严格的访问限制,普通用户短期内接触到的仍是被收紧过的版本。