字节笔记本
2026年9月24日 · 约 9 分钟读完
GPT-6 Luna 打到 0.1 刀,但把账算完,DeepSeek 还没输
凌晨,OpenAI 发了 GPT-6 Sol 和 GPT-6 Luna。
距离 Anthropic 发 Opus 5.5,只隔了大概 90 分钟。
先看价格,每百万 Token:
Sol:输入 $2,输出 $10 Luna:输入 $0.1,输出 $0.5
对比 GPT-5.6 那一代,Sol 两头都便宜一半,Luna 输入砍 50%,输出直接砍了 58.3%(来源:VentureBeat)。
而且这次不是限时活动。OpenAI 跟 VentureBeat 确认过,这就是正式价,不是促销价。
所有人第一反应都是:卧槽,比 DeepSeek 还便宜?
我一开始也这么想。 然后我把账从头算了一遍。。。。
其实没怎么变聪明
这次 Sol 和 Luna,其实没怎么变聪明。
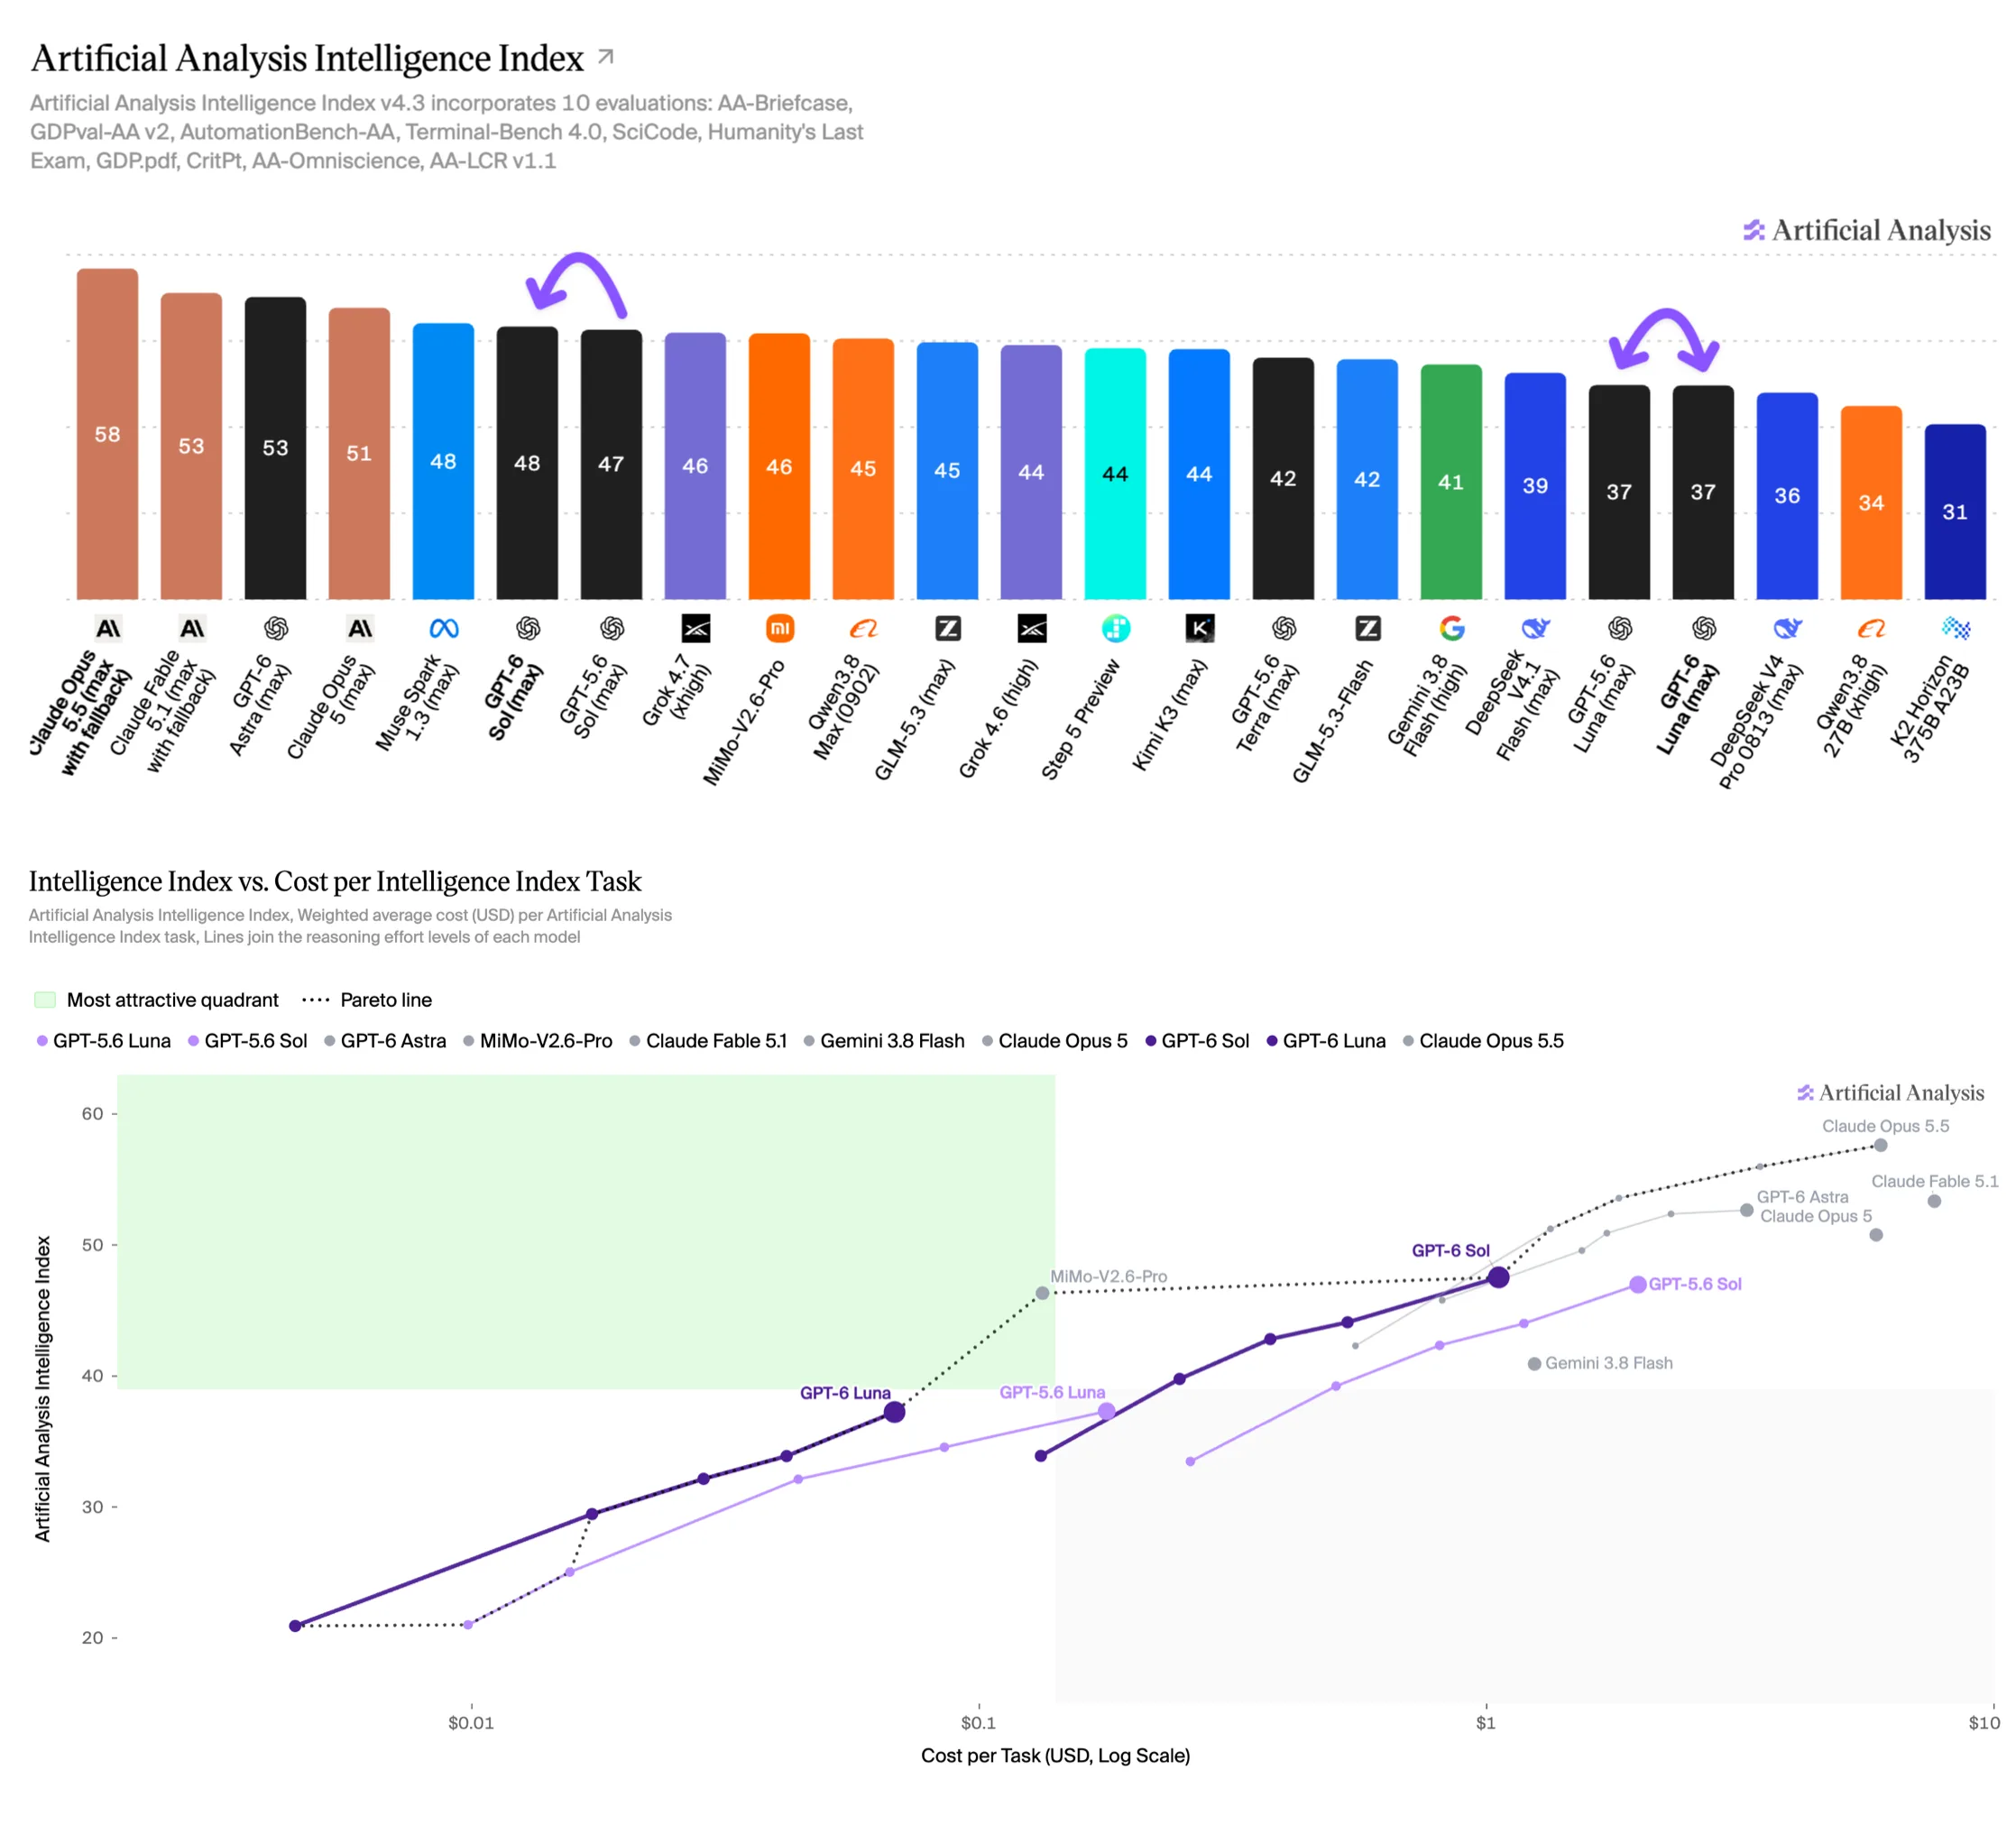
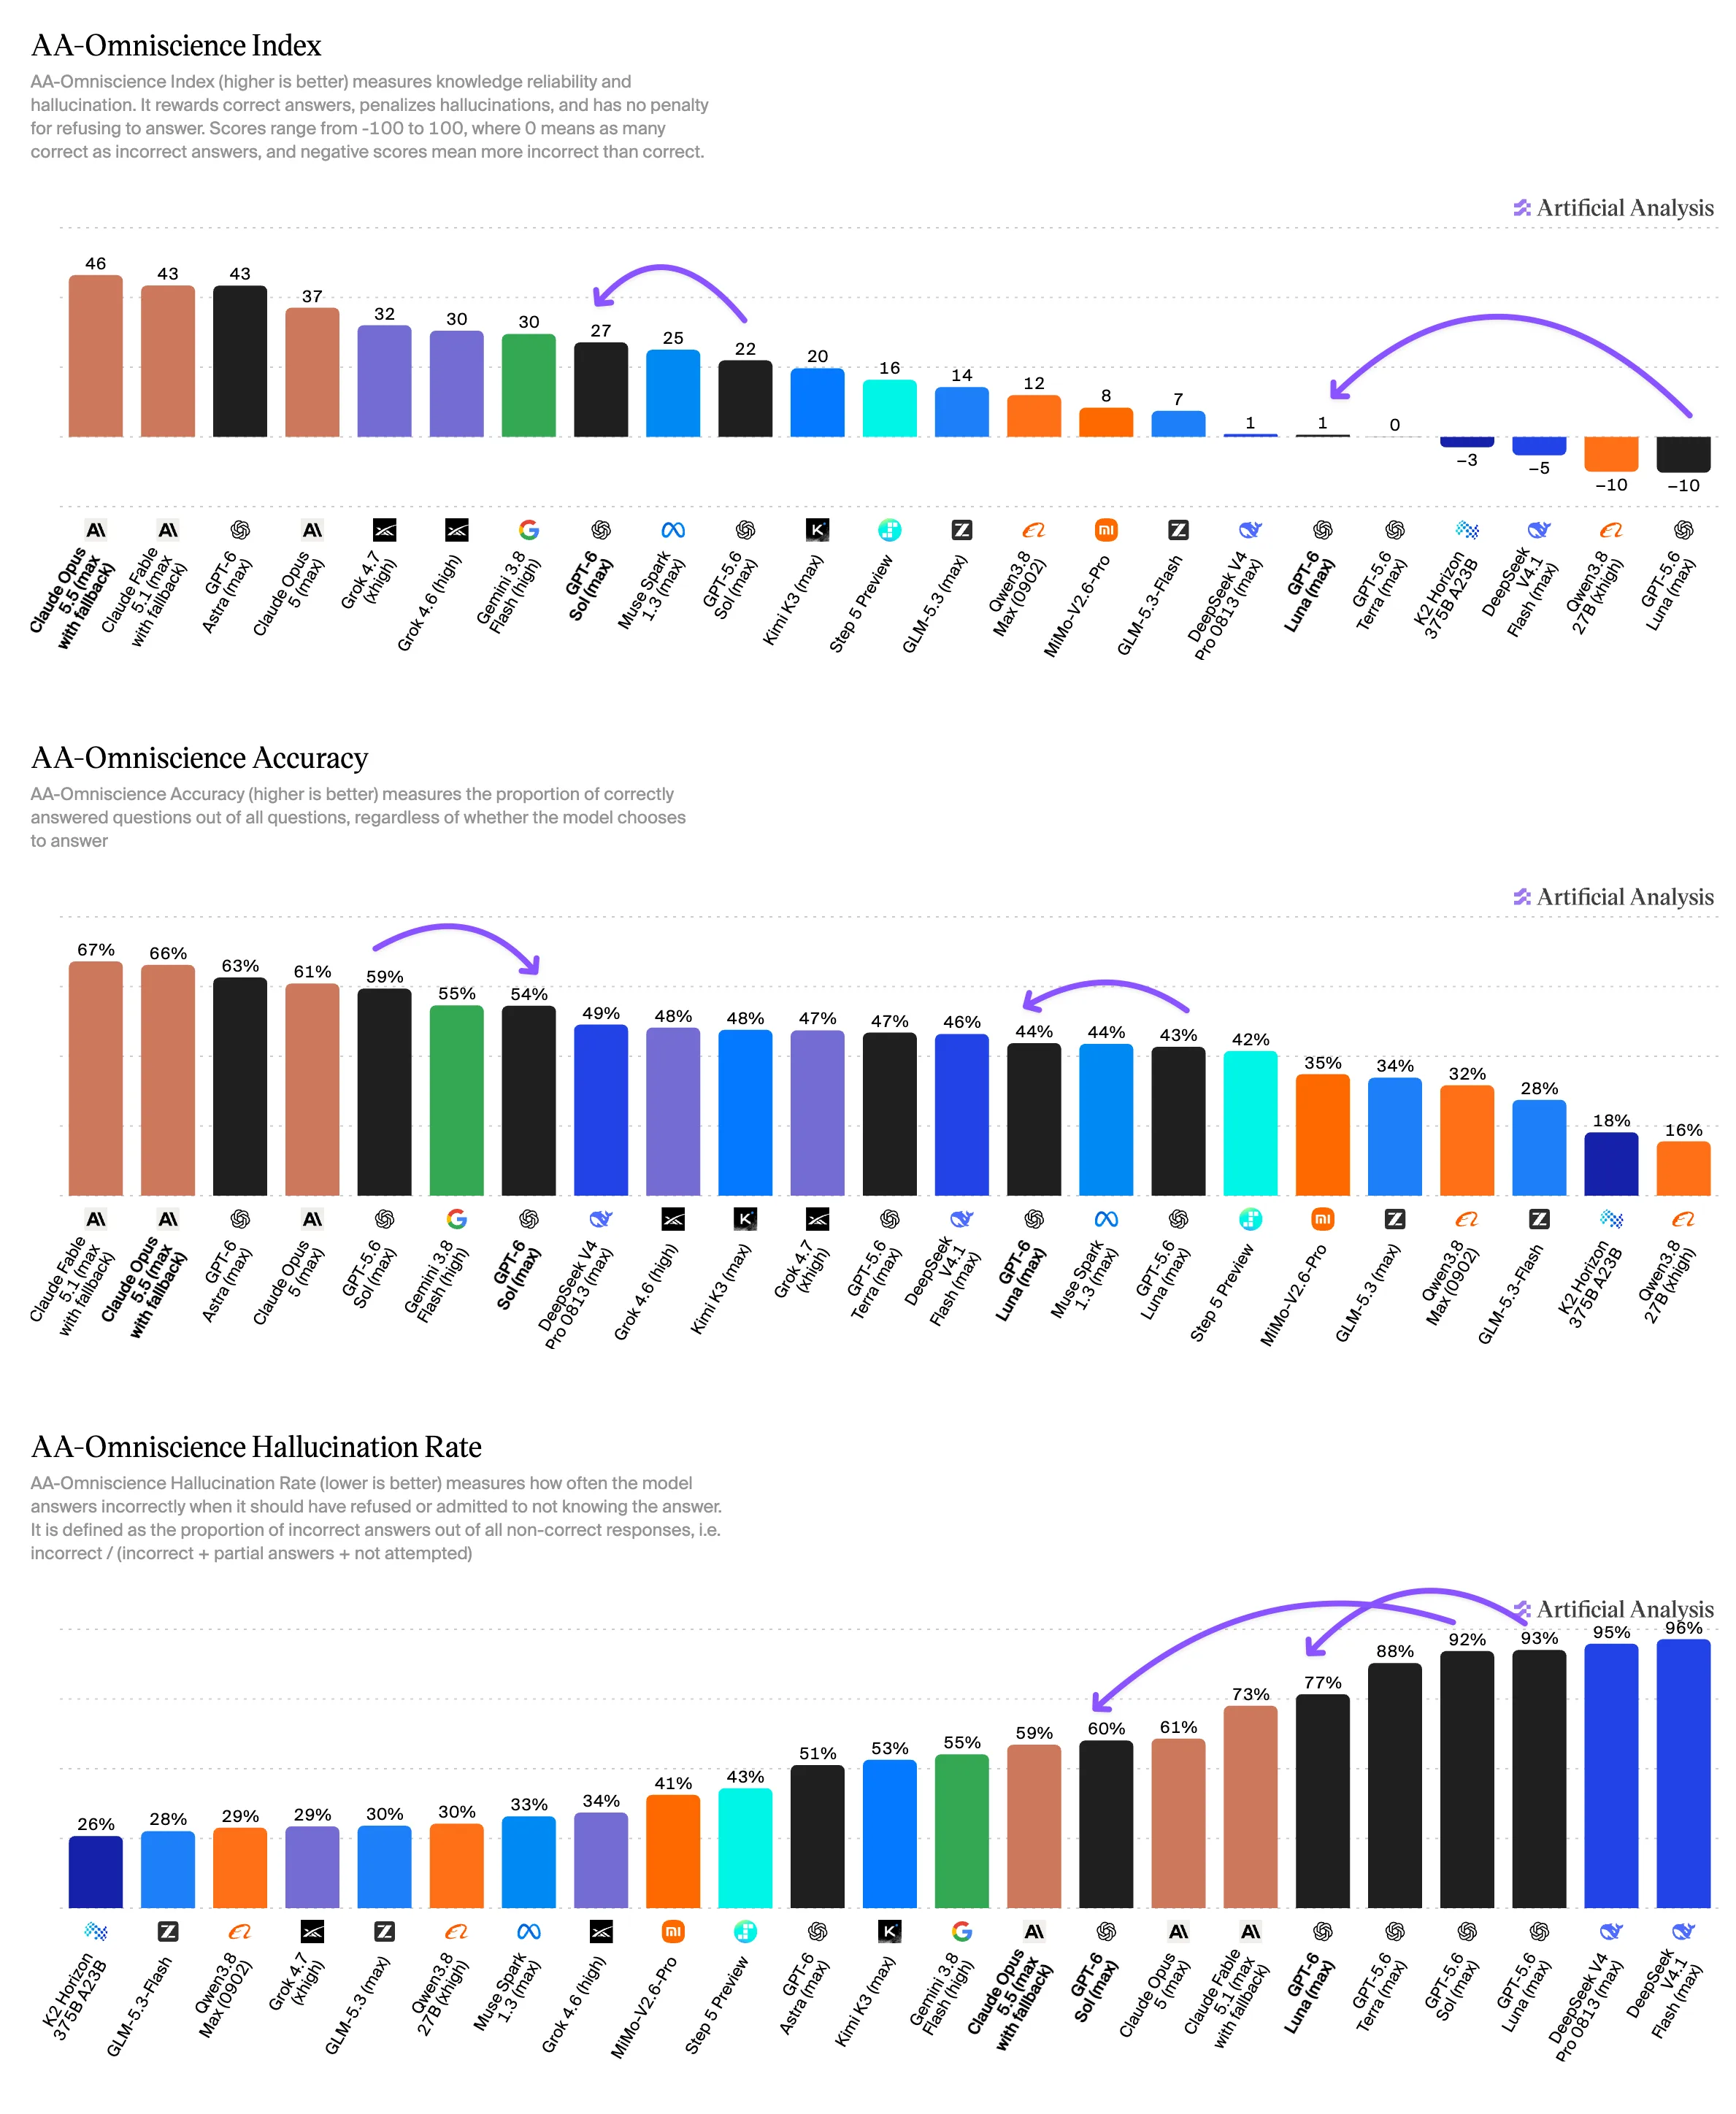
Artificial Analysis 当天就测完了,结论很直白:智能指数和编程 Agent 指数基本和 GPT-5.6 持平,有的项目涨了,有的反而退了。
Luna 最明显,智能指数还是 37 分,和它要替换的 GPT-5.6 Luna 一分不差,编程 Agent 指数还从 43 掉到了 41(来源:OrcaRouter)。
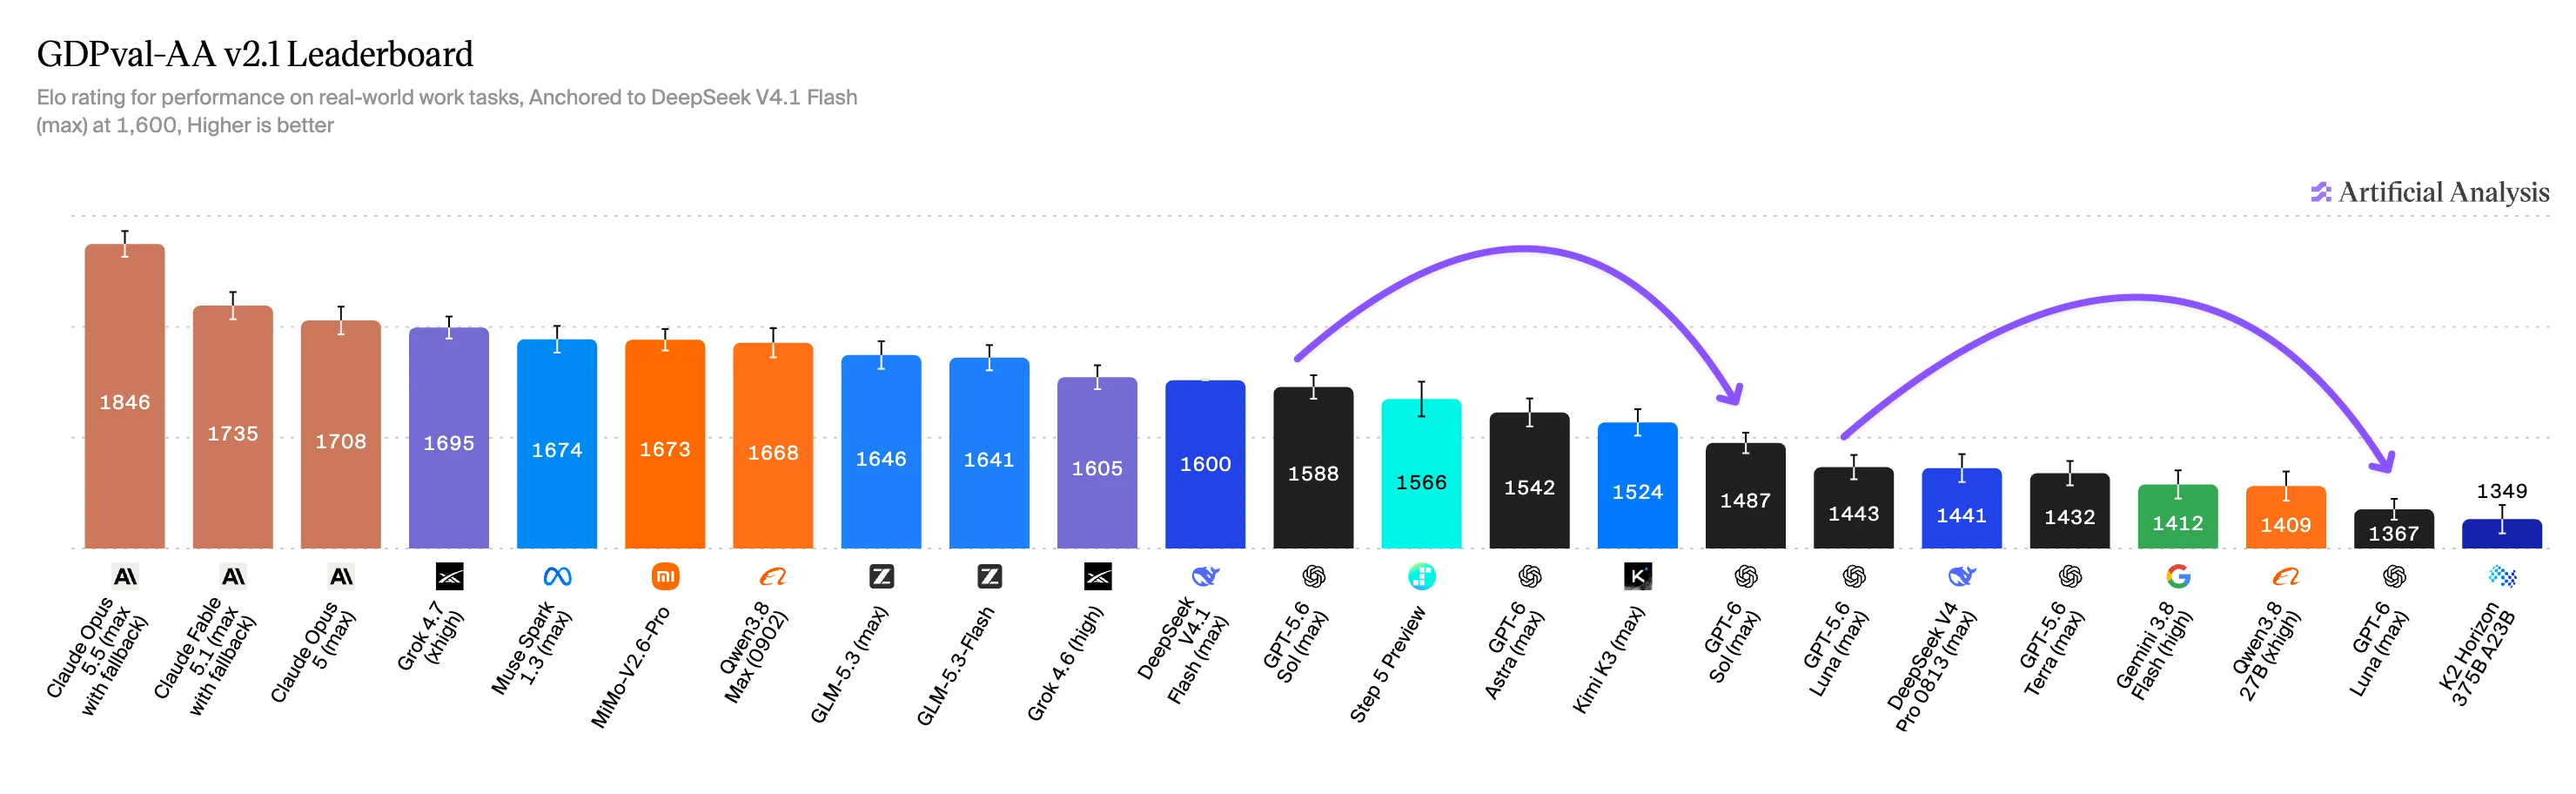
更离谱的是知识工作。 在 GDPval-AA 上 Sol 掉了约 100 Elo,Luna 掉了约 75;AA 人工翻了几百份输出,发现问题出在交付物排版变差、漏掉了评分要求里的内容(来源:Artificial Analysis)。
所以这次的真实定位就是: 同一个脑子,半价卖给你。
那它到底进步在哪?
我觉得最实在的是:不瞎编了。
OpenAI 拿用户真实举报过错误的对话做了一套测试,Sol 犯错的数量大概只有上一代的一半,官方说已经接近 Astra 的可靠性(来源:TechCrunch)。
第三方数据更直观:Sol 的幻觉率从 92% 降到 60%,Luna 从 93% 降到 77%(来源:Artificial Analysis)。
但这里有个细节。 Sol 是靠「不会就不答」做到的。它只尝试回答 83% 的问题(上一代是 99%),错误答案少了约四分之一,但准确率也从 59% 掉到了 54%。
还有一个我觉得更重要的:写代码不撒谎了。
OpenAI 内部的编码欺骗测试里,GPT-5.6 Sol 是 10.4%,GPT-6 Sol 降到 1.3%,Luna 是 2.8%(来源:Decrypt)。
就是那种活没干完、跟你说「已完成」的情况,少了一大截。 天天用 Codex 的人应该懂这个有多重要。
OpenAI 的对比图,和它没画的那个对手
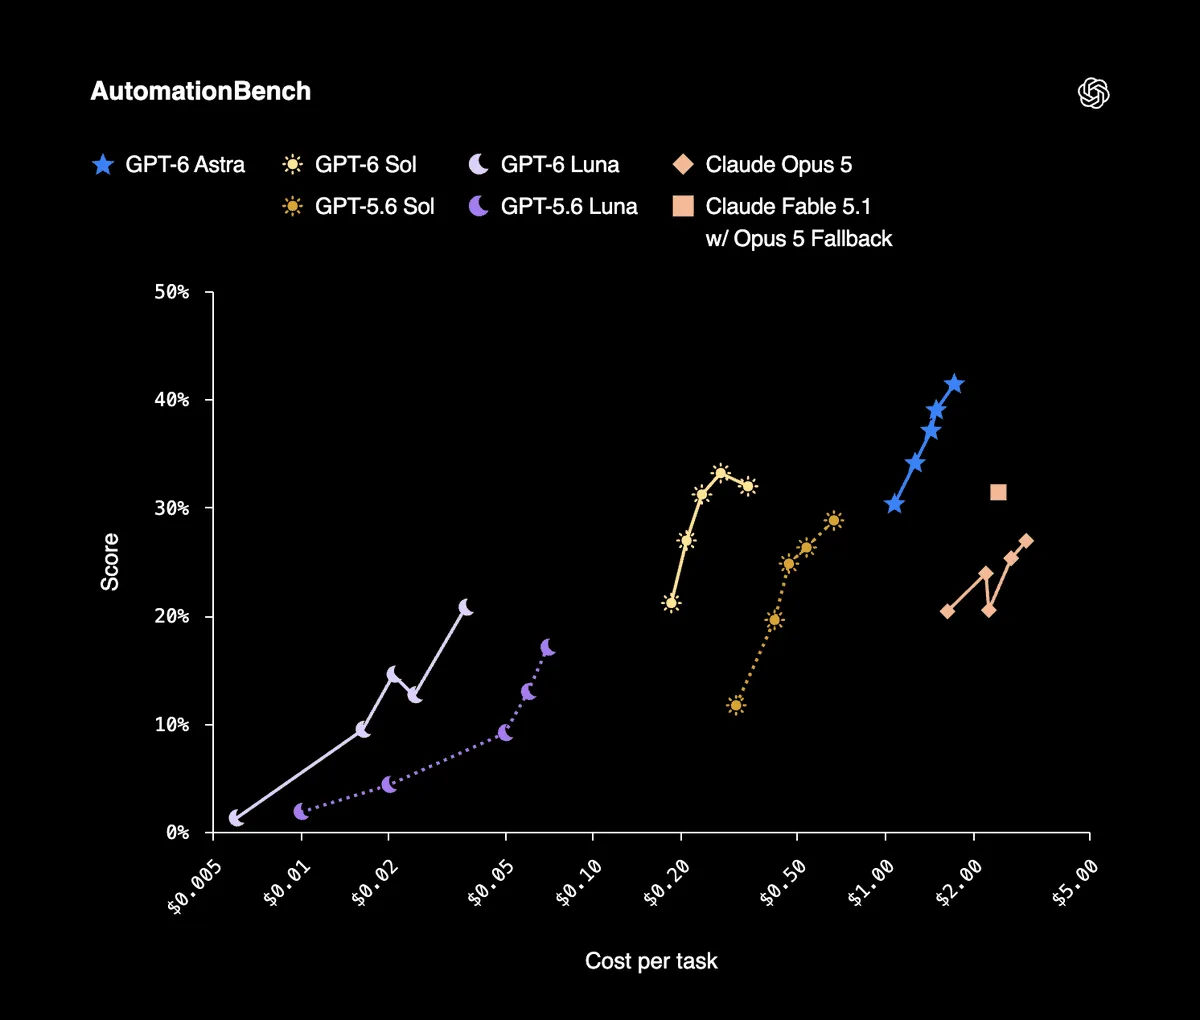
OpenAI 放出来的对比图里全是 Claude Opus 5 和 Fable 5.1。
AutomationBench 上 Sol 开 xhigh 拿了 33.2%,单任务 $0.27;Opus 5 开满才 26.9%,成本是 Sol 的 11.1 倍。 DeepSWE v1.1 上 Sol 满档 68.8%,离 Fable 5 的 69.9% 只差 1.1 分,单任务成本便宜大约 80%(来源:OpenAI)。
看起来很猛对吧。
但问题是,90 分钟前刚发的 Opus 5.5,不在图里。
AA 的榜上,Opus 5.5 以 58 分排第一,Fable 5.1 和 GPT-6 Astra 都是 53,GPT-6 Sol 满档是 48(来源:OrcaRouter、Unite.AI)。
有第三方把档位拆开对比过:Sol 除了 max 以外的每个档位,都比 Opus 5.5 最便宜的档位还便宜;Sol 开 xhigh(44.1 分,$0.53)能小胜 Opus 5.5 的 low 档(42.3 分,$0.55);但 Opus 5.5 从 medium 往上,Sol 开到顶都够不着(来源:Digital Applied Team)。
然后是最关键的:算账。
标价上,Sol 确实是 Opus 5.5 的一半。 但 Agent 跑起来,钱主要花在缓存读取上。
Sol 的缓存读是 $0.2。 Opus 5.5 的缓存读……也是 $0.2(来源:Digital Applied Team)。
一模一样。
还有一个坑:OpenAI 对超过 272K 输入的请求,输入和缓存价格翻倍、输出乘 1.5;Anthropic 整个 1M 窗口都按标准价收。
你要是那种一个 session 动不动塞几十万上下文的重度 Agent 用户,这个「半价」很可能根本感受不到。
Luna vs DeepSeek:把账算完
标价上 Luna 确实赢了。 DeepSeek V4.1 Flash 闲时是:缓存命中 $0.003,未命中 $0.15,输出 $0.6。 Luna 是输入 $0.1、输出 $0.5。两项都比 DeepSeek 闲时价低(来源:TechBriefly)。
但缓存这一项,OpenAI 给的是 9 折优惠,也就是 Luna 缓存读 $0.01。 DeepSeek 是 $0.003。 差了三倍多(来源:Artificial Analysis)。
拿同一个场景算一下: 一个 Agent 一天跑 2000 万 Token 上下文,97% 命中缓存,输出 50 万 Token。
- Luna:约 $0.52
- DeepSeek V4.1 Flash 闲时:约 $0.45
- DeepSeek V4.1 Flash 高峰:约 $0.90
- (参照:Sol 约 $10.4,Opus 5.5 约 $16.9)
看出来了吧。 Agent 一跑起来,Luna 和 DeepSeek 闲时基本打平,DeepSeek 甚至还便宜一点。
但是!
DeepSeek 的高峰时段是周一到周五 UTC 01:00-04:00 和 06:00-10:00,高峰价翻倍(来源:TechBriefly)。
换成北京时间: 上午 9 点到 12 点,下午 2 点到 6 点。
就是你上班写代码的时间。。。。
当然,能力上 DeepSeek 还是占上风的。
DeepSeek V4.1 Flash 自报 DeepSWE v1.1 是 74.2,Terminal-Bench 4.0 是 31.2。 OpenAI 报的 Luna 满档 DeepSWE 是 66.6%,AA 自己测出来只有 64%;Terminal-Bench 4.0 上 AA 测 Luna 是 13%。
(测评环境不完全一样,只能当参考。但这个差距不算小。)
真正变了的是什么
结论其实挺反直觉的:
Luna 没有把 DeepSeek 打穿。 DeepSeek 的缓存价,还是那道墙。
Sol 也没有把 Opus 5.5 打穿。 缓存价一样,长上下文还要加钱。
真正变了的是:OpenAI 开始认真拼价格了,而且是正式价。
以前大家默认,美国模型卷能力,国产模型卷价格。 现在 OpenAI 两头一起卷。
下周二 29 号就是 OpenAI DevDay。 DeepSeek 会不会再砍一刀?(来源:Pulse 2.0)
one more thing
有网友问 Sol 是不是 Terra 换壳。 其实这一代压根没有 Terra,目前还没有 GPT-6 Terra(来源:The New Stack)。
另外,两个模型今天起在 ChatGPT Work 和 Codex 对 Plus、Pro、Business、Enterprise、Edu 用户开放,免费用户和 Go 用户可以在桌面端用 Luna;API 里叫 gpt-6-sol 和 gpt-6-luna。GitHub Copilot 也同步上了(来源:OpenAI)。
数据口径说明:DeepSeek 的 74.2 和 31.2 是它自己发布时报的数,OpenAI 的图也是自家数据,只有 Artificial Analysis 的数字是第三方统一测的——正文里来源都点名了。