
字
字节笔记本
2026年10月6日 · 约 2 分钟读完
循环里出错的 token,对比着挑出来
API中转
¥120
循环语言模型是一支小众但值得盯的路线:用共享权重递归精修内部表征,把推理做在潜在空间里。Apple 的 Byeongho Yu 等人九月提交的 LoopCD(arXiv:2609.24196)刚入选 EMNLP 2026 主会,给这条路线补了一块重要的质量拼图。
病根与药方
论文的观察很锋利:LoopLM 跨迭代的不稳定精修,会在个别位置产生局部高不确定性的难 token,而这些 token 与推理错误强相关。药方叫循环级对比解码:采样时把早期迭代的 logits 与最后一轮精修的 logits 做对比,用差异修正输出分布。整个干预发生在推理期,不动权重、不加训练、开销可忽略。论文页确认的效果是在多个代表性 LoopLM 上,算术推理、代码生成与问答一致提升。
据 Latent Space 周报的口径,AIME 2024 上 pass@1 从 61.88 提到 73.33,同时循环长度减半,质量与算力两头赚。两个口径来源不同,文中分开标注;论文页未见代码链接。
放进本周脉络
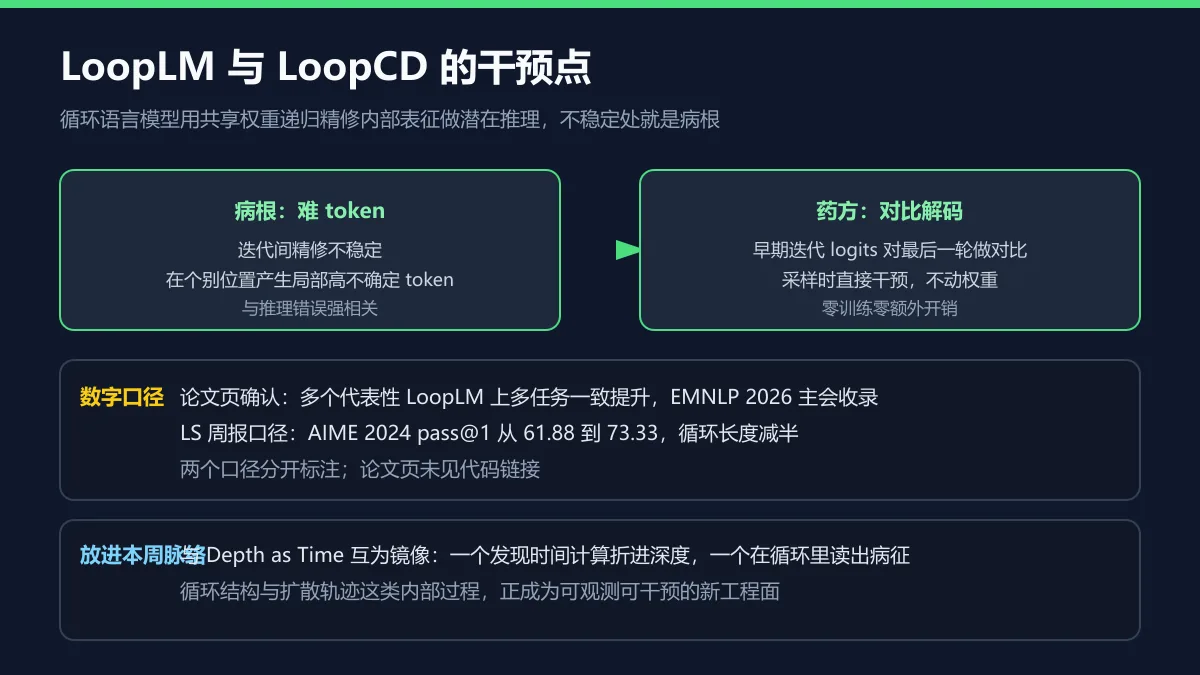
有意思的是它与本站前几天写过的 Depth as Time 恰成镜像。那一篇发现扩散模型的时间计算折进了网络深度,可以逐层解码;这一篇发现循环模型的病征写在迭代间的 logits 里,可以对比读出。两篇合起来指向同一件事:模型内部的中间过程正在变成可观测、可干预的工程面,以前只能靠重训解决的问题,现在越来越多能在解码层动手术。
对做推理服务的团队,这是又一条零成本涨点的候选路径:如果你的模型带迭代或自精修结构,LoopCD 的对比解码思路值得一试,哪怕只是离线评测里验证一遍难 token 假设。
相关文章
分享: