
字
字节笔记本
2026年10月1日 · 约 2 分钟读完
Magnitude:在你的硬件上现场编译内核,比 llama.cpp 快 2 倍
API中转
¥120
本地跑开源模型的推理引擎 llama.cpp 一直是默认选择,但一个叫 Magnitude 的开源项目(6 千星,Rust,Apache-2.0)声称能在你的硬件上比 llama.cpp 快最多 2 倍。秘诀不是更聪明的算法,而是"在你的设备上现场编译和调优内核",同一个模型,换台机器就要重新调一遍。
为什么更快
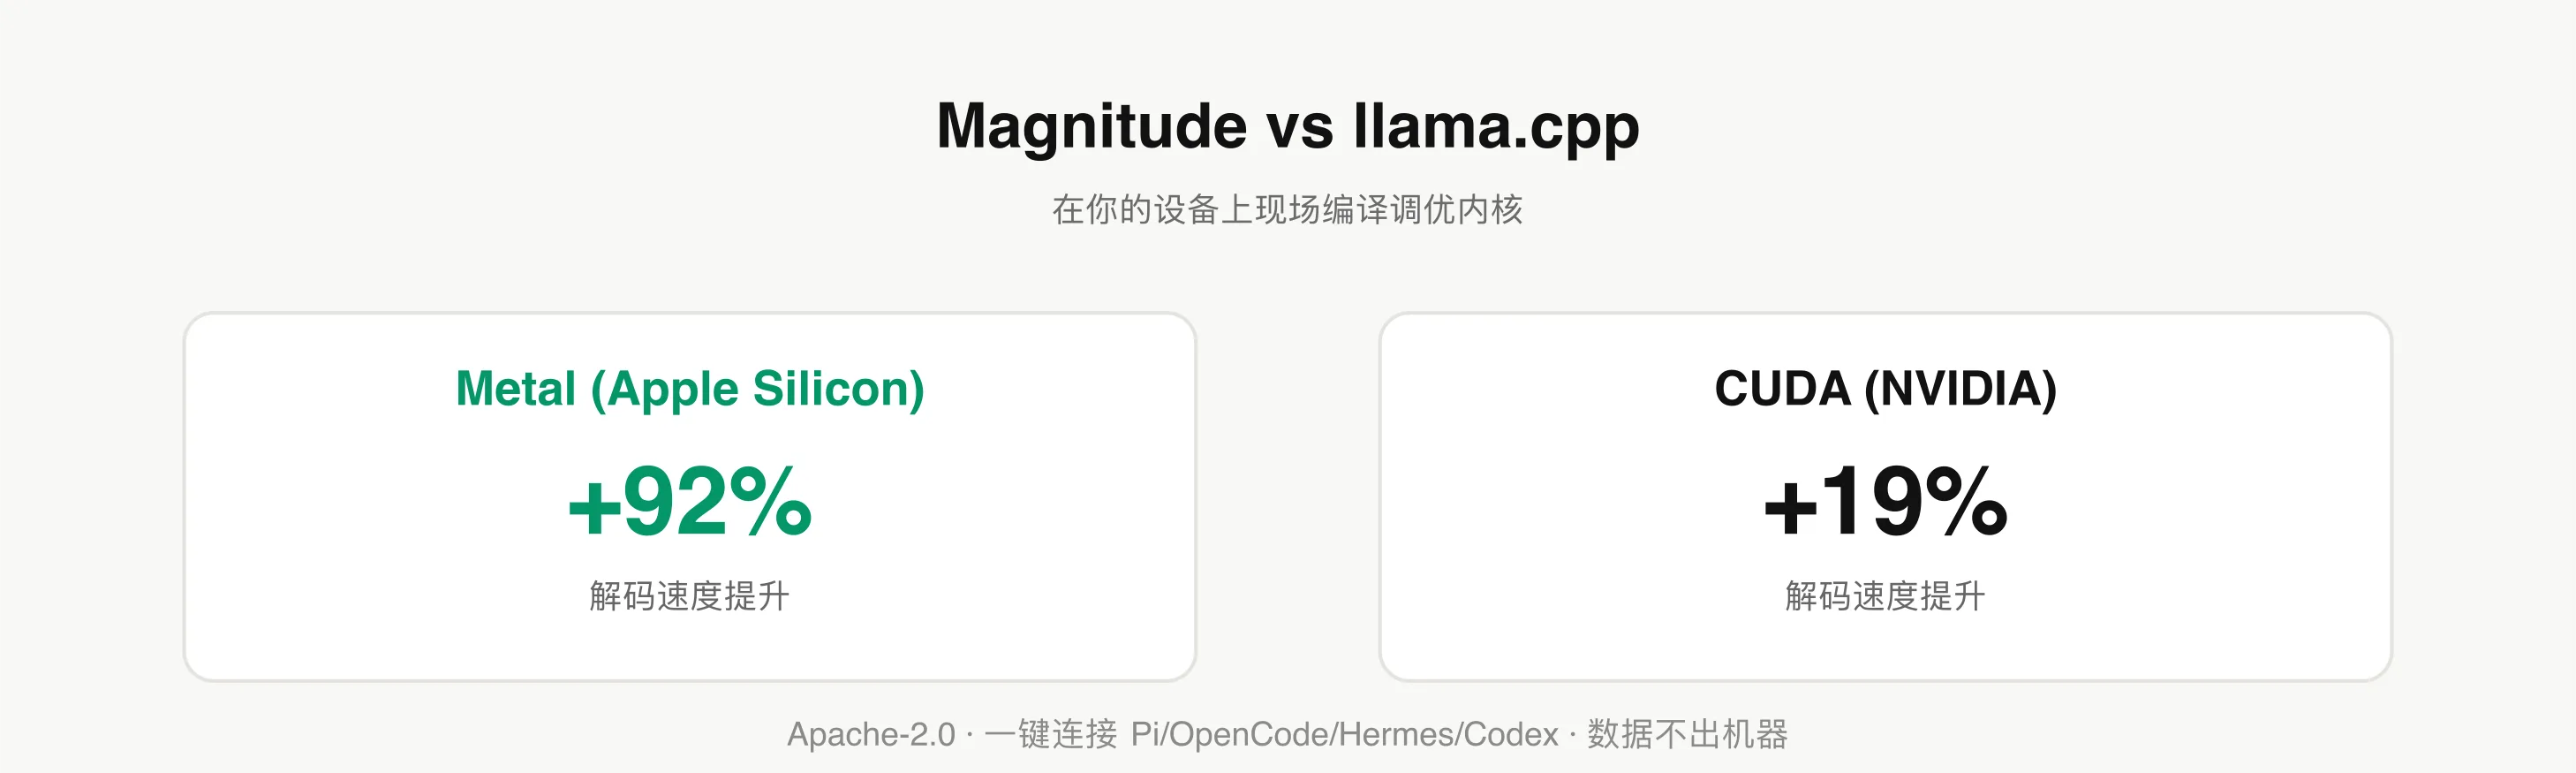
传统推理引擎为了兼容性,内核(kernel)是预编译好的通用版本。Magnitude 换了个思路:安装后先扫描你的具体硬件(Apple Silicon、NVIDIA、AMD 或纯 CPU),然后在你的设备上现场编译调优内核,让每个矩阵乘法都吃到你的硬件特性。实测数据:Metal 上解码快 92%,CUDA 上快 19%。
快速上手
- 从 magnitude.dev/download 下载桌面应用(macOS/Windows/Linux);
- 在 Discover 页选一个推荐模型下载;
- 在 Connections 页一键连接你已有的 agent。
支持的 agent 包括 Pi、OpenCode、Hermes、Codex 等,一键接入无需改配置。
适合谁用
Apple Silicon 用户:Metal 92% 的解码提升是所有平台里最显著的,M 系列芯片的本地推理体验会有质的变化。
跑多个 agent 会话的用户:27% 更省内存、会话间共享前缀缓存防止减速,多 agent 并行不再是内存噩梦。
隐私优先的团队:Apache-2.0 开源、零 token 费用、数据不出机器。
对比 llama.cpp:llama.cpp 的优势在广度和社区(几乎所有模型架构都支持),Magnitude 的优势在深度(对热门开源模型家族做手工内核优化)和 agent 集成(一键连接已有编码 agent)。如果你只用几个固定模型跑 agent,Magnitude 的硬件调优路线值得一试;如果模型换得勤,llama.cpp 仍是更稳的默认。
相关文章
分享: