字节笔记本
2026年9月28日 · 约 5 分钟读完
科研里最累的不是想法:这个开源工作台把读文献跑实验全接了
读文献、洗数据、复现别人的结论、扫参数跑实验——科研里最熬人的从来不是那个想法,而是想法周围的一圈苦活。YC 孵化的 Synthetic Sciences 把这套活交给了一个开源科研工作台 OpenScience:你用大白话描述目标,它自己查文献、写代码、跑实验、最后把发现写成报告,而且每一步都留痕可查。项目在 X 上官宣后拿到了五百多赞、近二十万浏览,Apache-2.0 协议开源,发文时星标约 3.7 千。
项目简介
OpenScience 的定位是"带工作台的科研 agent"。它可以装成桌面应用(macOS、Windows、Linux),也可以跑在浏览器工作区里,或者就是一个终端命令,全部在你自己的机器上、对着你自己的文件干活。
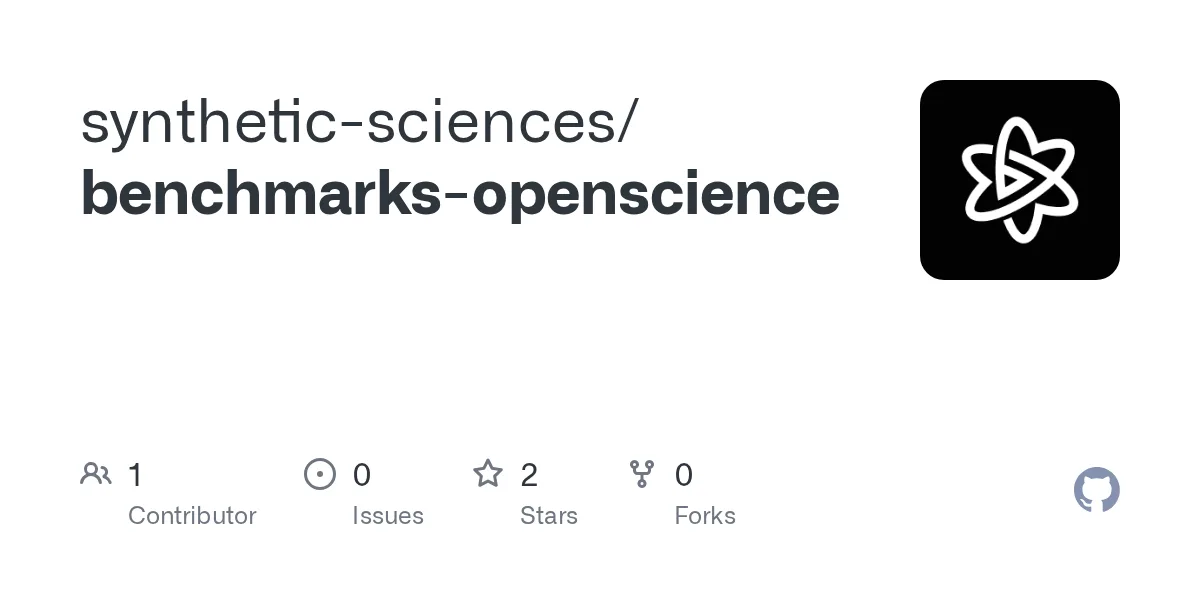
它和普通编码 agent 的区别在两件事。第一是每一步可见:一轮任务读下来,它想过什么、搜了什么、执行了什么、写了哪些文件,像实验记录本一样摊开,没有任何你看不到就跑掉的操作。第二是科研工具链原生:内置 Shell、Python、R 三种内核和 notebook,文件系统带显式的读写授权,笔记本算力不够还能挂远程计算;官方捆了数百个覆盖生物、化学、物理、机器学习和数据工程的技能包,并能直连 ChEMBL、UniProt、PubMed、arXiv 这些数据库。
架构上,主 agent 可以把拆好的边界任务并行派给多个 worker,但综合结论和最终判断权始终留在主 agent 手里。模型完全自带:填自己的 API key、登录支持的订阅、接 Ollama 本地模型都行,官方也提供按量付费的 Ace 托管选项。
成绩单
官方 README 给出的基准成绩:Terminal-Bench Science(70 题)拿下 75.7%,Terminal-Bench 4.0 科学子集 10/14(71.4%),BiomniBench-DA(公开 50 题)82.2。按官方在 X 上的对比帖,前两项分别高于 Codex 加 GPT-6 Astra 的 68.1% 和 Claude Code 组合的 60.0%——每一次计分试验的轨迹都放在 benchmarks-openscience 仓库里可以复查。数字是官方自报,好在全程可复现,这点比结论本身更有意思。
快速上手
npm 全局安装后直接启动:
npm install -g @synsci/openscience
openscience
不想装也可以免安装运行 npx synsci,macOS 和 Linux 还有独立安装脚本:
curl -fsSL https://openscience.sh/install | bash第一次用先接模型,自己的 key 或本地端点都行:
openscience keys add    # 填 API key
openscience local add   # 接 Ollama、LM Studio 等本地模型
然后打开一个项目目录,用大白话派活:
openscience ~/research/my-project检查 data/samples.csv 里的缺失值和标签不一致问题。
不许改原始数据。把质量报告和图存到 results/,附上可复现代码。想先对齐方案再动手,输入 /plan;要接进脚本或流水线,用 openscience run "任务" 单轮执行,加 --continue 接着上一轮继续。
适合谁用
科研工作者:文献调研、复现一篇论文的结论、参数扫描、方法节初稿、参考文献核查,这些"真活但不是想法"的部分正是它的主场,你保留想法和判断。
实验室与团队:每步留痕的设计天然适合需要审计和可复现性的场景,报告给导师或评审前,轨迹本身就是过程证据。
agent 工程师:显式授权的文件系统、主从 agent 分工、技能包组织方式,都是值得借鉴的工作台设计。
一句提醒,也是官方反复强调的:依赖它的结论前,务必复查它的来源、假设、代码和输出。agent 把科研的苦活接走了,但科学判断还得留在你手里。