字节笔记本
2026年10月6日 · 约 2 分钟读完
不做向量检索,让 LLM 像人一样翻目录
向量检索的隐含假设是相似等于相关,但在财报、法律文书、技术手册这类长专业文档里,这个假设经常失效:答案所在段落可能和问题字面毫不相似。GitHub 周榜新面孔 VectifyAI/PageIndex(38.8k stars,周增 2,860,MIT 协议)干脆把向量扔了,做了一套无向量、靠推理的 RAG。
项目简介
PageIndex 的灵感来自 AlphaGo:不用检索近似,用推理搜索。索引侧,每份文档生成一棵层级树索引,树结构直接来自文档版式,不需要 LLM 参与,索引模型只负责摘要与提炼;检索侧,LLM agent 沿树推理下行,就像人翻开年报先找章节再找小节。README 的对比表写得很清楚:树索引对向量索引、推理检索对相似检索、可回溯的显式引用对黑盒输出、完整上下文(对话历史加领域知识)对单一查询嵌入。
三笔账
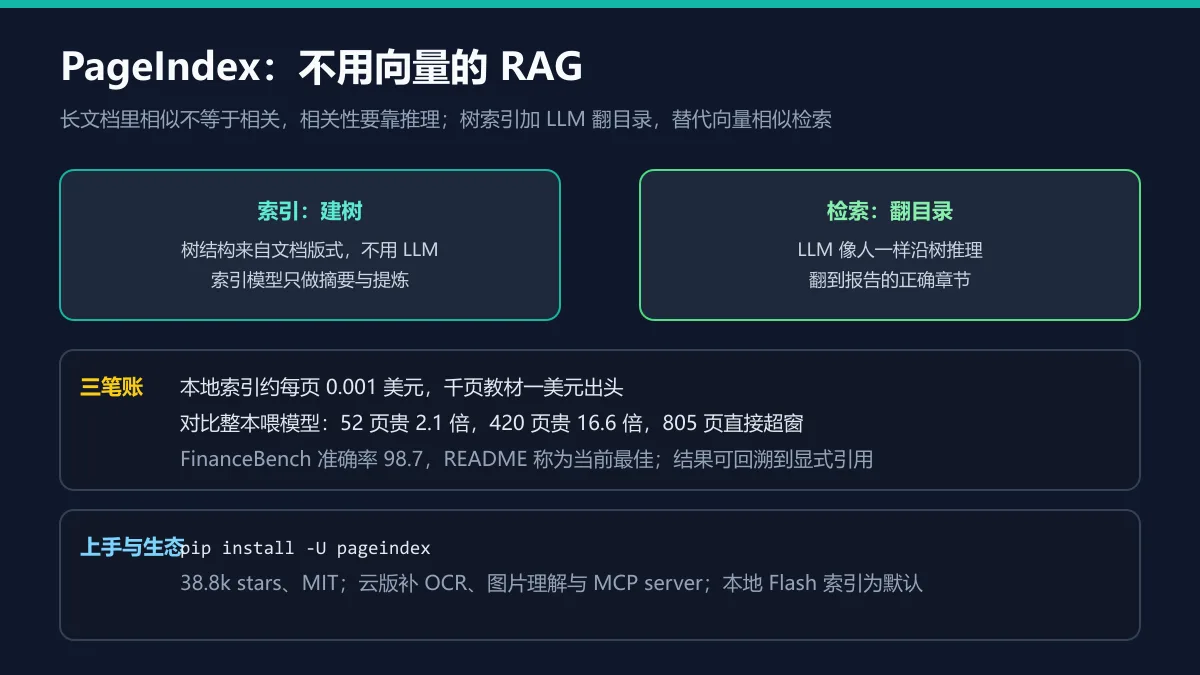
成本账:本地索引约每页 0.001 美元,一本千页教材一美元出头;对比把整份 PDF 直接喂模型,52 页时贵 2.1 倍,420 页时贵 16.6 倍,805 页直接超出上下文窗口。速度账:9 到 1,098 页的文档,索引耗时 13 秒到 4 分半。质量账:FinanceBench 准确率 98.7,README 称为当前最佳。
快速上手
pip install -U pageindex用 PageIndexClient 配一个 OpenAI key,提交 PDF 拿到 doc_id 后直接 client.chat 提问。官方建议索引用基础模型省钱、问答用能负担的最好模型。本地模式处理文本型 PDF,PageIndex Cloud 补上 OCR、图片理解、块级引用与 MCP server;八月更新加入了 Flash 快速树索引(现为本地默认)、文件系统级的语料索引与文档分析应用。
适合谁用
处理长专业文档的场景是主场:金融研究、法务尽调、医疗文献、教材知识库。与站内写过的 CANOPY(多模态证据压缩)、MRVQ(弹性向量索引)放在一起看更有意思:向量路线在卷压缩与档位,PageIndex 直接换了赛道,两派在长文档场景必有一战。98.7 的口径来自 README 自述,落地前建议用自家文档先跑对照。