字节笔记本
2026年10月1日 · 约 4 分钟读完
最好的代码是你没写的那行:14.9 万星插件教 agent 偷懒
你肯定认识这样一位同事:马尾辫、椭圆眼镜、入职比版本控制还早。你给他看五十行代码,他什么也不说,然后换成了一行。GitHub 上 149 千星的项目 Ponytail 把这位"最懒的资深工程师"塞进了你的 AI agent:MIT 协议,npm 一条命令安装,兼容 20 个 coding agent。
它解决什么
让 AI 写代码的另一个副作用开始显现:过度构建。你要个日期选择器,agent 会安装 flatpickr、写一层包装组件、加一套样式表,顺便发起一场关于时区的讨论。Ponytail 的版本是:
<!-- ponytail: browser has one -->
<input type="date">
数字是诚实的
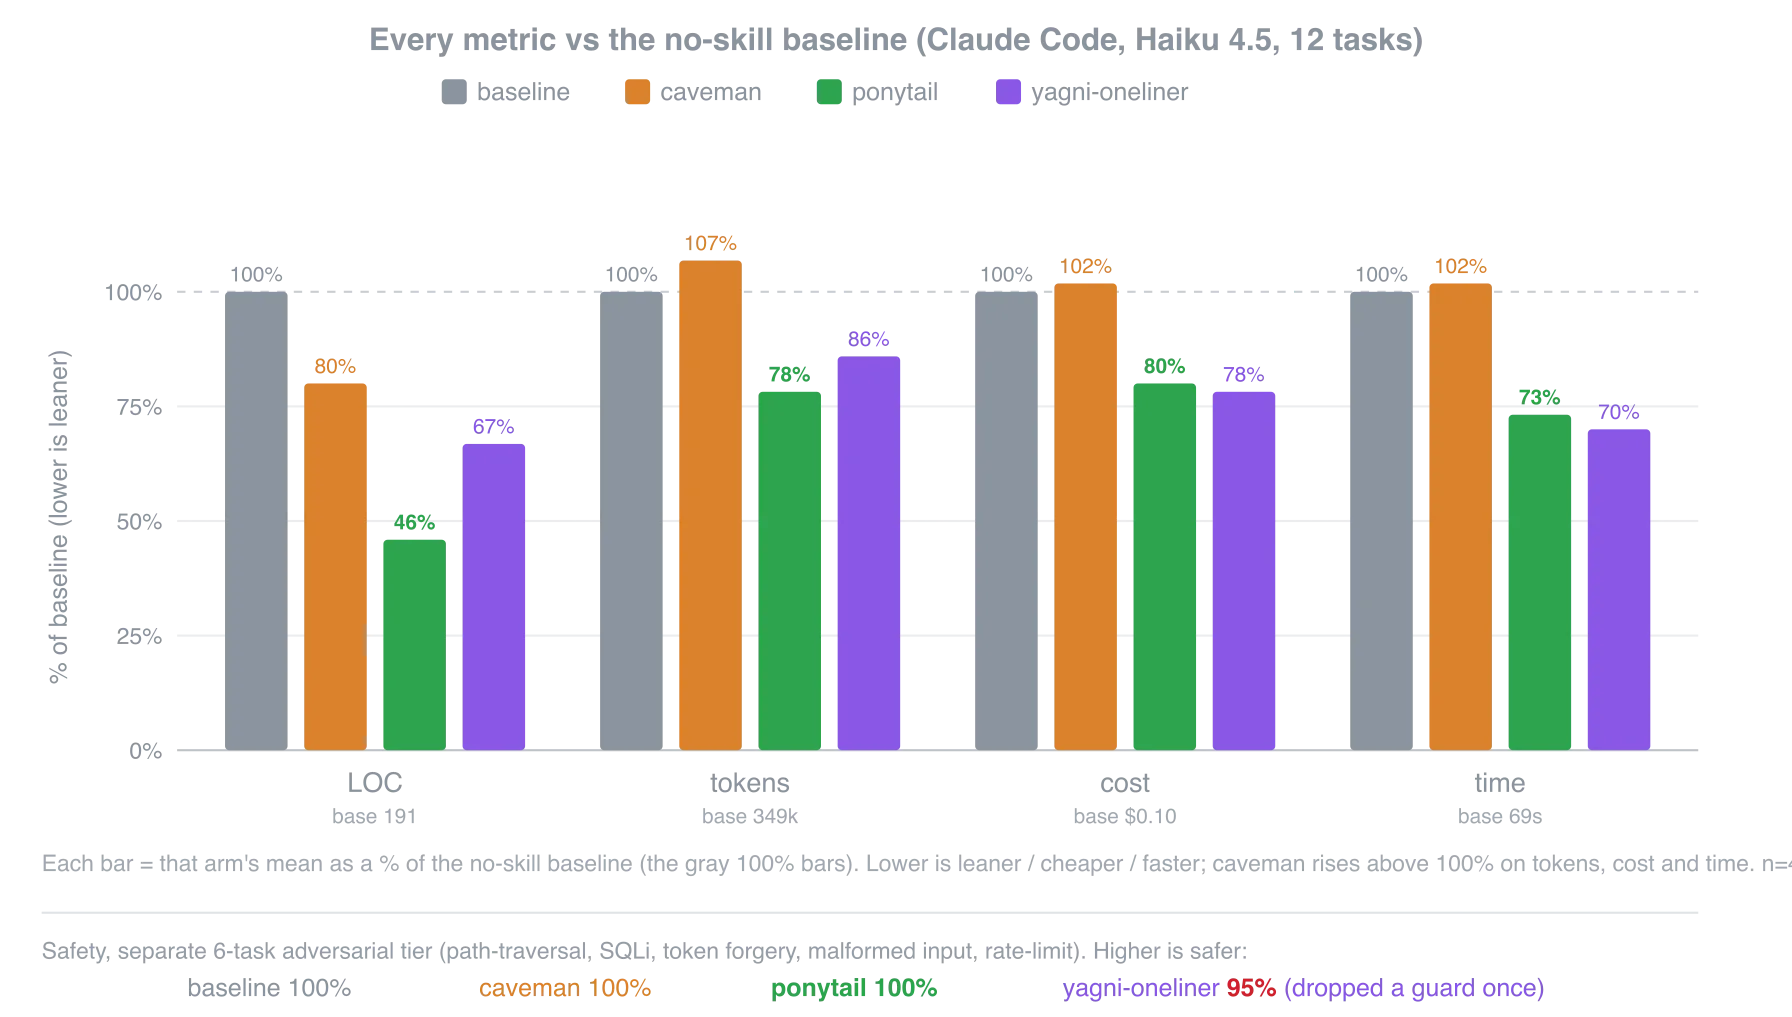
这类项目最容易被质疑"数据是不是挑过"。Ponytail 的做法反而值得学习:作者把早期"减少 80-94% 代码"的单轮基准主动撤了(社区 issue 指出裸模型基线爱写废话,差距部分来自对话基线的失真),换成更严格的 agentic 口径:无头 Claude Code 在真实的 FastAPI + React 仓库上做 12 个功能任务、n=4、按 git diff 评分:
| 对比无技能基线 | 代码行 | token | 成本 | 耗时 | 安全 |
|---|---|---|---|---|---|
| ponytail | -54% | -22% | -20% | -27% | 100% |
| caveman(简洁提示对照) | -20% | +7% | +3% | +2% | 100% |
| "YAGNI+单行"提示 | -33% | -14% | -21% | -30% | 95% |
它是唯一一项指标全降且安全分满分的方案。过度构建陷阱越明显(日期选择器 404 行砍到 23 行,因为原生 <input> 就够),砍得越狠;代码本已精简处接近零收益。基准方法和逐任务数据全部公开可复现。
原理:七级懒惰阶梯
写代码前,agent 先停在能解决问题的最低一级:这功能需要存在吗(YAGNI)→ 代码库里已有吗 → 标准库有吗 → 平台原生有吗 → 已装依赖里有吗 → 一行能写吗 → 都不行,才写最小实现。阶梯在理解问题之后跑:先读要改的代码、追真实调用流,再选级。对方案懒惰,对读代码从不偷懒。
边界同样清楚:信任边界校验、数据丢失处理、安全、无障碍永远不在砍削范围;"最少 token"从来不是目标,代码小是因为必要,不是打高尔夫。有个反例值得记:在 GPT-5.5 这种爱用思考 token 反复斟酌阶梯的模型上,效果可能反向。
快速上手
Claude Code 两条命令:
/plugin marketplace add DietrichGebert/ponytail
/plugin install ponytail@ponytail
Codex 有插件版,Cursor 走 hooks,共支持 20 个 agent;Claude Code 和 Codex 的插件会跑两个轻量 Node 生命周期钩子(PATH 里要有 node)。MIT 协议,npm 包 @dietrichgebert/ponytail。
适合谁用
被 agent"热情过度"坑过的人:它把"少写代码"从一句提示词咒语变成了带阶梯、带守则、带可复现基准的工程实践;对照实验里连"简洁提示词"对照组都会掉安全分,这个细节足以说明光喊口号不够。
关心账单的团队:-20% 成本加 -27% 耗时是等比例降本的曲线。
做 agent 技能的作者:它公开基准、公开撤榜原因、公开对照实验的做法,是目前技能类项目里评测透明度的天花板。
一句话总结:它教的不是新语法,而是那句话,最好的代码是你永远不用写、但依然能验收的那行。