字节笔记本
2026年9月26日 · 约 5 分钟读完
千问 3.8 27B 本地部署:配置怎么抄,坑在哪里
8 月 14 号千问 3.8 27B 正式开源,这几天各路硬件平台的实测已经刷屏。这篇从本地部署和硬件配置的角度把事情捋清楚,文末有配置抄作业清单。
先搞清一个前提:它是稠密模型
千问 3.8 27B 是稠密模型,不是 MoE——每生成一个 token,270 亿参数全部参与计算,不像有些模型看着参数大、其实每次只激活一小部分。
所以跑这玩意儿,比的第一是显存带宽,不是显存容量。Mac 和 DGX 这类统一内存方案的小主机,内存带宽只有 200 多 GB/s,应对稠密模型比较吃亏。后面看实测数据时,心里要提前有这个预期。
AI 给的配置方案为什么不能直接抄
让 AI 出一套完整配置(CPU 到显卡到内存),乍一看挺全,实际有几个坑:
- CPU 推荐全是 14 代英特尔,一个 15 代都没有,数据滞后了。纯干活(剪辑、3D 建模、跑推理)优先英特尔,除非还要兼顾网游电竞才考虑 AMD,主推 9950X;
- 显卡推荐基本基于 Q4 量化——日常够用,但推荐的卡跑不了 Q8 或 INT8。花大价钱配机器,模型智商先被砍一刀,图啥呢?企业和个人首选 Q8 或 INT8;
- 价格信息滞后,错得比较离谱。
模型本身的两个特点
先说坑:默认思考强度拉满,遇事必深想。有人实测让它画一张图,先想了 2 万多个 token、21 分钟才开始输出。好在解法不难:把 Reading Effort 调成 low(时间缩短近 10 倍),再换个新聊天模板,很多"卡慢"根本不是硬件的事。
再说强项:代码能力是真的顶。有博主用一套编程测试题跑分,Q5 量化版直接和第二名拉开 13 分差距;满血版全栈应用拿了 46 分,超过 GPT-5.5,只比 GPT-5.6 少两分;从生成的前端页面看,满血版一次过没有 bug。
网友的极限操作:Mac 这一侧
64G 的 M2 Max 实测,把能试的加速方案全撸了一遍:
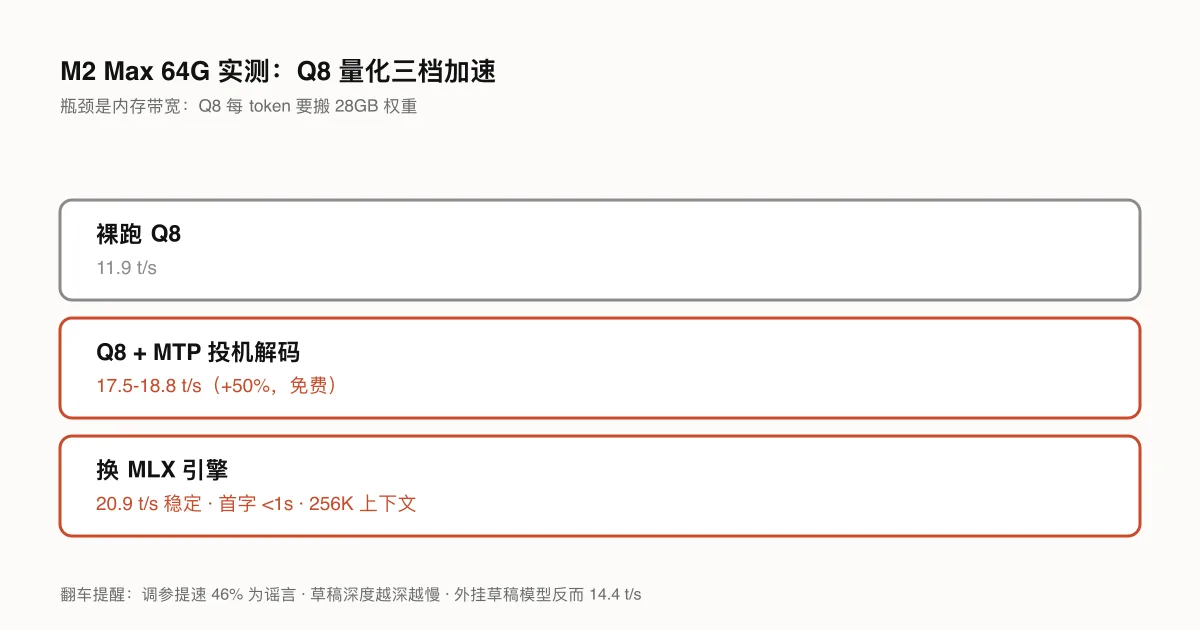
- 裸跑 Q8 量化:每秒 11.9 个 token;
- 开 MTP 投机解码:17.5 到 18.8——几乎无损白送 50% 速度;
- 换 MLX 引擎:全程稳定 20.9 t/s,首字延迟不到一秒,上下文给到 256K。
翻车记录同样有价值:有人说把批大小调到 0.8 能提速 46%,实测反而掉到 17.4;草稿深度加到 3 更慢(默认 2 就是最优);专门下个草稿模型来加速,结果 14.4,比不开还慢。
三个认知:Mac 跑大模型的瓶颈是内存带宽(Q8 每生成一个 token 要搬 28GB 权重,物理天花板);MTP 是模型自带的,加两个参数就开,这 50% 不花钱;MLX 是给 Apple Silicon 专门做的引擎,20.9 还特别稳。
所以 Mac 用户的建议:想认真玩,48GB 统一内存起步。统一内存解决的是"装得下",不是"跑得快"。
N 卡这边的极限操作
2080Ti 22G 魔改版:Q4 量化(约 17GB,刚好塞进 22G 显存),KV 缓存也压到 Q4 省显存给上下文(最终约 170K),再开 MTP——跑到 39.5 t/s,摸到了 4090 不开 MTP 的尾巴。生产环境仍建议上 Q8 或 INT8。
双 V100 16G×2:实测答案是拼不动。256K 上下文下连 MTP 都开不了,直接报显存不足——显存分布不均,草稿模型只加载在一张卡上导致单卡爆满。短上下文 25 t/s,长上下文掉到 12。老显卡对新模型的支持越来越差。
正常配置怎么抄
两句话:显卡买近两代的,模型跟着场景走——不是越贵越好,是越匹配越好。上 27B,说明你的需求至少是知识库问答、代码开发、长文档处理这些正经活。
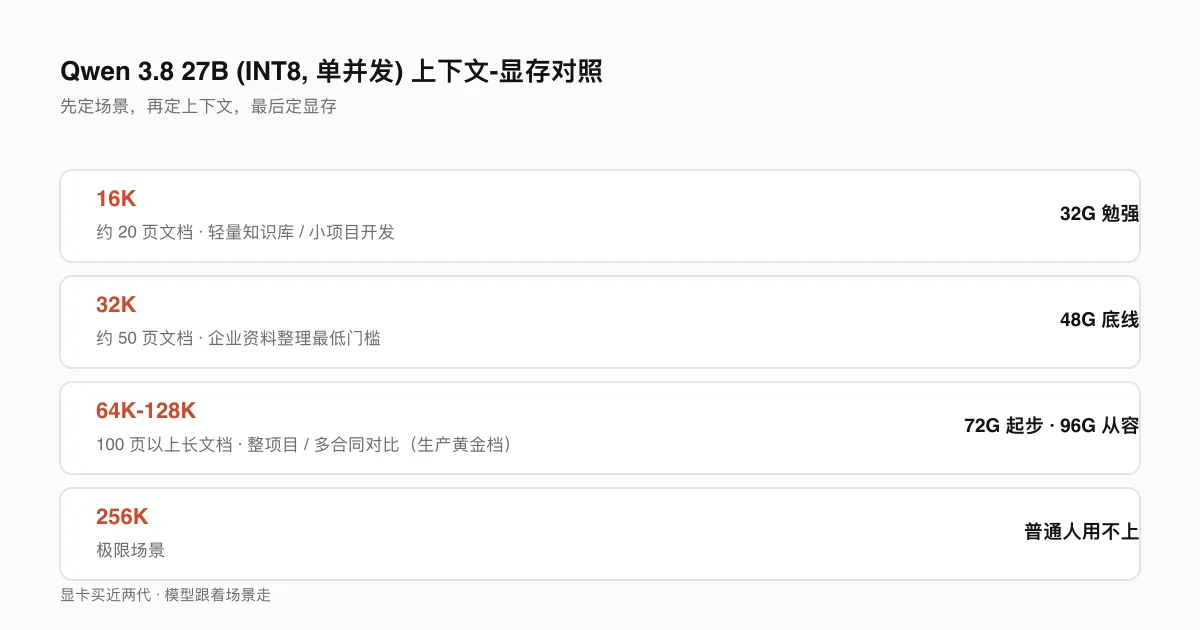
Qwen 3.8 27B INT8 单并发场景下的对照:
- 16K 上下文:处理 20 页左右文档,轻量知识库、小型项目开发,32G 显卡勉强能跑;
- 32K:企业资料整理的最低门槛(50 页文档),48G 显存是底线;
- 64K 到 128K:生产黄金档——100 页以上长文档、整套项目、多份合同对比,72G 起步、96G 更从容;
- 256K:极限场景,普通人用不上。
配置逻辑很清楚:先定场景,再定上下文,最后定显存。你是为了处理你的文档、写你的代码、回答你的用户,不是为了跑满某个数字。单并发个人使用:近两代英伟达显卡,32G 起步,48G 主力,72G 以上比较从容。
(本文数据整理自公开实测分享;如果你有本地部署的硬件配置或软件调试需求,欢迎留言交流。)