字节笔记本
2026年10月7日 · 约 2 分钟读完
知道没用,还是接着查:agent 的停止失能
agent 会判断,但会照着自己的判断行动吗?今日 Hugging Face 论文榜双作给出了一正一反两份答案:一篇证明停止决策是普遍失能点,一篇让基准学会自我加难。
判断与行动的分离
Chubin Zhang 等人的论文(arXiv:2610.06191,今日榜第 2 位)设计了一个受控检索场景并注入失效源,把判断与行动拆开测。结果相当扎眼:七个受测 agent 对失效源结果的无效判定率高达 97 至 100 个百分点,也就是说它们看得出来没用;但这份判断几乎不转化为停手,继续查下去是常态。
更有信息量的是干预实验。提示线索只能改变何时停,改不了依据什么停;允许记忆回答或推理模式会诱发不看证据的早停;声明预算把 7 至 8B 模型推向截止时间式停手;写在提示里的停止规则与调用成本只有部分被遵守。真正有效的只有一招:harness 层强制一个整合步,连续五次自判无用后必须给出答案。这个规则让全部模型的失效源成功率改善,预算翻倍依然稳定,且在判断已显式陈述时不增加额外判断调用。三百题预注册复现确认了分离现象与规则效果。代码开源在 bennidict23 仓库。
基准也要会进化
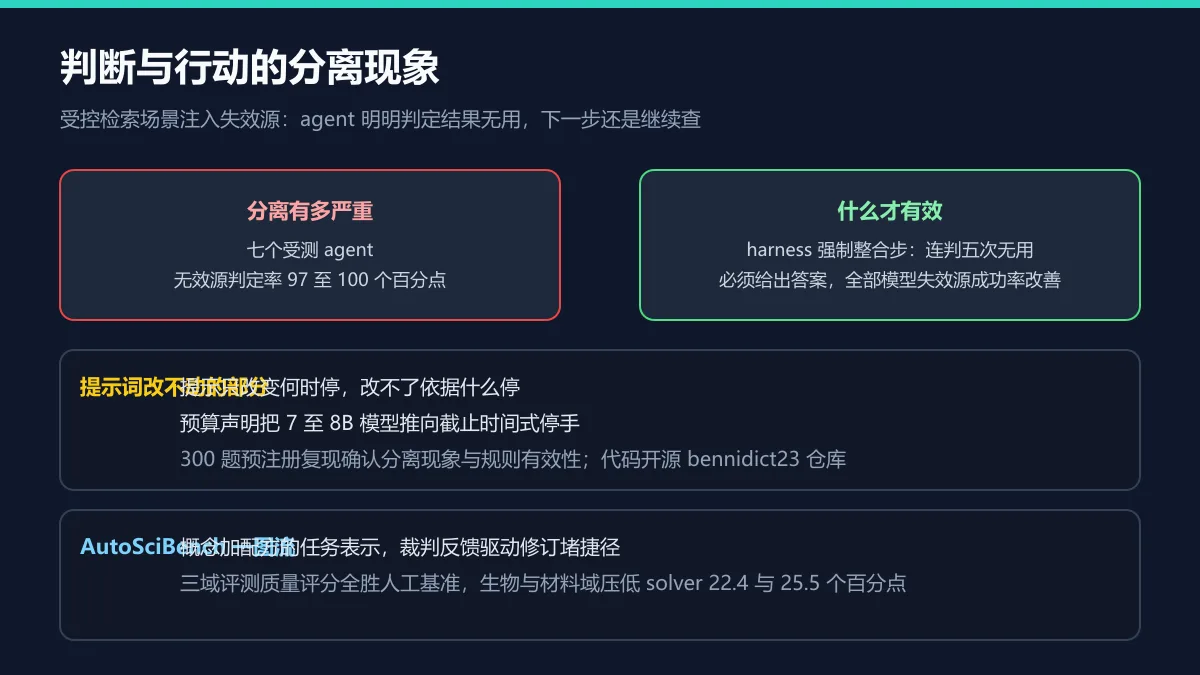
同榜第 1 位的 AutoSciBench(arXiv:2610.05140)处理另一个方向的问题:agent 变强后基准饱和。做法是把任务表示为高层概念加底层配方,agent 试做后裁判反馈驱动配方与概念修订,堵上捷径、把任务推向原始数据重检与证据整合。计算生物、材料与临床影像三域评测中,生成的基准在生物与材料域把 solver 准确率压低 22.4 与 25.5 个百分点,三域质量评分全部超过人工基准。
放在一起读
一篇说明 agent 的知道与做到之间存在结构性缺口,要靠 harness 强制闭合;一篇说明评测基准同样需要进化机制来对抗饱和。两篇合起来呼应本周主线:可靠性不是模型的自觉问题,是结构设计问题。