字节笔记本
2026年10月7日 · 约 10 分钟读完
一文搞懂 Supabase 行级安全:从报错排查到策略设计
用 Supabase 做后端的新手几乎都撞见过同一条报错:new row violates row-level security policy for table。表就在那里,SQL 语法也没错,一执行 INSERT 却被数据库原样弹回。很多人第一反应是数据库坏了,其实恰恰相反——这条报错说明行级安全(Row-Level Security,RLS)正在按设计工作:数据默认上锁,而你还没拿到钥匙。Supabase 这类开源 Firebase 替代品把 PostgreSQL 直接开放给前端,RLS 因此成了每个使用者的必修课。这篇文章就从这条报错出发,把它从概念到落地一次讲透。
这条报错到底在说什么
RLS 是 PostgreSQL 的原生特性,Supabase 建立在 PostgreSQL 之上,直接继承了它。当一张表启用了 RLS,数据库会在引擎层对每次查询自动套用策略:不满足条件的行,对当前用户来说相当于不存在——看不见、改不动、也插不进。
出现这条报错时,通常只有三种可能:
- 表启用了 RLS,但没有创建允许当前操作(尤其是 INSERT)的策略;
- 策略存在,但条件太严格,没有覆盖当前场景;
- 认证环节出了问题,
auth.uid()取不到用户身份,条件判断落空。
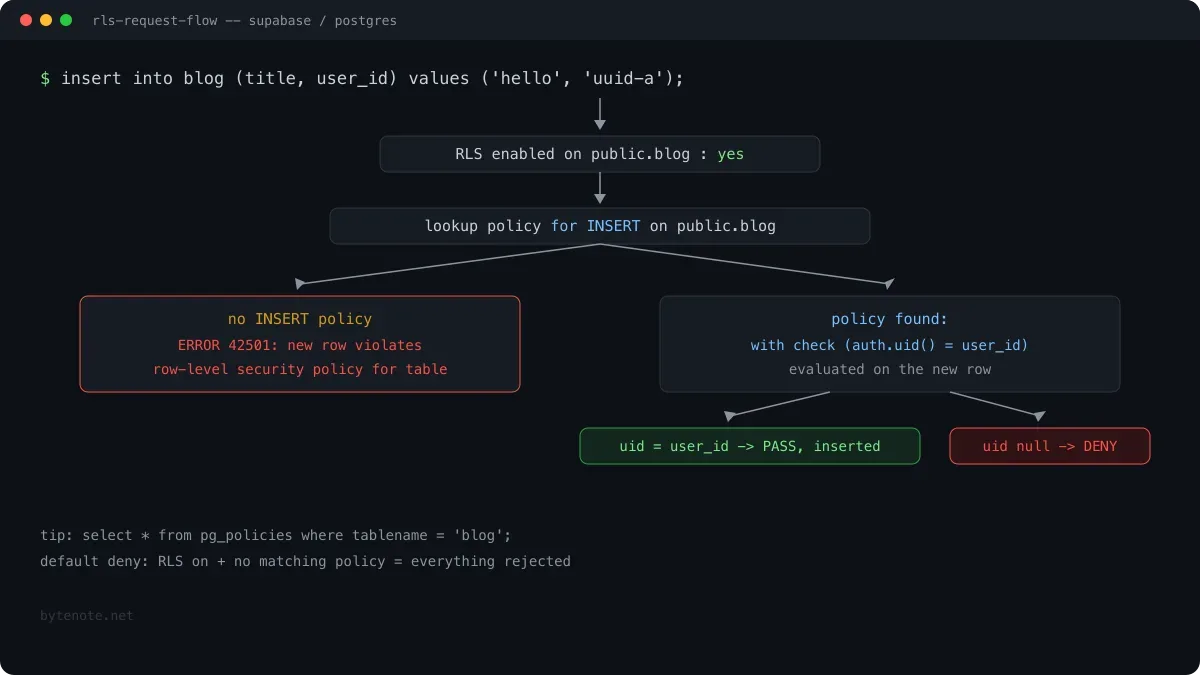
这个报错的底层错误码是 SQLSTATE 42501,含义就是「权限不足」——只是它拒绝的不是整张表,而是某一行。排查也应按上面三种可能的顺序来。在 SQL Editor 里先查策略清单:
select * from pg_policies where tablename = 'blog';结果为空,说明报错是「无策略」导致的;结果里有记录,就逐条核对命令类型和条件表达式。策略没问题,再回头检查客户端请求有没有带上有效登录态。
行级安全是什么
把 RLS 想象成给数据库里的每一行都加一把小锁:开锁规则由策略(Policy)定义,谁能开锁由当前用户身份决定。以一张学生成绩表为例——没有 RLS 时,任何有表权限的人都能看到全部成绩;有了 RLS,可以设定学生只看自己的成绩、老师只看所教班级的成绩、校长看全部。哪怕应用程序写错了,把所有人的成绩都查了出来,数据库也只会返回当前用户有权看到的那几行。
它和传统 GRANT 是叠加关系而非替代:GRANT 管的是表级的粗粒度权限(这张表能不能查、能不能写),RLS 在这之上再做行级的细粒度过滤(哪些行可以)。两层一起生效,缺了 GRANT 连表都进不来,缺了 RLS 则整表裸奔。
相比把权限判断全写进应用代码,RLS 的价值在于把访问控制下沉到数据库引擎:安全性不再依赖「应用代码恰好记得检查」。对多租户 SaaS 以及医疗、金融等敏感数据场景,这层兜底尤其重要——纵使某个接口漏了鉴权,租户之间的数据边界依然由数据库把守。
Supabase 为什么默认全拒
理解报错的关键,是理解 Supabase 的默认安全模型:默认拒绝(default deny)。通过控制台新建的表默认就启用了 RLS,且不附带任何策略——此时所有角色的 SELECT、INSERT、UPDATE、DELETE 全部被拒绝,包括已登录用户。每放开一种访问,都必须显式创建一条策略。(用 SQL 迁移建的表则需要手动执行 alter table ... enable row level security。)
这个设计有其架构原因:Supabase 会把 PostgreSQL 通过 REST API 直接暴露给浏览器,客户端手里只有公开的 anon key。如果新表默认放行,等于任何人拿到这个 key 就能读写你的全部数据。默认拒绝看起来麻烦,实际是把安全底线焊在了数据库这一层。
控制台配置的路径是:Table Editor 选中表,进入 Policies 标签,点 Enable RLS,再点 New Policy。创建策略时要填几个字段:策略名称、策略命令(SELECT / INSERT / UPDATE / DELETE,各控制一种操作)、目标角色(不选则默认作用于 public 全部角色;写成 authenticated 就只对登录用户生效)、以及最核心的 USING / WITH CHECK 表达式;策略行为保持默认的 Permissive 即可。熟悉 SQL 的话,直接在 SQL Editor 里执行 create policy 语句更快。
USING 与 WITH CHECK 的区别
这是新手最容易混淆、也直接对应那条报错的一点:
- USING 过滤的是「已存在的行」,作用于 SELECT、UPDATE、DELETE;
- WITH CHECK 校验的是「新写入的行」,作用于 INSERT;UPDATE 可以两者都有。
所以当 INSERT 报 RLS 违规时,问题一定出在 WITH CHECK 一侧:要么压根没建 INSERT 策略,要么 WITH CHECK 条件不满足。UPDATE 稍微特殊,两个子句各管一段:USING 决定你能改哪些行,WITH CHECK 校验改完之后的新值是否仍然合法——没有它,用户可以把别人的行改成自己的。
auth.uid() 返回当前登录用户的 UUID,若表中有 user_id 列存作者身份,最典型的写法就是 with check (auth.uid() = user_id)。若用户未登录,这个函数返回 NULL,条件永假,同样会触发报错——所以「明明策略写了却还报错」时,先怀疑身份没传对。
一套可直接复用的博客表策略
以一张 blog 表(含 user_id 作者列、is_published 发布标记)为例,一套完整的策略长这样:
-- 任何人可读已发布文章
create policy "public read published blogs"
on public.blog for select
using (is_published = true);

-- 登录用户可插入,且只能以自己名义插入
create policy "authenticated insert own blogs"
on public.blog for insert
to authenticated
with check (auth.uid() = user_id);

-- 作者可更新自己的文章
create policy "owner update own blogs"
on public.blog for update
using (auth.uid() = user_id);

-- 作者可删除自己的文章
create policy "owner delete own blogs"
on public.blog for delete
using (auth.uid() = user_id);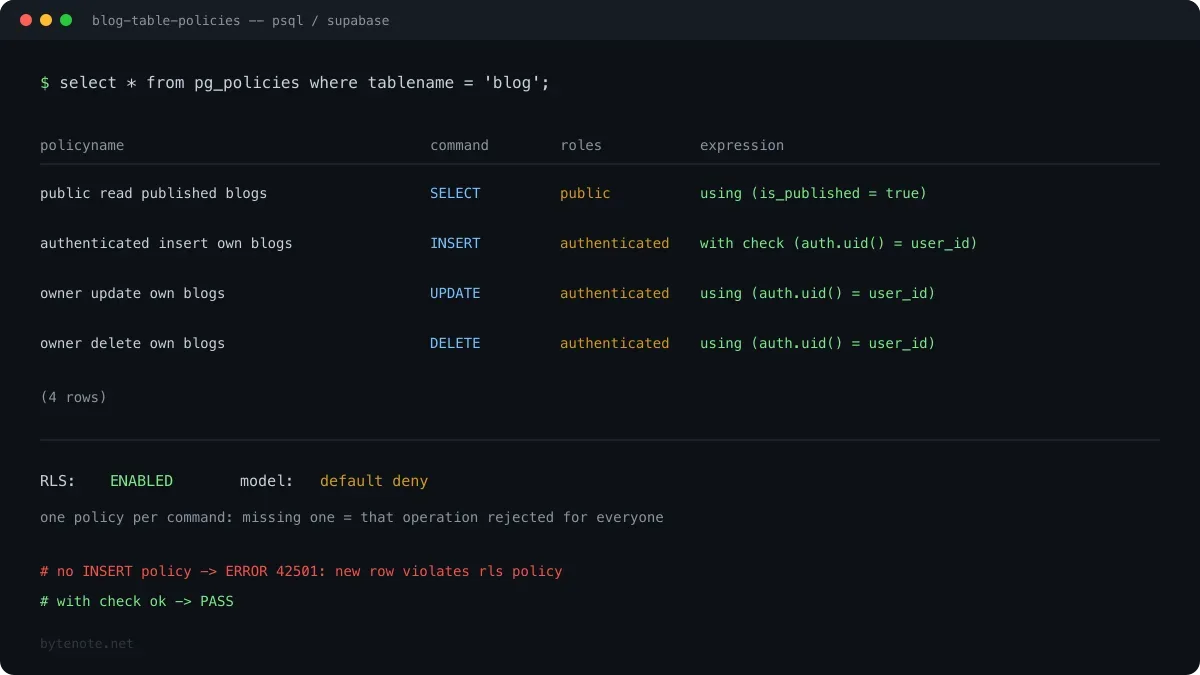
四条策略各管一种操作,缺哪条,对应操作就会被拒绝。如果想做完全公开的博客,把第一条改成 using (true) 即可;策略里可以写任意 SQL 表达式,包括子查询和连接,足够覆盖「小组成员可读」「管理员全权」这类复杂规则。
多租户是 RLS 最能体现价值的场景:给每张业务表加一个 tenant_id 列,再用一条引用成员关系表的子查询做策略条件,所有租户共用同一套表、同一套策略。新接一个租户不需要建新 schema、不需要改任何业务代码,应用层查询甚至感知不到过滤的存在——这正是「安全逻辑集中在数据库」的意义。
踩坑提示与延伸
几条实战经验,条条都常见于真实项目:
- 策略按操作类型生效。SELECT 策略管不到 INSERT,每种操作都要单独放行,这正是「启用了 RLS 一切都被拒」的根源。
- 同表多条 Permissive 策略之间是 OR 关系。一旦有一条
using (true)的公开读策略存在,其余策略再严也收不回来;需要叠加约束时应改用 restrictive 行为。 - 表 owner 默认绕过 RLS。建表用的角色(如 service_role 或超级用户)连上去测试,会发现策略「不生效」;要么换 anon/authenticated 角色测,要么用
force row level security强制约束 owner。在 SQL Editor 里直接测试时也要注意执行身份,可用set local role authenticated;模拟真实客户端。 - 服务端任务用 service_role 密钥可绕过 RLS,适合定时清理、统计汇总这类管理员操作,但该密钥绝不能下发到浏览器。
- 复杂策略(尤其带子查询的)在大表上会逐行求值,要注意性能;社区通行做法是把
auth.uid()包成(select auth.uid()),让查询计划器把它当作常量缓存,避免每行重复求值。
行级安全的精髓在于思维方式的转变:不要再想「哪里需要拦一下」,而是想「默认全拦,我为谁开门」。先把访问矩阵想清楚,再落成策略,那条吓人的报错就会从绊脚石变成安全兜底的正反馈。