字节笔记本
2026年10月7日 · 约 2 分钟读完
不微调直接 RL,医生模型出新路
模型领域适配的教科书路径是先微调再强化,医疗方向的名门团队现在给出了另一条路。今日 Hugging Face 论文榜双作,一篇是医学模型的纯 RL 域适配,一篇是 GUI agent 的 harness 自动进化。
HuatuoGPT-3:单阶段策略优化
Junying Chen 等人的 HuatuoGPT-3(arXiv:2610.05966,今日榜 15 赞第 2 位)先诊断标准管线的两个失效模式:梯度饥饿让模型过早收敛到部分知识;教师分布锚定让 SFT 阶段的教师输出把后续 RL 的探索空间锁死。药方叫 OnePO 单阶段策略优化,用自适应目标进化配教师退休机制:教师输出只当临时引导,随训练推进逐步撤出。
成绩单:医学适配场景 OnePO 用两万训练样本在 HealthBench 拿 67.2,比 SFT 加 RL 组合高 2.7 分,比纯 RL 高 7.4 分;HuatuoGPT-3 27B 总分 70.1、专业子集 71.4,官方口径超过 GPT-6 Astra 等前沿模型。代码与权重开源在 FreedomIntelligence 仓库。纯 RL 路线在垂域的可行性,这份证据相当硬。
GUI-HARVEST:截图证据自动改 harness
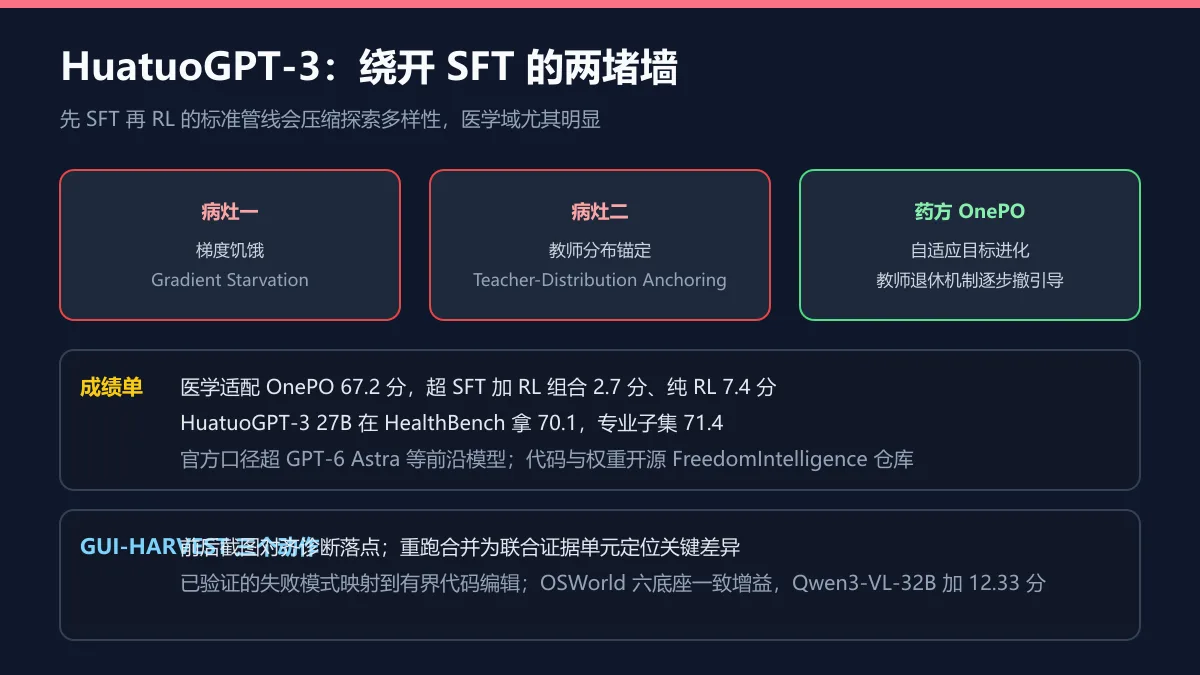
Geyi Yang 等七人的 GUI-HARVEST(arXiv:2610.00948,6 赞)给图形界面 agent 配了个自动 harness 优化器,底座全程冻结。机制三件:把模型输出与实际执行对齐前后截图,在视觉证据里诊断落点失败;同一任务重跑多次合并为联合证据单元,过滤执行随机性并定位真正影响结果的行为差异;把验证过的失败模式固化,映射到有界的源码编辑,预测先行、重跑复核。
OSWorld-Verified 上六个底座全部获得留出集增益,Qwen3-VL-32B-Instruct 提升超过十二分;冻结 harness 直接迁移到 WindowsAgentArena,把 GPT-5 拉高 13.87 分。同预算同起点下胜过 Self-Harness 与 Meta-Harness 基线。代码开源。
放在一起读
一篇证明垂域适配可以不走微调,一篇证明 harness 优化可以不走人工。两篇都在把 agent 工程里最贵的两件事(领域数据标注与规则手写)换成自动流程,方向上与本周的进化系列完全同频。