字节笔记本
2026年10月7日 · 约 9 分钟读完
用 Vision 把识别结果盖回 PDF
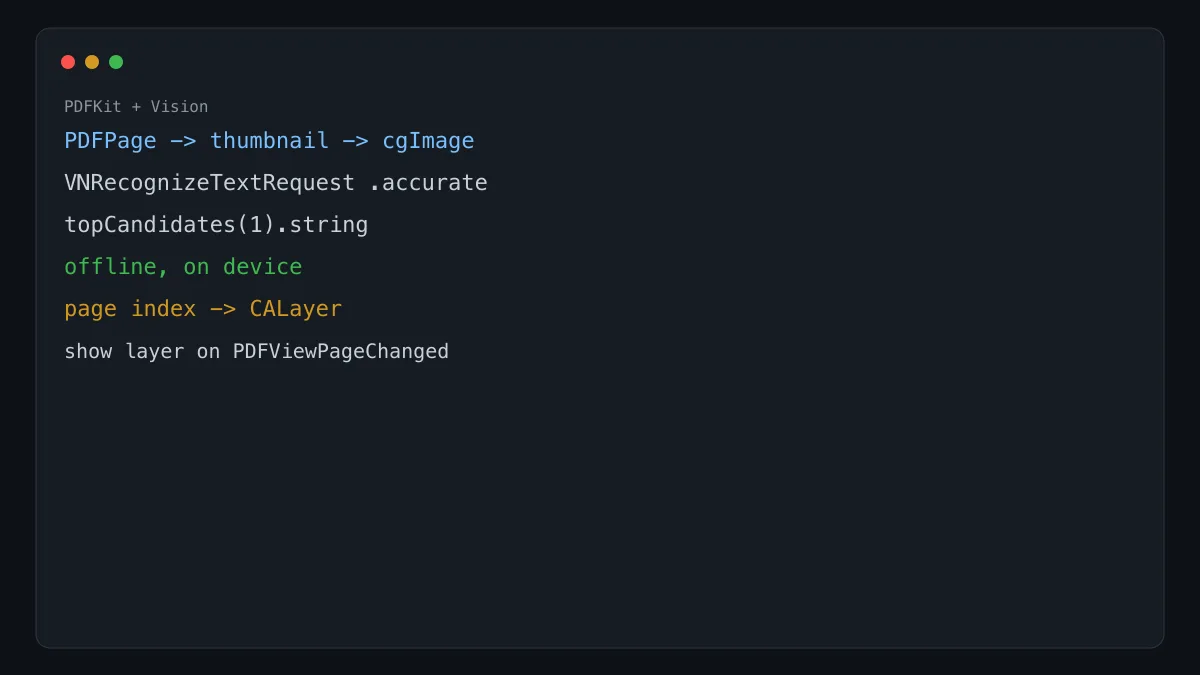
系统自带的识字走 Vision,不需要把图片上传到别处。从 iOS 13 和 macOS 10.15 起,VNRecognizeTextRequest 就在系统里,能识别中文和英文,可以离线跑,也可以挂在实时画面上。要把它用在 PDF 上,还得再加上 PDFKit:先把每一页变成图像,识别之后再按坐标盖回原来的页面。
一页先变成图像,再交给请求
PDFDocument(url:) 打不开文件时直接结束,不要对空文档发识别。多页用页码循环,pdf.page(at:) 取出 PDFPage。Vision 吃的是图像,不是 PDF 指令,所以每一页要先栅格化。对话里的写法是用页面的 mediaBox 做缩略图,再拿 cgImage:
guard let cgImage = page.thumbnail(
    of: page.bounds(for: .mediaBox).size,
    for: .mediaBox
).cgImage else { return }
请求的回调里把 request.results 转成 [VNRecognizedTextObservation]。每个观察点取 topCandidates(1) 的第一条,那就是这一小块区域最可能的字符串。recognitionLevel 设为 .accurate,偏准确而不是偏速度。执行用 VNImageRequestHandler(cgImage:options:),perform 放在 do/catch 里,失败时把错误打出来,不要让一页的失败变成整份文档的崩溃。
只收集字符串的那一版用了 DispatchGroup:每一页 enter,回调里 leave,全部完成后在主队列把字符串数组交出去。这一版没有坐标,适合“把全文导出成文本”。它也没有按页码上锁,并发回调往同一个数组 append,页与页的顺序不保证和文档一致。要按页展示,就不要只攒一个字符串数组。
坐标在 0 到 1 之间,而且 y 轴是反的
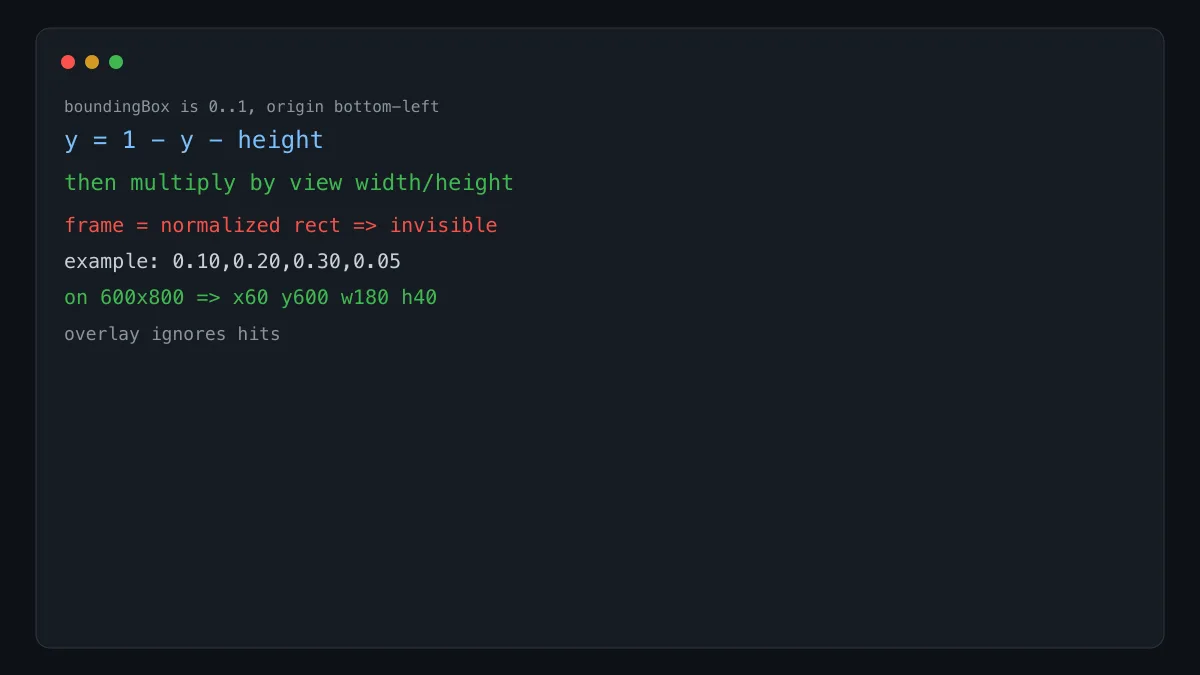
悬浮显示需要的是观察点的 boundingBox。Vision 的这个矩形是归一化的,原点在图像左下角,宽高都是 0 到 1 的比例,不是像素,也不是点。
对话里的覆盖层先做了 y 轴翻转:
var rect = observation.boundingBox
rect.origin.y = 1 - rect.origin.y - rect.height
textLayer.frame = rect
翻转是对的,UIKit 和 AppKit 的视图坐标原点在左上角,不翻的话字会上下颠倒。但下一行把这个 0 到 1 的矩形直接写成了 CATextLayer 的 frame。图层的 frame 用的是父图层的点坐标。不乘上页面在屏幕上的宽高,所有字都会挤在左上角大约 1 点乘 1 点的区域里,看起来像识别失败,其实字已经画上去了,只是小到看不见。
正确的换算是翻完 y 之后,乘上当前页在视图里的宽和高。页面缩放、旋转之后这个尺寸会变,所以不能在识别完成时算死,要在布局变化时再乘一次。
覆盖层本身关掉交互:isUserInteractionEnabled = false,背景透明,这样点击仍然落到下面的 PDFView,用户还能选中和滚动原来的 PDF。文字层用红色、12 点、居中,只是为了让识别结果看得见,正式产品里可以改成可搜索的透明文字,而不是永远红着。
多页不要只留一层
单层覆盖只能对上当前这一页。翻页之后,上一页的框还留在屏幕上,或者新的一页没有框。多页版本用字典 [Int: CALayer],键是页码。每一页识别完,把自己的文字层放进字典,不立刻叠到窗口上。
刷新跟 PDFView 的翻页通知走。NotificationCenter 监听 .PDFViewPageChanged,回调里先把覆盖层上的子图层清掉,再根据 pdfView.currentPage 找到页码,把对应的那一层加上。识别可以在打开文档时对所有页各跑一次,显示只渲染当前页。页数很多时,识别仍应放到后台队列,回到主队列只做加图层这一步,回调里已经是 DispatchQueue.main.async。
样本写成了 UIView,挂的是 iOS 的交互开关。macOS 上换成 NSView,坐标翻转和“按页码存图层、翻页再换层”是同一套,不要为了 macOS 再换一个识别框架。VNRecognizeTextRequest 两边都在 Vision 里。
先全文,再坐标,再按页显示
只想要文字,栅格化每一页,取第一候选的字符串即可,记得结果要按页码排序。要悬浮在原文上,就用 boundingBox,先翻 y,再乘视图尺寸,不能把 0 到 1 的数直接当 frame。多页用页码当键,翻页通知里只显示当前页的那一层。三步分开,才不会把“没识别到”和“识别到了但画在看不见的地方”混成一个问题。
用一个假设矩形看清缩放
假设某个词的 boundingBox 是 x 0.10、y 0.20、宽 0.30、高 0.05,页面在视图里宽 600、高 800。Vision 的 y 从下往上,翻转之后原点 y 是 1 - 0.20 - 0.05 = 0.75。再乘视图尺寸,左边是 60,顶边是 600,宽度 180,高度 40。这四个数才是 CATextLayer 的 frame。对话里的代码做完翻转就停了,等于把 0.75 和 0.30 当成了点。图层会缩在左上角,红色的字只有一点点大。
识别级别用 .accurate 时,同一页会比快速模式慢,多页 PDF 更明显。所以字典按页码缓存图层是有意义的:翻回已经识别过的页,直接把那一层加上,不要再跑一次 Vision。缓存的是图层和当时的观察点。视图尺寸如果因为旋转或分栏改变了,旧的 frame 会错位,需要用保存下来的归一化矩形按新尺寸再乘一次,而不是把 CALayer 的像素帧当成永久坐标。
topCandidates(1) 只取第一名。第一名为空的观察点直接跳过。有的区域会返回空候选,那不是整页失败。整页失败是 perform 抛错,或者 cgImage 根本没生成。缩略图尺寸如果用了过小的边长,识别率会掉,坐标仍是 0 到 1,但字已经糊了。对话里用的是 mediaBox 的原始页面尺寸,这是比较稳的栅格化起点,不要为了快再除一个很大的系数。
并发收集纯文本的那版还有一个顺序问题。DispatchGroup 只保证全部完成,不保证 append 的顺序就是页码顺序。导出全文时要按页码装进数组的固定下标,完成后再拼起来。覆盖层那版用页码当字典键,已经避开了这个问题,显示时只查当前页。
样本是 iOS 的 UIView。macOS 上 PDFView 同样会发翻页通知,覆盖层改成不接收点击的 NSView,文字仍用图层。坐标系的翻转不要重复做两次:Vision 翻一次到视图坐标就够了。如果 PDFPage 自己还有旋转,要在乘尺寸之前把旋转考虑进矩形,否则横向页面上的字会整体偏到一侧。对话里的代码没有单独处理旋转页,横向扫描件需要在这一步补上,不能假装 mediaBox 永远是竖的。
多页循环里,某一页 thumbnail 失败就跳过该页,不要中断后面的页。对话里的纯文本版本在拿不到图像时对那一页 leave 分组,避免 DispatchGroup 永远等不到。这个 leave 必须和 enter 成对,包括提前 return 的分支。少一次 leave,完成回调就不会来,界面会一直停在识别中。
覆盖层的文字只是调试用的可见标记。若目的是让系统的选择和搜索能用到这些字,红色的 CATextLayer 并不够,它不参与 PDF 的文本层。它解决的是“我看到识别框落在哪”。框的位置对了,再决定要不要把同一批字符串写进可复制的文本。位置不对时先修矩形,不要先换识别引擎。recognitionLevel 从准确改成快速,不会修好一个 0 到 1 的坐标错误。
翻页通知的观察者要在视图释放时去掉。样本里 addObserver 之后如果视图被反复创建,旧视图仍会收到 PDFViewPageChanged,往已经不在树上的图层加子层。多页文档来回翻时,这会表现为偶发的错层,而不是稳定地复现在第一页。