字节笔记本
2026年10月7日 · 约 7 分钟读完
AI 还原复杂页面:分块、选型与人工收尾的边界
「一比一还原设计稿」是前端工程师最熟悉、也最繁琐的任务之一:设计师递来一张静态截图,开发者要把它翻译成结构清晰、可维护的组件代码。量间距、对色值、搭网格,一个中等复杂度的页面手工还原动辄半天。多模态大模型成熟之后,这件事有了新的打开方式:把截图直接交给 AI,几分钟拿到一份可运行的代码框架。最近一次实战里,AI 接到的是一个内容密集型的导航门户首页,十一个区块、四种以上的卡片形态。它一次生成的代码结构完整、能直接跑,但离真正的「像素级」还有一段明确的距离。这次还原的拆解思路、选型逻辑与收尾边界,值得完整复盘。
密集型页面才是试金石
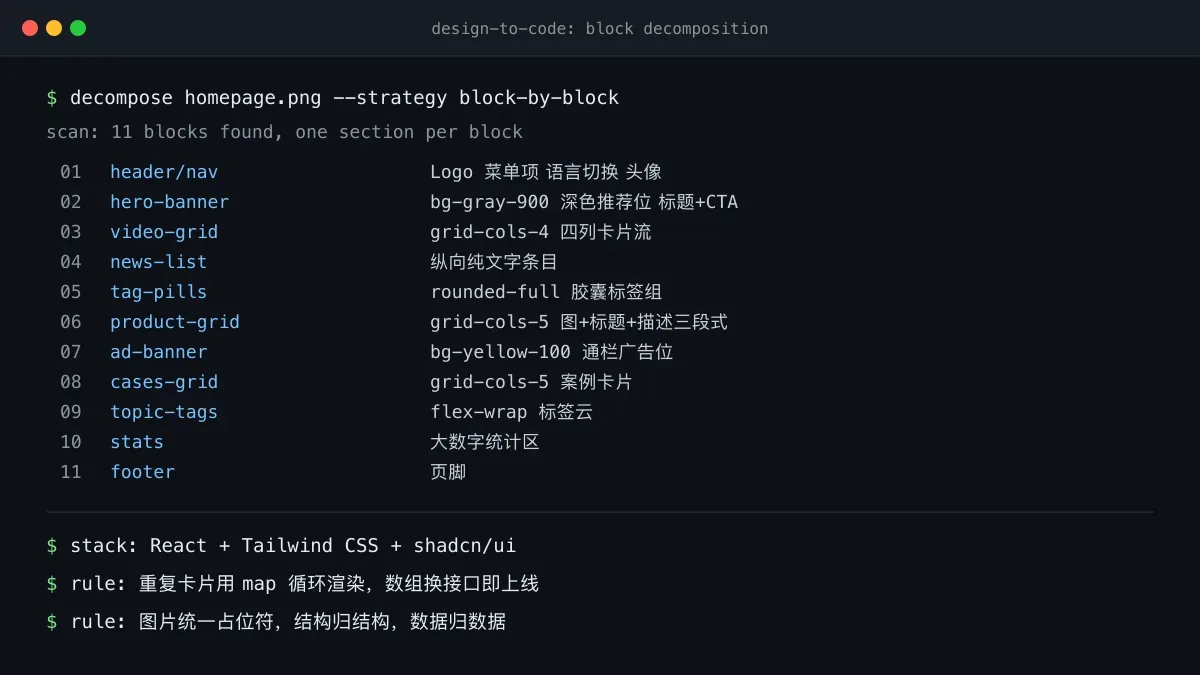
比只有标题加按钮的落地页,门户首页才是对 AI 还原能力的真正考验。目标页面同时存在十余种 UI 形态:顶部导航栏带 Logo、七个菜单项、语言切换与用户头像;深色底的 Hero 推荐位;四列视频卡片网格;纯文字的资讯列表;圆角胶囊标签组;五列产品网格与案例网格;浅黄色底的通栏广告位;大数字统计区;页脚。
区块越多、形态差异越大,AI 越容易顾此失彼。把广告位做成普通卡片、把标签组塞进网格、漏掉统计区,都是常见的翻车点。能把全部区块一一识别并各归各位,才算通过基本盘。
还原策略:先分块,再选型
复盘整个过程,AI 的处理思路可以概括成两步,和资深工程师的手感完全一致。顺带一条实用建议:把「先列清单、再写代码」固定成流程——先让 AI 输出它识别到的区块清单,人工核对无遗漏后再要求生成。清单是核对的最小单元,清单里漏掉的区块,后面写得再多也是白写。
第一步是分块。整页被切成语义化的 section:header、hero、hot videos、latest news、scenarios、featured products、ad banner、cases、topics、stats、footer,一个区块一个 section,互不嵌套干扰。这一步的价值常被低估:分块对了,样式和布局才有清晰的坐标系,事后也能按区块局部修改,不必牵一发而动全身。
第二步是选型。AI 没有从零手写样式,而是站在成熟组件库之上:shadcn/ui 的 Card 承载全部卡片内容,Button 用 variant 属性区分主按钮、描边按钮与次级按钮,图标来自 lucide-react。布局全权交给 Tailwind 工具类:grid-cols-4、grid-cols-5 配 gap-4 复现多列网格,flex 配 space-x 处理横向排列,rounded-full 生成胶囊标签,bg-gray-900 配 text-white 做出深色 Hero,bg-yellow-100 做出广告位底色。
Tailwind 适合这个场景并非偶然。它把视觉规格直接翻译成类名:间距是数字、色值是类名、栅格是列数,AI 从截图里读到的每个视觉特征都有现成的词汇对应,比让它即兴写自定义 CSS 更不容易走样。组件库则把「圆角多少、边框颜色」这类低层决策收编成预设,AI 只需要选对组件,就把出错面缩小了一圈。
还有两个容易被忽略的细节。其一,重复内容全部用 map 循环渲染:视频、产品、案例的卡片都由数组驱动,后续接入真实接口几乎零改造,把 mock 数组换成接口返回值即可。其二,图片统一走占位符 URL。AI 分得清哪些属于「结构」、哪些属于「待填的数据」,这个边界感正是生成代码能否继续开发的关键。
AI 给了八成,剩下两成靠人
生成的代码能跑,AI 自己也随即列出了后续清单:替换占位图片、接入真实数据、实现路由、补充交互、微调视觉细节。翻译成工程语言,这就是人工接管的部分。
视觉校准。AI 对色值的判断来自截图采样,存在系统性偏差;字号、行高、内外边距通常要对照设计稿逐项校对,这一步没有捷径。
响应式适配。AI 默认按桌面视角生成,grid-cols-5 在窄屏上不会自动降列,需要手动补上 sm、md 断点,移动端往往要重排整个网格。
工程化拆分。单文件数百行的组件适合验证,不适合维护,应按区块拆成子组件,把 mock 数据抽到独立模块,公共卡片抽象成可复用单元。
语义与无障碍。导航、列表、按钮的语义标签需要复核,图片要补 alt 描述,交互元素要能被键盘访问。
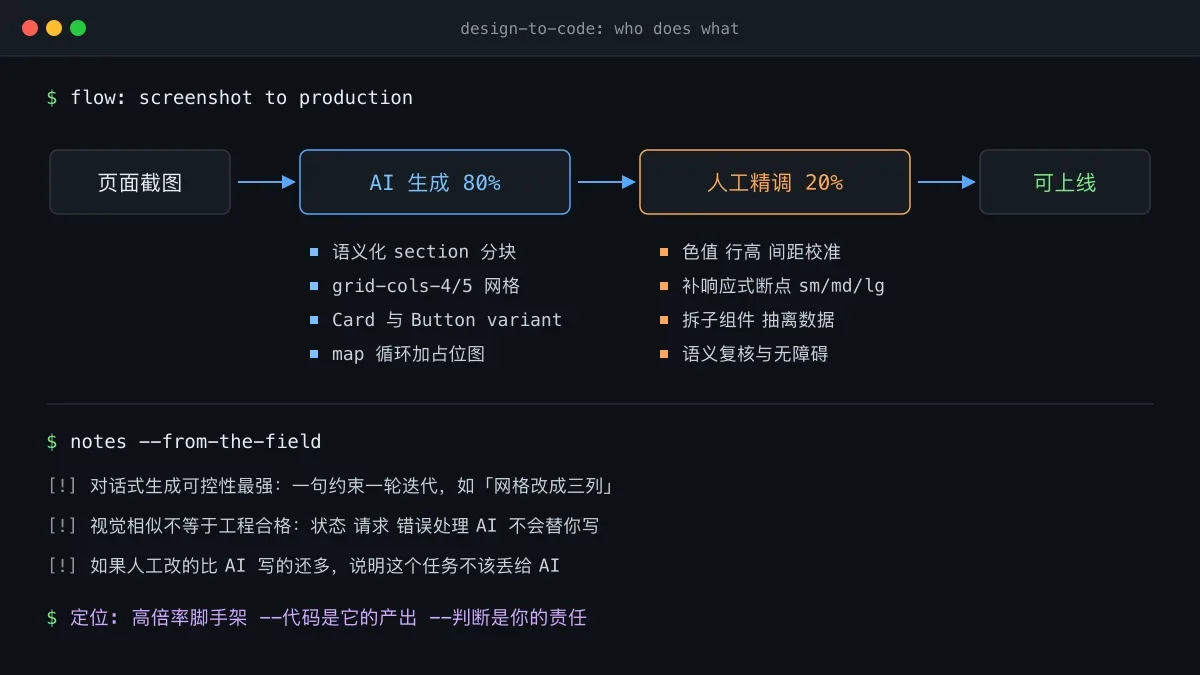
「AI 出八成、人收尾两成」,是当下 Design-to-Code 比较现实的分工。反过来理解也成立:如果你发现自己修改的部分比 AI 写的还多,说明这个任务本就不适合丢给 AI,比如需要严格对齐品牌规范的旗舰页。
三条路线的可控性之差
目前的截图转代码方案大致三类。第一类是专用工具,如 v0.dev、Galileo AI 与各类 screenshot-to-code 项目,产品化界面开箱即用,但通常绑定 React、Tailwind、shadcn/ui 这套技术栈,定制空间有限。第二类是设计工具内转换,在 Figma 里把图层直接转成代码,好处是拿到精确的样式数据,缺点是生成代码可读性参差,往往还要人工重写。第三类是对话式生成,也就是这次的方式:上限取决于使用者的表达,但可以追加自然语言约束持续迭代,一句「网格改成三列」就是一轮。
三条路线的共同点,是把「还原」变成了「生成加校对」;差异在可控性。怎么选?快速验证概念,专用工具最省事;团队已经活在 Figma 里,插件路径顺手;要把页面落到自家组件库与设计规范上,对话式更合适——把组件库文档和规范一起作为上下文喂给模型,它生成的就是你们的 Card 和 Button,而不是通用件。对话式可控性最强,前提是你能把自己的不满描述清楚,这本身就是一项工程能力。
视觉相似不等于工程合格
这次实战最大的启发不在「AI 能写页面」,而在工作流的重构。对设计师来说,设计稿提交几分钟就能拿到可交互原型,实现的可行性得以提前验证;对开发者来说,搭骨架、写循环、配工具类这些机械劳动被压缩,精力可以留给交互、性能与体验。
但要警惕另一个极端。AI 生成的代码天然缺少状态管理、数据请求、错误处理这些「看不见的部分」,视觉相似不代表可以直接上生产。合理的定位是把它当作高倍率脚手架:代码是它的产出,判断依然是你的责任。
下一阶段的竞争点,已经不在「还原得像不像」,而在「交付得能不能用」:响应式、无障碍、性能预算、与设计系统的对齐。谁能把这些工程约束写进生成流程,谁就能把剩下的两成人工成本,再往下压一截。