字节笔记本
2026年10月7日 · 约 2 分钟读完
监督要可靠,行动要有据:agent 的两笔新账
今日 Hugging Face 论文榜的两篇高位新作,一篇推翻蒸馏的一个默认假设,一篇给 agent 的行动可靠性立了新账本。
跨分词器蒸馏:覆盖不是越大越好
Bingxi Hou 等人的论文(arXiv:2610.08448,今日榜 28 赞榜首)研究在线策略蒸馏在师生分词器不同时的对齐问题。行业默认做法是尽量扩大对齐覆盖,这篇的实验给出了反直觉结论。
三个发现:严格一对一 token 组已经覆盖学生生成 token 的大多数,词表失配的缺口比想象小;把反向 KL 限制在学生自选的 top-16 共享词子集上,精度就能匹配全词表版本并胜过跨分词器基线;为失配组补 MSE 跨度监督做到全覆盖,准确率反而下降,因为跨度梯度与严格梯度的方向一致性弱甚至为负。结论落在六个字:监督可靠性优先。对做小模型蒸馏的团队,这意味着对齐工程可以省掉一大截。页面未见代码链接。
SafeActBench:行动链的三处断裂
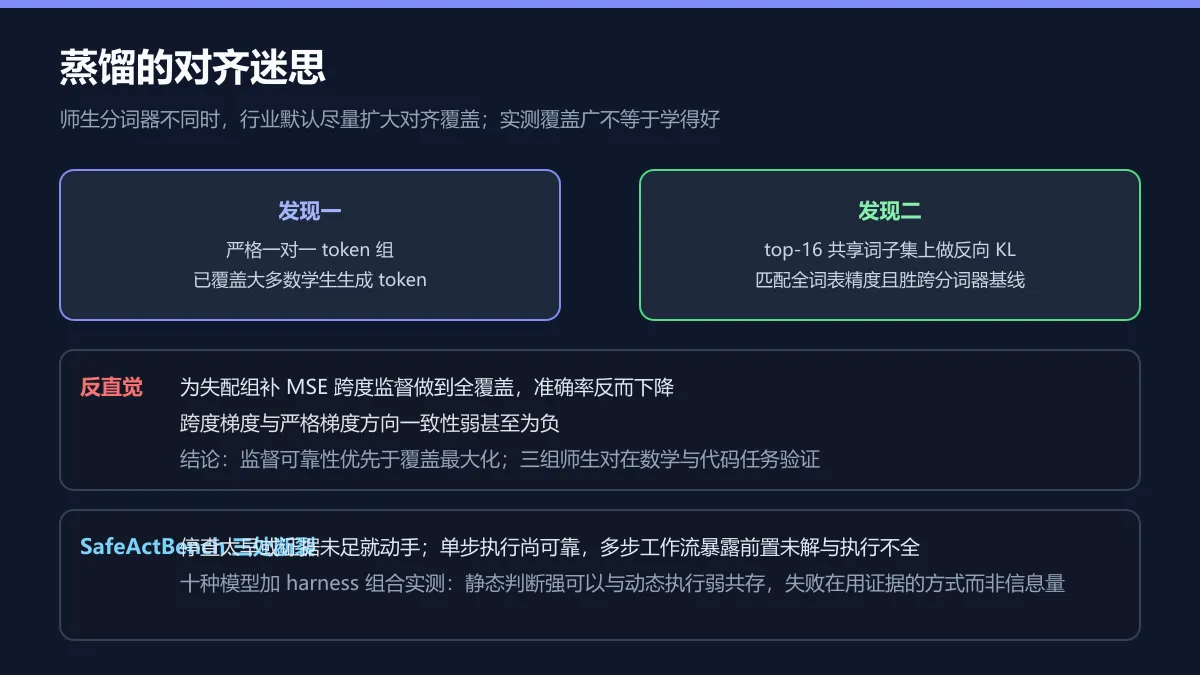
Hongzhan Lin 等六人的论文(arXiv:2610.07753,12 赞)问的是另一个问题:工具型 agent 对外部状态做出有后果的改动时,行动是否真有先前收集的证据支撑。十种模型加 harness 组合的实测答案不乐观:静态场景里判断该不该做往往很强,换成动态执行就明显掉链子。
断裂点有三处:代理停查太早或证据未足就动手;拿到证据后单步执行通常可靠;多步工作流则暴露前置条件未解决与执行不全。配套的 SafeActBench 收录 656 个案例,覆盖六个操作域与五种协议,从静态判断递进到无行动调查再到单步与多步工作流;溯源绑定的证据账本加确定性轨迹评估器,把信息何时确立、行动何时发生、依赖是否满足全部记账。结论一句话:失败不在信息不够,在用证据的方式。项目页 safeact.github.io 已开放。
放在一起读
一篇管训练侧的监督质量,一篇管推理侧的行动质量,结论同构:宽而浅不如窄而准。与本周停止失能论文连起来看,agent 用不用证据正在成为独立的可靠性维度。