字节笔记本
2026年10月7日 · 约 3 分钟读完
自己出题攒经验:DAEDALUS 给 agent 装上自举记忆
agent 的经验记忆大多靠喂:要么有现成的训练任务集,要么有权威判题器告诉它对错,两者在真实环境里都难凑齐。10 月 6 日放榜的 DAEDALUS(arXiv 2610.08048,作者 Antoine Edy 等,代码开源于 illuin-tech/daedalus)给出一条自举路线:不要任务集也不要判题器,让 agent 自己给自己出题,从解题失败里攒出可复用的经验。
两个 agent 的师徒制
框架里有两个角色。探索者负责出题:它在环境里自由交互,生成有挑战但可解的任务,任务难度还随解题结果动态调整,太简单就加码,做不出来就收敛。解题者负责做题:每次失败后从轨迹里提取一条启发式经验,注意不是把失败原样记住,而是提炼成可迁移的做法;这条经验要经过反复验证,解题者带上它重试必须连续成功,才算收编进记忆库,测试时随身携带。验证不过的经验直接淘汰,这道关挡住了把偶然当规律的风险。消融实验还发现两个关键细节:解题者轨迹是经验提炼最主要的信息源,环境观察单独拿出来效果差得多;把早期发现做因子化拆解能明显提升成本效率。
三基准实测
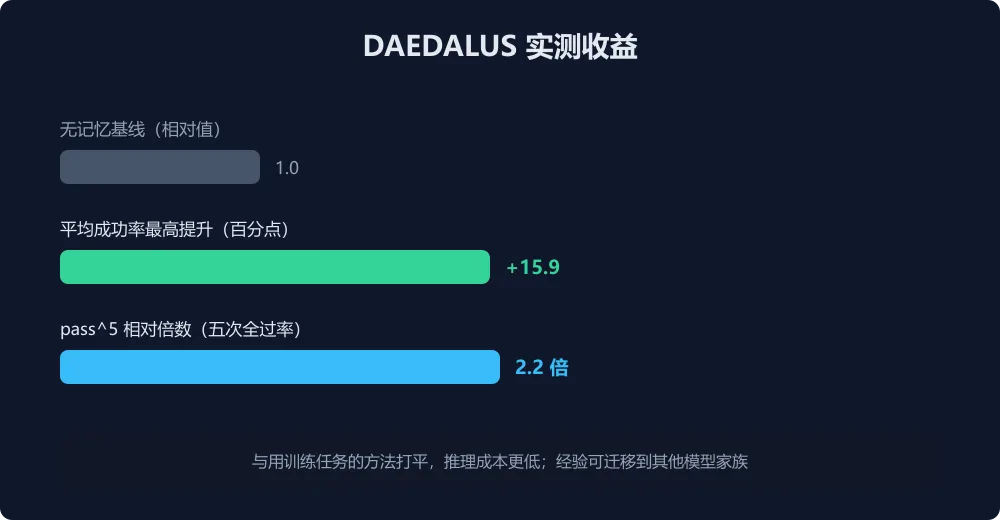
在 AppWorld、tau2-bench 和 AutomationBench 三个基准上,DAEDALUS 把平均成功率最多提升 15.9 个百分点,五次全过率 pass^5 最高提升 2.2 倍,对照是无记忆基线。更重要的两个横向结论:它与依赖训练任务的方法打平,但推理成本更低;提炼出的经验可以迁移到其他模型家族,说明攒下来的是任务知识而不是模型私货。探索预算也不用很大,小预算就能起量。作者还发现副产品有用:自生成的任务集可以直接当代理基准用来给模型排序。工程可信度也够:仓库里连 ExpeL、ERL、AutoGuide、ReasoningBank 等对比基线都做了复现,生成与推理的完整轨迹放在 Hugging Face 上供复验。
对做内部 agent 平台的团队,这套方法的价值在于绕开了冷启动:新业务没有标注数据、没有评测集时,探索者加解题者的组合可以先跑起来,边用边攒。要注意的边界是它攒的是启发式经验,不是经过回放复现的严格验证,高风险场景仍应叠加独立校验。仓库 MIT 协议开源(刚放出,星数还是个位数,属于第一波上车位),论文 CC BY 4.0,连基线复现和推理轨迹都放在 Hugging Face 上,感兴趣可以直接拆来做原型复现。