字节笔记本
2026年10月6日 · 约 26 分钟读完
十几个微服务放心交给 AI Agent:一套四层防线方案
先说结论:十几个微服务丢给 AI Agent 干活,完全可行。但如果你只是把代码放一个 monorepo 里、每个服务丢个 README,然后跟 Agent 说"你自己看",那你迟早会经历我经历过的那些事。
我花了四个月在公司项目上踩坑,从翻车到稳定运行,这篇把整个过程写出来,重点是你可以直接拿回去用的方案和配置。不聊理论,只讲实操。
我的场景
先交代一下我的项目背景。
我们公司做的是 B2B SaaS,后端十几个微服务,Go 写的,通过 gRPC 互相调用。大致长这样:
services/
├── gateway/          # API 网关,HTTP → gRPC 转换
├── auth/             # 认证授权,JWT 签发
├── user/             # 用户管理
├── org/              # 组织/团队管理
├── billing/          # 计费订阅
├── payment/          # 支付处理(支付宝/微信/Stripe)
├── order/            # 订单生命周期
├── inventory/        # 库存管理
├── notification/     # 短信/邮件/推送
├── workflow/         # 工作流引擎
├── analytics/        # 数据分析
├── scheduler/        # 定时任务调度
└── shared/           # 公共库(proto 定义、工具函数)
十几个服务,跨四个云区域部署,gRPC 通信,protobuf 契约。典型的中大型微服务架构。
公司决定引入 AI Agent(主要是 Claude Code 和 Cursor)来提效。目标很明确:让 Agent 能独立完成涉及 2-3 个服务的 user story,人工只做 review。
听起来简单。做起来全是坑。
踩过的三个坑
坑一:Agent 改错了服务
这是最早出现的问题。我给 Claude Code 一个 user story:"用户下单成功后,发一条站内通知"。
Agent 的做法是:打开 notification 服务,加了一行调用。看起来没问题。
问题是:下单成功的领域事件应该由 order 服务发出,notification 服务是消费者。Agent 绕过了事件驱动架构,直接在 notification 里写了一个定时轮询 order 表的逻辑。跑起来能用,但完全违背了我们的架构设计:服务间耦合、轮询浪费资源、事件溯源丢失。
为什么会这样?因为 Agent 的上下文里同时有 order 和 notification 的代码,它选了一条"最短路径"来实现功能,而不是遵循我们的架构约束。
根源:Agent 不知道我们的架构约束是什么。
坑二:Context 溢出后 Agent 开始"胡编"
一个稍微复杂的 user story,比如"重构计费逻辑以支持按量付费",涉及 billing、order、payment 三个服务。Agent 在 billing 服务里读了二十几个文件,又去 order 里读了十几个,然后去 payment 里读……上下文很快就满了。
Claude Code 触发 auto-compaction 之后,Agent 开始犯一些低级错误:引用了不存在的包、混淆了两个服务的函数签名、甚至在一个服务里用了另一个服务的内部包名(Go 里是 internal/,跨服务引用必然编译失败)。
我后来查了 Anthropic 的工程博客,他们管这个叫 context rot:随着 token 数量增加,模型对早期内容的回忆精度下降。不是 Agent 变笨了,是 transformer 的注意力机制在 token 量过大时物理性地稀释了。
坑三:并行 Agent 撞车
后来我想提高效率,让两个 Agent 同时干活,一个做支付回调重构,一个做订单超时取消。各自在不同分支上工作。
周一早上起来一看:shared/ 目录下的 protobuf 生成的 Go 代码被两边都改了。一个 Agent 加了一个字段,另一个 Agent 加了另一个字段。两边生成的 *.pb.go 文件完全不同,merge conflict 一塌糊涂。
更隐蔽的是 go.sum:两边都跑了 go mod tidy,同一个依赖的不同版本被写进去了。这种 conflict 你肉眼根本看不出来哪个对哪个错。
我的解决方案:四层防线
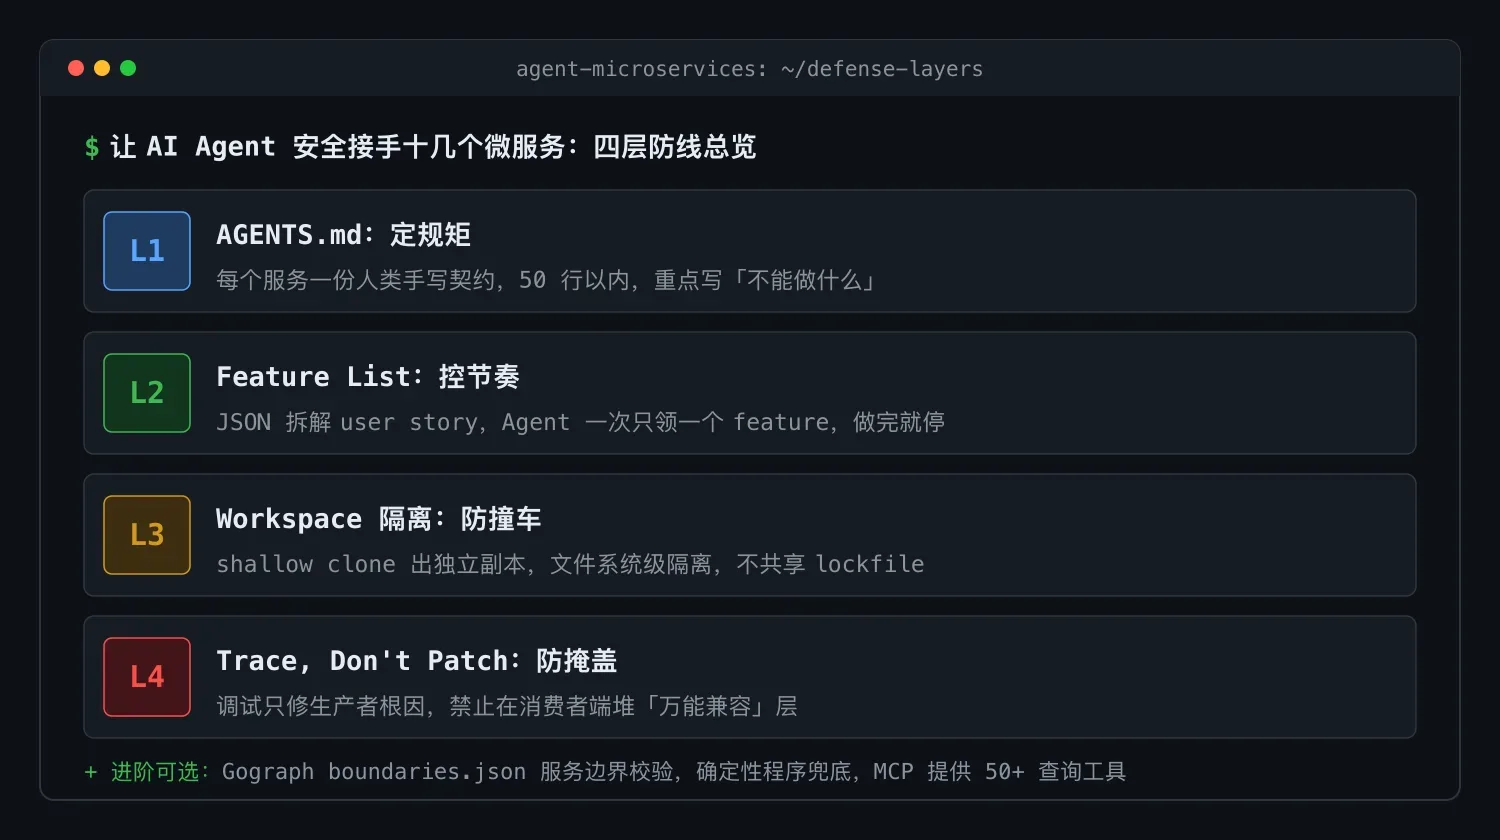
踩完坑之后我重新设计了一套方案,在我项目上已经稳定运行两个月了。分为四层:
第一层:AGENTS.md,告诉 Agent 规矩
这是最简单但最重要的一步。
我在每个服务目录下放了一个 AGENTS.md,人类手写,控制在 50 行以内。这不是文档,是契约:告诉 Agent "你能做什么、不能做什么、怎么构建和测试"。
以 services/payment/AGENTS.md 为例:
# Payment Service

## 职责
处理支付创建、回调、退款。不处理订单状态变更(order 服务负责)。
不支持直接退款超过 72 小时的订单(需人工审批流程)。

## 架构约束
- 支付结果通过 gRPC 回调通知 order 服务,不直接写 order 的数据库
- 支付状态机:PENDING → SUCCESS / FAILED / REFUNDING → REFUNDED
- 所有金额使用 int64(分为单位),禁止使用 float64

## 关键文件
- internal/handler/     — HTTP 回调处理器(支付宝/微信/Stripe webhook)
- internal/service/     — 业务逻辑层
- internal/client/      — gRPC 客户端(调用其他服务)
- api/proto/payment.proto — API 契约定义

## 构建 & 测试
go build ./...                    # 编译
go test ./...                     # 单元测试
go test -tags=integration ./...   # 集成测试(需 docker compose up)

## 绝对不能做的事
- 不要修改 webhook 的 URL 路径,支付平台那边配死了
- 不要在 handler 里直接操作数据库,走 service 层
- 不要修改 shared/protos/ 下的 proto 文件(由架构组统一管理)
- 不要添加新的支付渠道,需要架构评审
根目录也放一个全局 AGENTS.md:
# 系统架构概述

本仓库包含 13 个微服务,Go 编写,gRPC 通信。

## 服务列表
- gateway/      — HTTP 入口,路由转发
- auth/         — 认证(JWT + OAuth2)
- user/         — 用户 CRUD
- org/          — 组织管理
- billing/      — 计费逻辑
- payment/      — 支付处理(对接外部支付平台)
- order/        — 订单状态机
- inventory/    — 库存扣减
- notification/ — 通知发送(站内信/短信/邮件)
- workflow/     — 工作流引擎(DAG 执行)
- analytics/    — 数据聚合分析
- scheduler/    — 定时任务
- shared/       — 公共 proto 定义 + 工具库

## 服务间通信规则
- 所有服务间调用走 gRPC,禁止直接访问其他服务的数据库
- 领域事件通过 workflow 服务的消息总线传递
- shared/protos/ 下的 proto 文件修改需要架构评审

## Agent 工作规范
- 修改任何服务前,先读该服务目录下的 AGENTS.md
- 跨服务变更必须列出涉及的所有服务和修改点
- 每次 session 结束前:跑测试 → git commit(描述性信息)
- 不要直接修改 shared/ 下的公共库
- 遇到不确定的架构决策,停下来问,不要猜
这里有几个关键点值得注意:
第一,全局 AGENTS.md 只列服务名和一句话职责,不放细节。细节在各服务的 AGENTS.md 里。Agent 启动时读全局的获得导航,需要改哪个服务时再去读那个服务的详细规范。这正好对应 Anthropic 提倡的 just-in-time 检索:不预加载一切,按需获取。
第二,"绝对不能做的事"比"应该做的事"重要。Agent 在 context rot 之后会忘记应该怎么做,但对硬性禁止的规则记忆更持久。Coder(一个 8K star 的 Go monorepo)的 AGENTS.md 第一条规则是 "BREAKING THE LETTER OR SPIRIT OF THE RULES IS FAILURE",大写加粗。这种措辞在 prompt 里的权重比普通描述高得多。
第三,控制在 50 行以内。有学术研究验证过(arxiv 论文,2026 年初):人类手写的短 AGENTS.md 能提升 4% 的 Agent 成功率,但冗长的 AGENTS.md 最高能导致 20% 的性能下降。LLM 生成的 AGENTS.md 更是直接减分 3%。自己写,写短,写具体。
第二层:Feature List,控制 Agent 的工作节奏
Anthropic 的工程博客提出了一个叫 Harness 的模式,我改造了一下用在自己项目上。
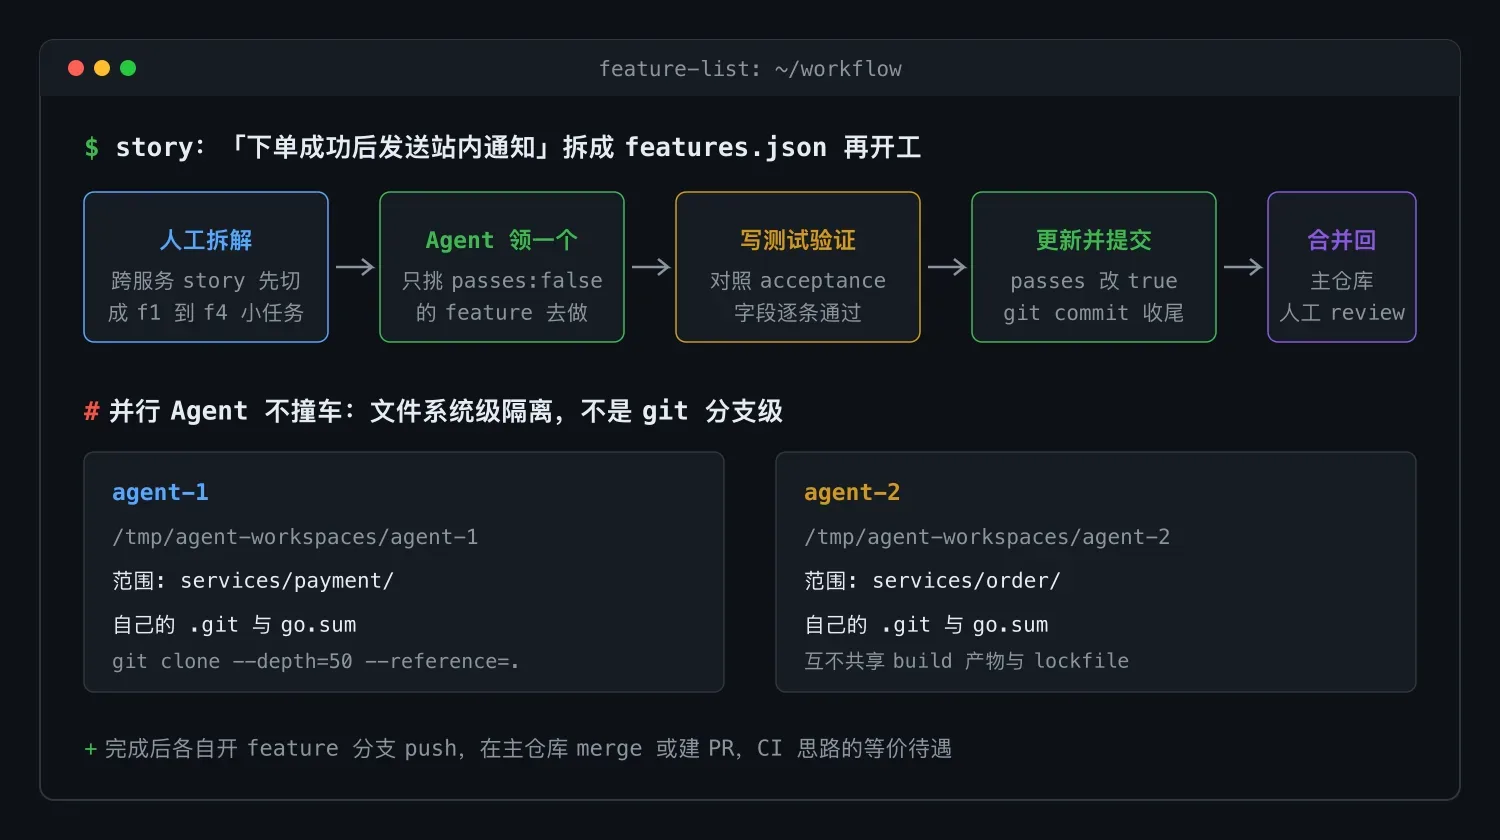
当一个 user story 涉及多个服务时,我不会直接把需求扔给 Agent 说"你去做"。我先人工拆解为一个 JSON feature list,放在项目根目录的 .ai/features.json 里:
{
  "story": "用户下单成功后发送站内通知",
  "created": "2026-06-15",
  "features": [
    {
      "id": "f1",
      "service": "order",
      "desc": "订单状态变为 SUCCESS 时,通过 gRPC 调用 notification 服务",
      "acceptance": "单元测试:mock gRPC client,验证调用参数正确",
      "passes": false
    },
    {
      "id": "f2",
      "service": "notification",
      "desc": "新增 SendOrderSuccess 接口,接收订单 ID 和用户 ID",
      "acceptance": "单元测试:验证创建站内通知记录",
      "passes": false
    },
    {
      "id": "f3",
      "service": "notification",
      "desc": "proto 文件添加 SendOrderSuccess 方法定义",
      "acceptance": "protoc 编译通过,生成代码无冲突",
      "passes": false
    },
    {
      "id": "f4",
      "service": "order",
      "desc": "集成测试:创建订单 → 验证 notification 被调用",
      "acceptance": "集成测试通过",
      "passes": false
    }
  ]
}
Agent 每次启动时读这个文件,选择一个 passes: false 的功能去做。做完之后写测试验证,更新 JSON 把 passes 改为 true,git commit。
为什么用 JSON 不用 Markdown? Anthropic 的实践结论:模型不太敢随意改 JSON 结构(怕破坏格式),但会轻易重写 Markdown 文件。JSON 里的 passes 字段比 Markdown 的 - [x] checkbox 更不容易被 Agent 误操作。
feature list 还有一个隐藏好处:Agent 不会试图一次做完所有事。一个人工拆好的 feature list 把一个大任务切成了多个独立的小任务,Agent 每次只拿一个去做,做完就停。这直接避免了"Agent 试图一口吞掉整个 user story → context 溢出 → 开始胡编"的恶性循环。
第三层:Workspace 隔离,文件系统级别的硬隔离
这是解决并行 Agent 撞车问题的关键。
我写了一个简单的 shell 脚本,给每个 Agent 创建隔离的工作空间:
#!/bin/bash
# create-agent-workspace.sh
# 用法: ./create-agent-workspace.sh agent-1 payment

AGENT_NAME=$1
SERVICE_SCOPE=$2  # 可选,限定某个服务目录
WORKSPACE_ROOT=/tmp/agent-workspaces

WORKSPACE_DIR="${WORKSPACE_ROOT}/${AGENT_NAME}"

# 用 shallow clone + reference 创建隔离副本
git clone --depth=50 --reference=. . "${WORKSPACE_DIR}"

# 如果指定了服务范围,只保留相关文件以减少干扰
if [ -n "$SERVICE_SCOPE" ]; then
    # 在 CLAUDE.md 里记录工作范围
    echo "" >> "${WORKSPACE_DIR}/CLAUDE.md"
    echo "## 当前任务范围" >> "${WORKSPACE_DIR}/CLAUDE.md"
    echo "本次 session 只修改 services/${SERVICE_SCOPE}/ 目录。" >> "${WORKSPACE_DIR}/CLAUDE.md"
    echo "不要修改其他服务。" >> "${WORKSPACE_DIR}/CLAUDE.md"
fi

echo "Agent workspace created: ${WORKSPACE_DIR}"
echo "Start Claude Code with: cd ${WORKSPACE_DIR} && claude"
使用方式:
# Agent-1 做支付相关的工作
./create-agent-workspace.sh agent-1 payment

# Agent-2 做订单相关的工作(同时进行)
./create-agent-workspace.sh agent-2 order

# 各自启动 Claude Code
cd /tmp/agent-workspaces/agent-1 && claude
cd /tmp/agent-workspaces/agent-2 && claude
关键点:
--depth=50只克隆最近 50 个 commit,速度极快(几秒钟)--reference=.指向源仓库,不重复下载对象- 每个 Agent 有自己的目录、自己的
.git/、自己的go.mod、自己的vendor/(如果用 vendor 模式) - 没有共享的 lockfile,没有共享的 build 产物
做完之后合并回来:
cd /tmp/agent-workspaces/agent-1
# 创建 feature branch 并 push
git checkout -b agent-1/payment-refactor
git push origin agent-1/payment-refactor
# 然后在主仓库 merge 或 create PR
这套方案借鉴了 CI/CD 的思路:GitHub Actions 每次跑都是隔离环境,你的 Agent 也应该有同等待遇。
第四层:Trace, Don't Patch,约束 Agent 的调试行为
这是我在项目上花了最多时间打磨的一条规则,也是效果最显著的。
有一次 Agent 修 bug 的方式让我冒冷汗:一个接口返回的 timestamp 格式不对,Agent 没去找根因,而是在消费者端加了一层类型转换,"能兼容任何格式"。生产者的问题被掩盖了,而且这种兼容代码散布在好几个服务里。
从那以后,我在全局 AGENTS.md 里加了一条铁律:
## 调试规范:Trace, Don't Patch

当修复一个 bug 时,Agent 必须遵守以下步骤:
1. 找到错误首次出现的位置(生产者/源头)
2. 理解数据从生产者到消费者的完整流转路径
3. 在生产者端修复根本原因
4. 如果消费者端需要添加防御性代码,必须同时修复生产者

禁止行为:
- 不要在消费者端添加"万能兼容"函数来掩盖生产者的 bug
- 不要在多个消费者里复制粘贴相同的容错逻辑
- 如果生产者是第三方服务(支付宝回调等),在 consumer 端加防御性代码可以,
  但必须添加注释说明为什么不能修生产者
这条规则在我项目上救了不止一次。它直接避免了一种最危险的 Agent 行为:用"灵活兼容"掩盖真实 bug。因为 Agent 不会有愧疚感,它只优化它被给定的目标函数,你让它修崩溃,它就修崩溃,至于修得漂不漂亮它不在乎。
补充方案:Gograph 服务边界约束(进阶)
如果你对安全性要求更高,AGENTS.md 的文字约束不够:Agent 在 context rot 之后会忘记。
我们最近在试用 Gograph,一个 Go 的 AST 图数据库。你写一个 boundaries.json 定义哪些包可以互相引用:
{
  "boundaries": [
    {
      "name": "payment-service",
      "allow": ["services/payment/...", "shared/protos/..."],
      "deny": ["services/order/...", "services/user/..."]
    },
    {
      "name": "order-service",
      "allow": ["services/order/...", "shared/protos/..."],
      "deny": ["services/payment/...", "services/billing/internal/..."]
    }
  ]
}
Gograph 通过 MCP 接口给 Agent 提供 50+ 个查询工具。Agent 想了解代码结构?查图数据库,不用 grep 盲搜。Agent 想改代码?先过边界校验,违反约束直接拒绝。
作者做过性能测试:用 Gograph 查询代码结构比让 Agent 用 grep 搜索,token 消耗减少 93%。更重要的是,它是确定性程序,不是 prompt 约束,Agent 忘了规则也没关系,程序不会忘。
不过这套方案比较重,适合服务数量多、对架构纪律要求严格的大型项目。小团队用前三层就够了。
每天的工作流
最后说一下我实际每天怎么用这套东西的。
早晨:
# 1. 同步主仓库
git pull origin main

# 2. 看今天的 feature list
cat .ai/features.json

# 3. 为今天的任务创建 Agent workspace
./create-agent-workspace.sh today order
启动 Agent:
cd /tmp/agent-workspaces/today && claude在 Claude Code 里的开场 prompt(我已经存成了 snippet):
读 .ai/features.json,选择一个 passes: false 的功能去做。
做完后:写测试验证 → 更新 features.json → git commit。
只做一个功能,做完就停。
做完一个功能之后:
# 在 workspace 里 commit
git add -A && git commit -m "feat(order): 订单成功后通过 gRPC 调用 notification 服务

- 添加 order → notification 的 gRPC client 初始化
- 在订单状态机 SUCCESS 状态触发通知调用
- 单元测试:mock gRPC client 验证调用参数

Feature: f1 of '用户下单成功后发送站内通知'"

# 合并回主仓库
cd /path/to/main/repo
git fetch /tmp/agent-workspaces/today
git merge FETCH_HEAD
一天结束:
# 清理 workspace
rm -rf /tmp/agent-workspaces/today

# 检查今天的 feature list 进度
cat .ai/features.json | grep '"passes": false' | wc -l  # 剩余未完成
一个反直觉的经验
我发现把 Claude Code 的上下文窗口从 1M 缩到 200K 反而效果更好。环境变量:
CLAUDE_CODE_DISABLE_1M_CONTEXT=1
CLAUDE_AUTOCOMPACT_PCT_OVERRIDE=70
70% 就触发 compaction,强制 Agent 更频繁地"清理记忆"再重新聚焦。配合 feature list(每次只做一个功能),Agent 永远不需要太大的上下文。
JetBrains 有个研究数据:sub-agent 架构(专门化的小 Agent 各干各的,只返回摘要给主 Agent)比单 Agent 长会话成本降低 52%,效果更好。我现在的做法本质上就是这个思路:每个 feature 就是一个 sub-agent 的任务范围。
最后总结
四个月踩坑下来,我的方案就四句话:
1. AGENTS.md 定规矩(人类手写,50 行以内,重点写"不能做什么")
2. Feature List 控节奏(JSON 格式,每次只做一个功能,做完就停)
3. Workspace 隔绝碰撞(shallow clone 隔离,文件系统级别,不是 git 分支级别)
4. Trace Don't Patch 防掩盖(追根溯源修生产者,不修消费者兼容层)
前三层零成本,半小时就能搭好。第四层是写进 AGENTS.md 的一段文字,零代码改动。Gograph 是可选的进阶方案,适合大型项目。
从"Agent 改错服务"到"Agent 按规矩干活",对我来说就是这四层防线的事。
本文方案基于 Anthropic 工程博客的 Context Engineering 和 Harness 理论,参考了 Coder、Cloudflare、Datadog 的 AGENTS.md 实践,以及 Gograph 的服务边界约束方案。所有配置和脚本均已在实际项目中验证。