字节笔记本
2026年10月6日 · 约 7 分钟读完
给 DeepSeek Harness 加个新包,总共五步
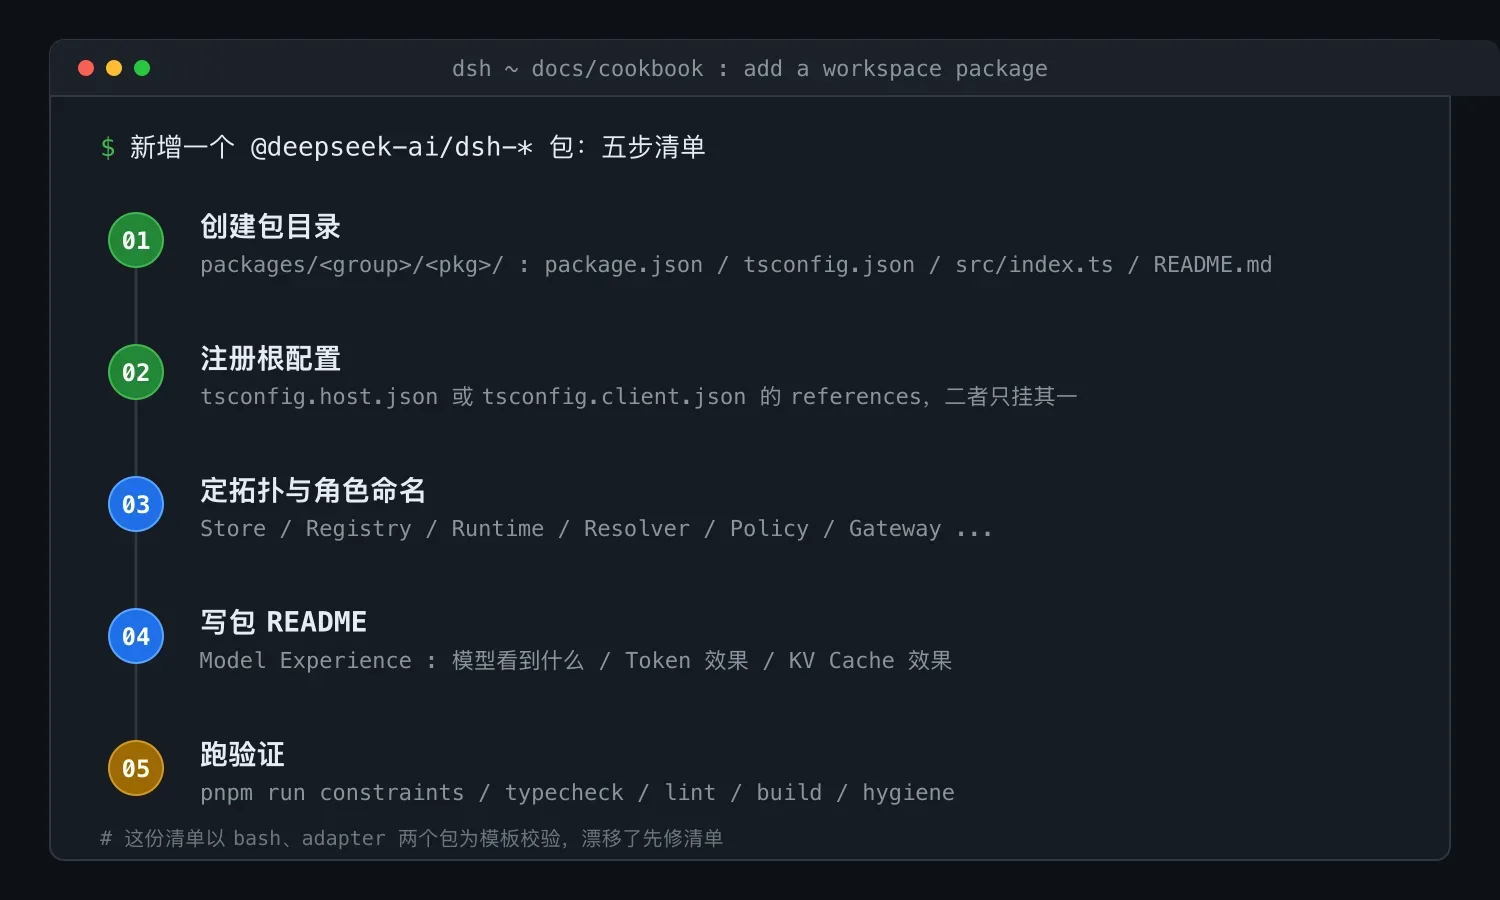
DeepSeek Harness 是 DeepSeek 开源的 agent 框架,整个仓库按 pnpm workspace 拆成几十个 @deepseek-ai/dsh-* 前缀的包。包一多,怎么加一个新包就不再是随手建目录的小事:文件怎么摆、根配置改哪里、名字怎么起、文档写什么,每一处都影响后面几十个包的一致性。项目在贡献者手册的 cookbook 里给出了一份五步清单,并特别注明:这份清单以 bash、adapter 两个包为模板校验过,一旦和模板出现漂移,先修清单本身。本文把这套流程整理出来,就算你不碰这个项目,它对维护任何大型 TypeScript monorepo 也有直接的参考价值。
第一步:创建包目录
新包固定放在 packages/组名/包名/ 两层路径下。组只是一个纯容器:不允许有自己的 package.json 和源码,包永远紧贴在组下一层。官方预备了 core、llm、bash、compact、subagent、todo、session-persistence、ui、util、support 十个组,角色匹配就复用,实在不匹配也允许新开一个组。
一个包最少四个文件。package.json 从现有包复制后改名字、描述和依赖;tsconfig.json 继承根上的 tsconfig.base.json,用 project references 声明对 cosmokit、cordis 这些被 vendor 进仓库的依赖,以及同仓库其他 dsh 包的引用;src/index.ts 放服务的默认导出,或者一个带 name、inject、apply、Config 四件套的插件;README.md 写服务 API、事件、扩展点和设计笔记。
package.json 上挂着一整组硬性不变量,由 pnpm run constraints 背后的检查脚本强制执行:必须是私有包,version 和根 package.json 保持一致;type 固定为 module;入口固定指向 lib/index.js 和 lib/types/index.d.ts;@deepseek-ai/cordis 必须同时出现在 peerDependencies 和 devDependencies 里,而且版本范围一致;@deepseek-ai/schemastery 因为是运行时校验器,放进 dependencies;files 白名单只允许 lib 产物和声明文件,src、declaration map、sourcemap、过期的根声明文件一律不许发布。带命令行入口的包,还要把 lib/bin.js 紧挨着 lib/index.js 排进 files。
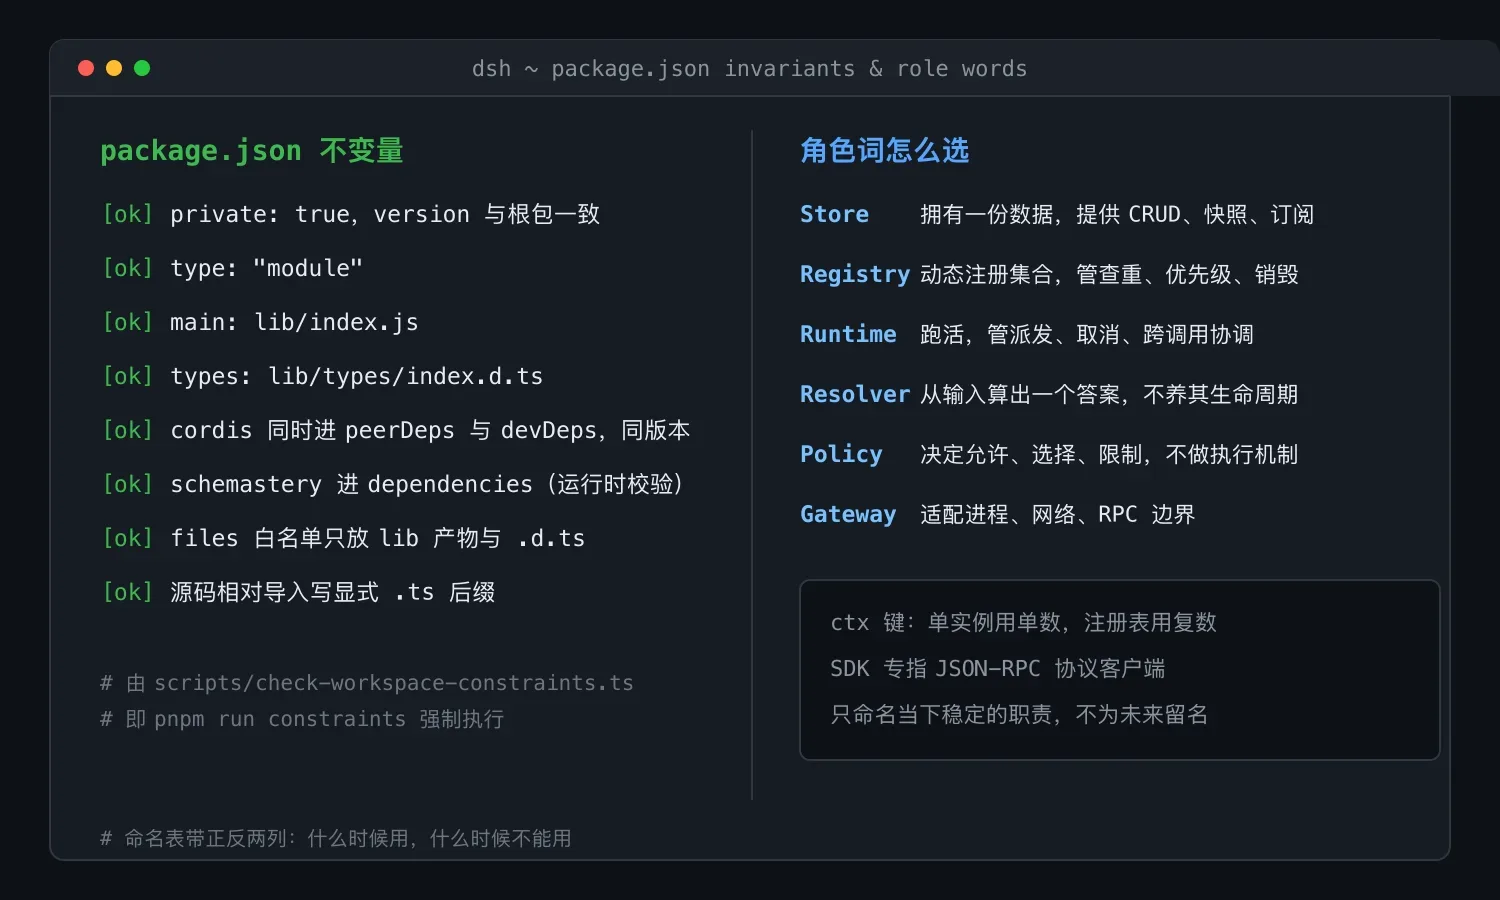
还有一个容易踩的细节:源码内部的相对导入要写显式的 .ts 后缀,编译器会在编译产物里改写成 .js,而声明文件里保留 .ts,这样按 NodeNext 规则解析的使用者能找到同名的 .d.ts。
第二步:注册根配置
包建好后要在根配置里挂号。tsconfig.base.json 只有新开组时才需要加一条通配;普通包要么进 tsconfig.host.json,要么进 tsconfig.client.json 的 references 列表,一个包只属于一个聚合工程,不允许两边都挂。client 系的包还有附加约定:继承单独的 tsconfig.base.client.json,在 package.json 里声明 dsh.client,导出 ./client 入口,并复用共享的 tsdown 构建预设。knip.json 只在仓库的自动发现覆盖不到包的入口时才需要改。
好消息是有一批文件完全不用动:根 package.json 的 workspaces、publint 脚本、tsdown 主配置、oxlint 配置和约束检查脚本,都靠通配和清单发现自动覆盖新包。
第三步:定拓扑,起对名字
不是所有能力都值得独立成包。清单给的判据是角色是否独立演化:服务定义、服务提供方、消费方这三种角色如果会各自变化,就拆成不同的包;单一用途的插件维持一个包就够。
命名规则是整份清单里最见功力的部分,核心只有一句:命名当下稳定的职责。不为第一个实现命名,不为可能的未来扩展命名,也不照抄基类的名字。上下文键的单复数必须和角色对齐:一个引擎、一个策略、一个存储用单数键,注册表这类拥有多个具名成员的服务用复数键;同一个 Cordis Context 键不允许在宿主和客户端两侧挂不兼容的声明,TypeScript 的声明合并会把两张脸都暴露出来。
清单还附了一张角色词表,每个词都写了适用和不适用两列。摘几条感受一下分寸:Store 是拥有一份数据、主要提供增删改查、快照或订阅的类型,内部恰好是个 Map 不构成叫 Store 的理由;Registry 拥有一组动态注册并管查重、优先级和销毁,如果它的主契约是派发或编排,就不配这个名字;Runtime 负责跑活,跨调用拥有派发、取消和提供方协调;Resolver 从输入算出一个答案,但不拥有答案的生命周期。另外 SDK 这个词被严格保留给 JSON-RPC 协议客户端,项目明确说自己是个 agent harness,不是 SDK 项目;产品名的唯一合法拼法是 Typert。
第四步:写包 README
README 的结构也是被脚本看管的。正文先写包自己的服务 API、配置、事件、扩展点和设计笔记,结尾必须是两段固定内容:Model Experience 和 Known Limitations and Deferred Work。前者按顺序回答三个问题:模型看到了什么数据,对 token 的影响是固定、条件触发还是封顶,对 KV Cache 是只追加、前缀稳定还是替换;系统提示词这类稳定文本要求原文引用进 markdown 围栏,数据相关的文本只做摘要。后者记录消费者可见的能力缺口和非显然的维护者约束,日常的小清理留在源码 TODO 里。完全没有上下文效果的包,也必须用经过审计的固定句式开头,比如 None, as 起头的一句话,不许自由发挥。
第五步:验证
最后是固定的命令序列:pnpm install 让工作区认识新包,然后依次跑 doc-sync、constraints、typecheck、lint、build、hygiene,行为测试和覆盖率按仓库的测试政策补齐。任何一步红灯,包就不算完成。
写在最后
这套清单真正值得抄的不是某条命令,而是把约定做成可执行检查的思路:不变量交给约束脚本,README 结构交给验证器,命名写成带正反例的词表。新包从创建那一刻起就没有走样的空间,审阅者可以把精力留给真正需要人判断的拓扑与命名决策。如果你的 monorepo 还在靠口头约定和代码评审兜底,这份清单是一个现成的模板。