字节笔记本
2026年10月7日 · 约 7 分钟读完
让 AI 生成的 HTML 双击就能跑:零依赖占位与排错
让 AI 照着截图生成一个页面,几乎是现在最快的前端起手式:一轮对话,结构完整、样式齐备的 HTML 就到手了。但这份代码离"能用"还差一步——最近一次页面还原实践里,AI 一次给出的代码拷到本地打开,页面却"没显示"。排查下来,问题不在代码逻辑,而在代码默认了一个"有网络、有后端"的运行环境。这篇文章复盘这次踩坑:这类故障怎么定位,以及怎么把页面写成零外部依赖、拷贝走双击就能跑的形态。
一、坑从哪来:一份默认环境齐全的代码
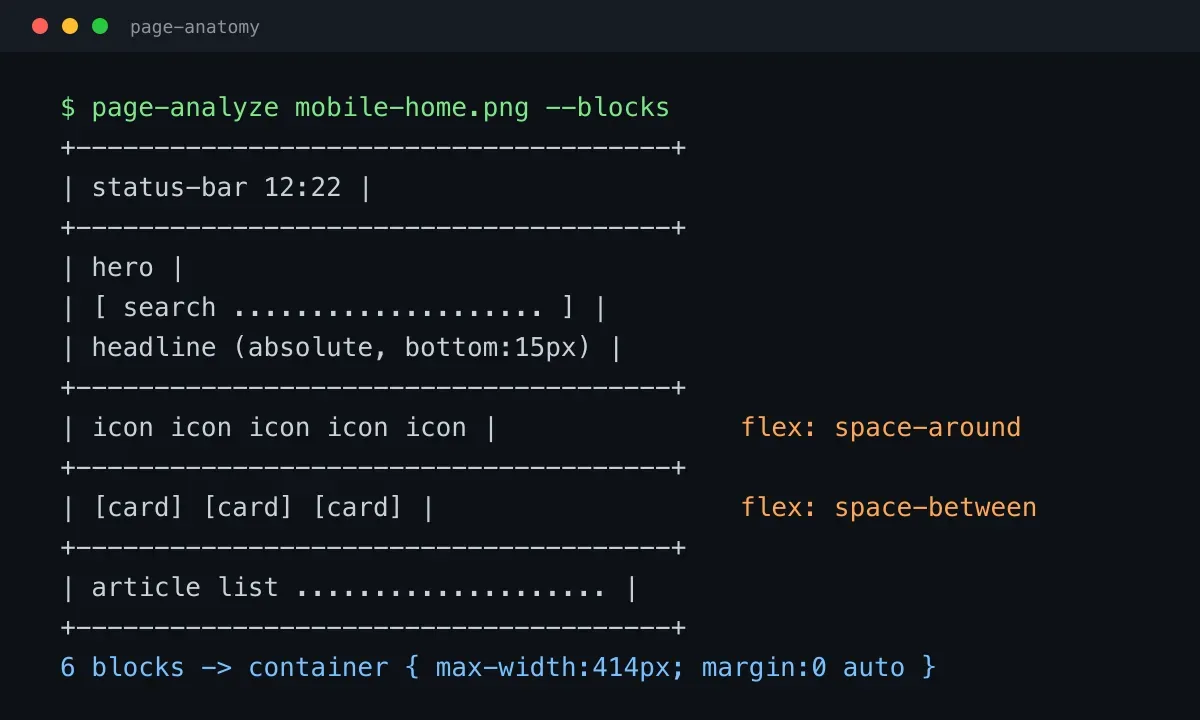
先交代背景。那次还原的目标是某教育类移动端首页,整页从上到下六个区块:状态栏、带搜索框的 Hero 横幅、五个学科图标栏、三张项目卡片、三条项目描述、一个文章列表。先拆块再动手,是截图还原的基本功:块级元素默认从上到下堆叠,六个区块就是六个依次排列的 div,每个块内部再单独处理横向排列或叠层。拆分时顺手记下重复模式——同样的卡片出现三次、同样的间距贯穿全页——它们意味着可以共用同一组 class,代码量从"每个区块各写一套"降到"一套样式多处套用"。骨架是标准的文档流堆叠,块内横向排列交给 Flexbox:
.container      { max-width: 414px; margin: 0 auto; } /* 定宽容器模拟手机屏 */
.category-icons { display: flex; justify-content: space-around; }
.project-cards  { display: flex; justify-content: space-between; }
Hero 区用 position: relative 定住父元素、内容块 absolute 贴底,是"图上文"布局的标准写法。这套组合拳本身没问题,代码也一次成型。
真正的坑在资源引用上。生成的代码里有两类占位图:一类指向 via.placeholder.com 这样的外部占位图服务;另一类写成 /api/placeholder/40/40 这样的相对路径——它只在生成代码的沙箱环境里有后端响应,一旦把文件拷回本地,这个接口根本不存在,全部 404。外部服务则看网络脸色,离线或被墙时同样全军覆没。更要命的是,布局里图标和横幅的高度部分依赖图片撑起,图挂了区块就塌,视觉上等于整个页面"没显示"。
这类问题的迷惑性在于:代码本身挑不出毛病,语法正确、结构合理,换一个有网有后端的环境也许就能跑。它把"代码正确"和"代码可运行"之间的缝隙暴露得清清楚楚。
二、排查链:从外到内三层定位
页面"没显示"时,先别急着怀疑代码逻辑,按从外到内的顺序走三层:
第一层,文件本身。 代码是否保存成了 .html 扩展名?从 AI 的回答里复制代码时,一个常见事故是编辑器默认存成了 .txt,或在不显示扩展名的系统里存成 index.html.txt,双击打开的自然不是浏览器。编码也要确认为 UTF-8——中文页面用错编码,轻则乱码,重则保存异常。
第二层,资源加载。 打开浏览器开发者工具,Network 面板里一片红色 404,就说明 HTML 已被正常解析,挂掉的是资源请求。这一眼就能把"代码错了"和"图没加载"区分开——凭肉眼看渲染结果,是分不出这两种故障的。
第三层,运行环境。 直接双击打开的页面走 file:// 协议,浏览器对它有额外限制:fetch 请求、ES 模块脚本都会被安全策略拦下。纯静态展示页无所谓,但代码里一旦用到这类特性,白屏的原因就又多了一条。这时别再和 file:// 较劲,本地起一个静态服务器更省事:Python 自带的 python3 -m http.server,或 npx serve 一类的小工具,一条命令就能把目录挂在 localhost 上,环境限制随即消失。
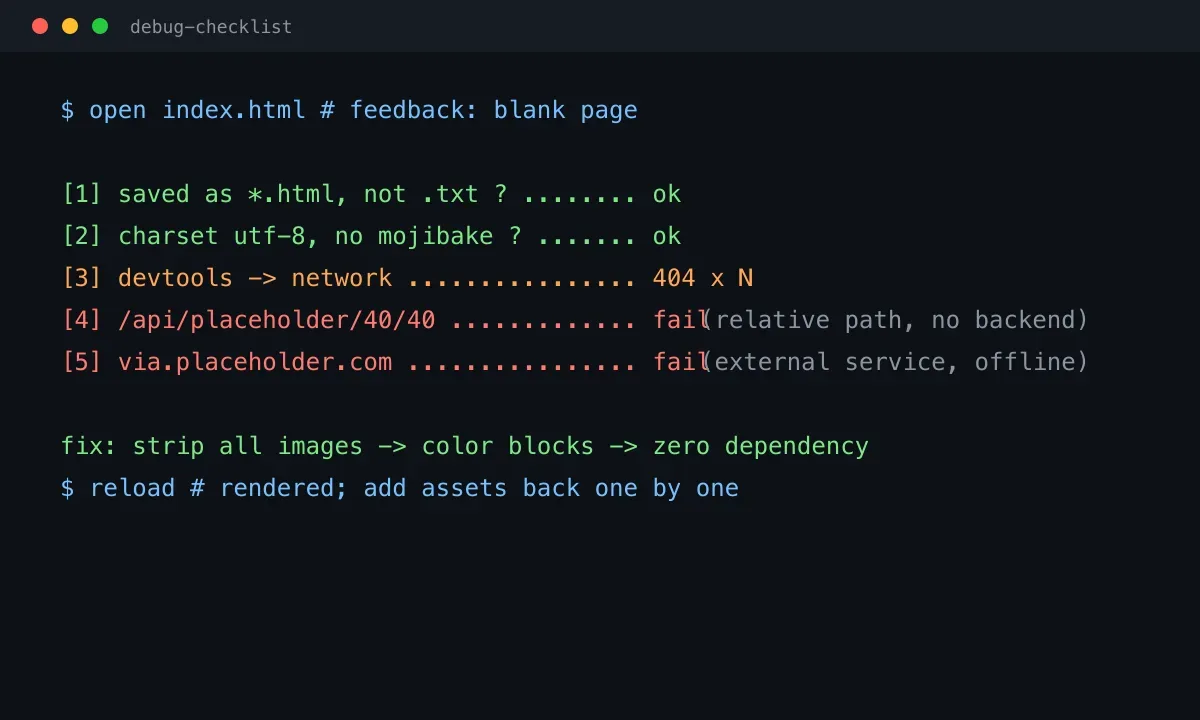
分层定位的价值在于每次只查一件事,三层走完,那次故障的答案已经清楚:扩展名和编码都对,404 集中在占位图路径上。
三、最小化复现:删到能跑,再逐项加回
定位之后,修复方式是做减法:第二版代码把所有图片全部删掉,图标换成纯色圆角块,背景图换成纯色,页面立刻在本地渲染成功。这不是妥协,而是调试的正确姿势——先把"能跑"的最小版本立起来,再逐项把资源加回去,每加一个验证一个。
"删到能跑"的本质是控制变量。一份页面代码里的不确定因素有三层:文件、资源、环境,全堆在一起时谁也说不清是哪层出了问题;删光外部依赖后剩下的确定内核,就是继续排查的基准线。这个思路对任何"AI 给了代码但跑不起来"的场景都成立,先缩小变量,再谈功能完整。加回资源时也有讲究:优先把图片下载到本地随页面一起存放,而不是继续依赖外部服务——验证阶段的目标是稳定,不是省事。
四、零依赖占位的正确姿势
要让一份 HTML 拷贝就走、双击就开,占位资源应该按零外部依赖来设计,从稳到真排个序:
- 色块占位:div 加固定宽高和背景色,最稳,不产生任何请求;
- CSS 渐变:需要模拟图片质感时用 linear-gradient;
- data URI:确实需要小图标时内联 base64,同样不依赖网络,代价是 HTML 体积膨胀、且无法被浏览器单独缓存,只适合小图标;
- 真实资源:等布局验证完再统一替换上线。
还有两个容易忽略的细节。一是占位元素要给明确尺寸:图片加载失败时,没有设置宽高的 img 会塌缩成零,布局随之错乱;色块天然有尺寸,反而比真图更适合当骨架。二是 viewport meta 要和定宽容器配套,缺了它,真机会按约 980px 的默认视口缩放渲染,414px 的容器在小屏上反而显得很小。
再往前走一步,还原时的区块切分和命名就是组件化的雏形:六个区块对应六个组件,反复出现的色值、圆角、间距可以提炼成设计令牌统一维护。还原一张页面得到的若是语义清晰、可复用的结构,它就不只是"像",而是能继续长成真实项目的骨架。
收尾
回头看这次踩坑:AI 生成页面代码的完成度已经很高,结构拆解、Flexbox 布局、叠层定位一次到位,这些是套路化的部分;真正卡住人的,是代码之外的运行环境与资源依赖。对应的解法也沉淀成了通用方法论:分层定位(文件、资源、环境)、最小化复现(删到能跑)、零依赖占位(色块与渐变先顶上)。AI 能给出八十分正确的代码,让它在你的环境里跑起来,才是工程的完整闭环。