字节笔记本
2026年10月6日 · 约 52 分钟读完
AI 工作流专栏 23:AI 应用可观测性实战
本文是《从零成为 AI 工作流工程师》专栏第 23 篇,主题是可观测性。翻开任意一份 AI 工作流工程师的 JD,几乎都有一行字:建立 AI 工作流的评估与监控体系,覆盖输出准确率、Token 成本、响应延迟和异常降级。让 AI 跑起来只是第一步,跑起来之后你怎么知道它跑得好不好,才是更扎心的问题。这里有个传统软件工程师最容易踩的坑:传统应用上线,只要没报错基本就是好的;AI 应用是概率黑盒,它答错了也不会报错,只会一本正经地胡说八道。你不主动监控,根本发现不了它在烧钱、变慢、胡扯。
本篇把可观测性的三支柱(Logs / Metrics / Traces)讲透,重点拆解 AI 特有的监控维度(Token 成本、TTFT 首字延迟、幻觉率、召回率),最后用 Langfuse + Prometheus + Grafana 这套开源组合,给你的 RAG / Agent 项目装上"仪表盘和黑匣子"。这是从"能跑的 demo"迈向"敢上生产"的关键一跃。
你将学到:
- 为什么 AI 应用比传统应用更需要可观测性("答错了也不报错"的本质)
- 可观测性三支柱 Logs / Metrics / Traces 各是什么、三者怎么配合
- AI 应用区别于传统监控的六大特有维度(Token / 延迟 / 质量 / 召回等)
- 传统三件套(Prometheus + Grafana + Loki)与 AI 专用工具(Langfuse / LangSmith / Helicone / Phoenix)怎么选
- Langfuse 实战:Docker 自部署,用
@observe()给 LLM 调用加 trace,给 RAG 加完整链路 - Prometheus 实战:用 prometheus_client 暴露请求计数 / 延迟直方图 / Token 计数
- 配一个 Grafana 仪表盘看 QPS / P99 延迟 / Token 成本
- 告警体系:哪些指标该告警,用 Alertmanager 配规则
- 把监控代码加进自己的 RAG / Agent 项目
一、为什么 AI 应用特别需要可观测性
1.1 生活类比:开车仪表盘
想象你开着车上高速。传统软件就像一辆"坏了才会响"的老车:发动机一旦出问题,仪表盘立刻亮红灯(报错),你停下来修就行。绝大多数时候,车要么正常跑、要么直接抛锚,状态是二元的。
但 AI 应用更像在开一辆"看起来一直正常、其实可能早就偏航"的智能车:
- 油表(Token 成本)在悄悄见底,你不看仪表盘根本不知道这个月烧了多少钱;
- 速度(响应延迟)从 1 秒涨到了 8 秒,用户体验已经崩了,但代码一个错都没报;
- 导航(回答质量)把你带错了路(幻觉),可车还是"平稳行驶",没有任何警报。
这就是 AI 应用最坑的地方:它是概率系统,不是确定性系统。一个 RAG 问答机器人,今天答对了,明天同一个问题可能就答错,而且答错了也不报错,HTTP 状态码依然是 200,日志里干干净净。
1.2 传统监控 vs AI 监控的本质差异
| 维度 | 传统软件 | AI 应用 |
|---|---|---|
| 系统性质 | 确定性(if-else) | 概率性(黑盒推理) |
| "出错"的判定 | 抛异常 / 状态码非 2xx | 答错也不报错,需要外部评估 |
| 核心指标 | QPS、错误率、CPU/内存 | + Token 成本、延迟、幻觉率、召回率 |
| 单次请求复杂度 | 一次函数调用 | 多步链路(检索 → 重排 → 生成 → 工具调用) |
| 调试方式 | 看堆栈 | 看 trace + prompt + output |
一句话总结:传统软件你盯报错,AI 应用你盯"质量 + 成本 + 延迟"。这三样都不会主动告诉你,必须靠可观测性体系去"看见"。
1.3 小结
- 传统软件是确定性系统,报错即故障;AI 是概率黑盒,答错了也不报错。
- 因此 AI 应用必须主动监控:质量(准不准)、成本(烧多少)、延迟(快不快)三件套。
- 给 AI 装可观测性 = 给智能车装仪表盘 + 黑匣子,让你随时知道"它在干嘛、干得好不好"。
二、可观测性三支柱:Logs / Metrics / Traces
2.1 生活类比:开餐厅的三个账本
想象你开了一家餐厅,要搞清楚"生意到底怎么样"。你需要三本账:
- 流水小票(Logs 日志):每一桌点了什么菜、几点来的、哪个服务员接的单。粒度最细,看每一次具体事件。出了纠纷(某桌投诉),你就翻小票找细节。
- 日报表(Metrics 指标):今天总营业额、平均上菜时间、翻台率。粒度最粗,是聚合后的数字。你看日报表判断"今天比昨天好不好",但看不出某一桌的细节。
- 后厨传菜单(Traces 链路):某一桌的菜从"点单 → 备料 → 炒菜 → 装盘 → 上桌"经过的完整路径,每一步耗时多久。重点在"关联"和"顺序":哪一步卡了,一眼看到。
三本账缺一不可:只有小票看不出趋势,只有报表查不了细节,只有传菜单不知道整体健康度。可观测性就是这三本账合在一起。
2.2 专业定义
可观测性(Observability)= 通过系统的外部输出(日志、指标、链路),推断系统内部状态的能力。
它由三支柱构成:
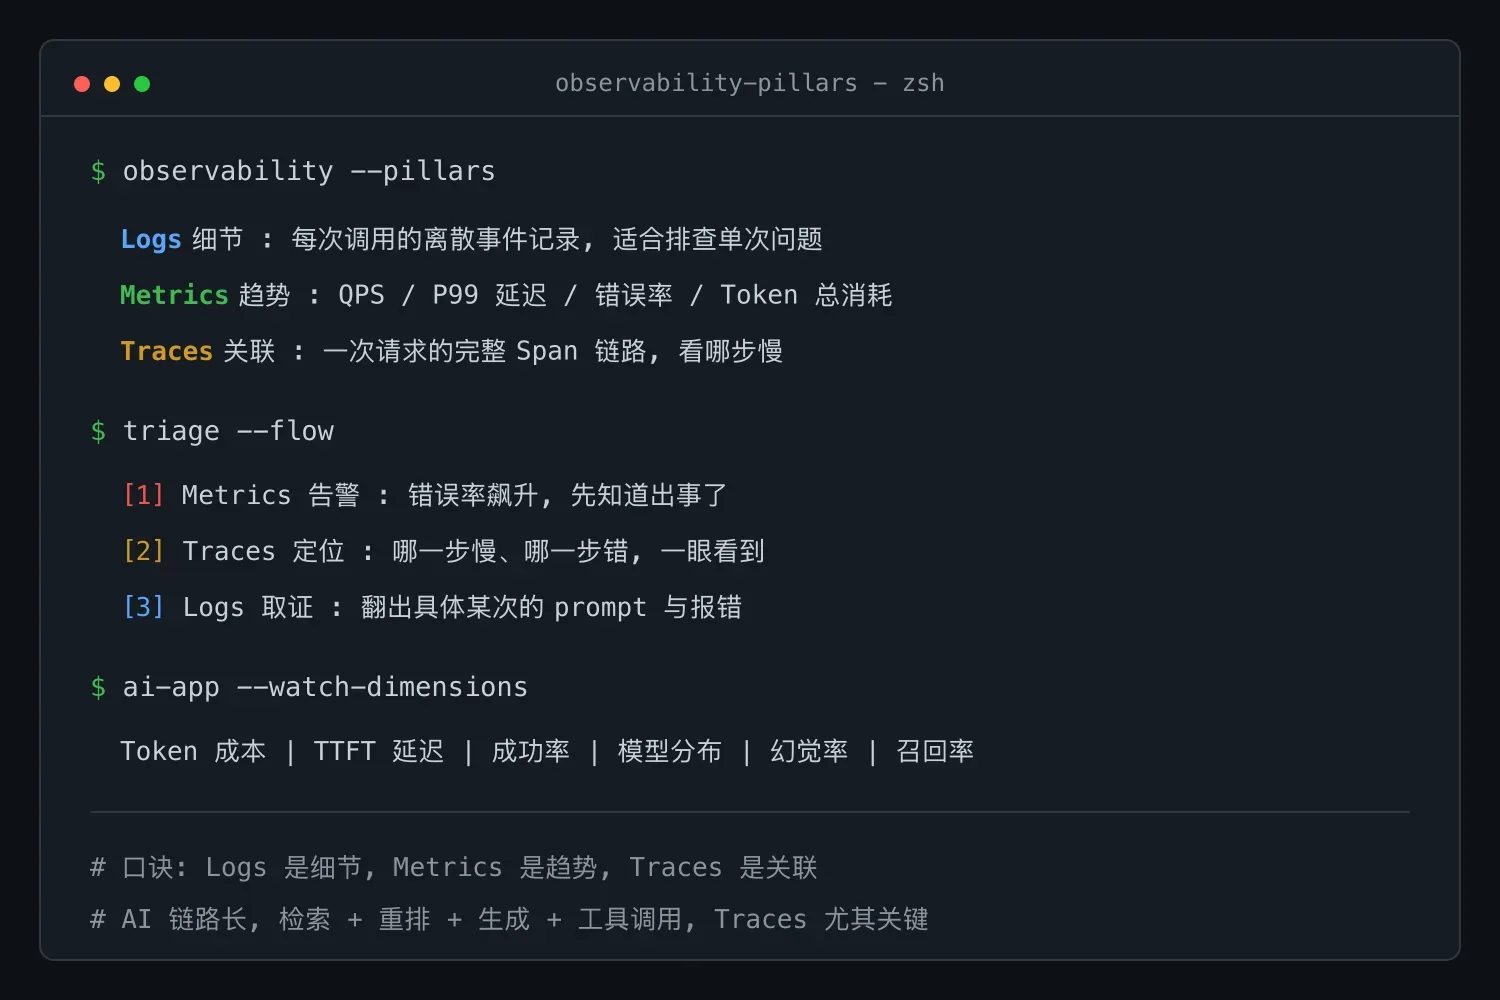
① Logs(日志):离散事件记录
记录"谁、在什么时候、做了什么、结果如何"。是一条条离散的文本/JSON。
import logging
logging.basicConfig(level=logging.INFO)
log = logging.getLogger("ai-app")

# 一条日志:记录一次 LLM 调用的细节
log.info("LLM 调用",
         extra={"user_id": "u_123", "model": "gpt-4o-mini",
"prompt_len": 320, "status": "success"})特点:信息最全、最适合排查单次问题;缺点是量大、不好做趋势分析。
② Metrics(指标):聚合数值
把大量事件聚合成数字:QPS(每秒请求数)、P99 延迟、错误率、Token 总消耗。
from prometheus_client import Counter

# 一个指标:累计统计 LLM 调用次数
llm_calls = Counter("llm_calls_total", "Total LLM API calls", ["model", "status"])
llm_calls.labels(model="gpt-4o-mini", status="success").inc() # +1特点:适合看趋势、设告警;缺点是丢了细节(你看不出是哪个用户触发的)。
③ Traces(链路追踪):一次请求的完整路径
把一个请求经过的所有步骤串成一条链,每一步叫一个 Span。
用户提问 "RAG 怎么切片?"
 └─ [Span] 接收请求 (2ms)
 └─ [Span] 向量检索 (45ms) ← 找到 5 条相关文档
     └─ [Span] Embedding 编码 (20ms)
 └─ [Span] 重排序 (15ms)
 └─ [Span] LLM 生成 (820ms) ← 输入 800 token,输出 120 token
 └─ [Span] 返回响应 (1ms)
总耗时: 903ms特点:最适合定位"慢在哪一步"和"复杂链路的关联";缺点是每个 trace 有采样开销,不能全量记。
2.3 三者怎么配合
记住这个口诀:
Logs 是细节,Metrics 是趋势,Traces 是关联。
典型排障流程:告警来自 Metrics(错误率飙升)→ 用 Traces 定位是哪一步慢/错 → 用 Logs 看具体某次的 prompt 和报错内容。三者环环相扣,缺一个都难查。
2.4 小结
- Logs = 离散事件,看细节;Metrics = 聚合数值,看趋势;Traces = 请求路径,看关联。
- 三者配合:Metrics 告警 → Traces 定位步骤 → Logs 查具体内容。
- AI 应用因为链路长(检索 + 生成 + 工具),Traces 尤其重要,这是它区别于传统 CRUD 应用监控的关键。
三、AI 应用的特有监控维度
传统应用监控 CPU / 内存 / QPS / 错误率就够了。AI 应用还要多盯6 个独有维度,这些是 JD 里"准确率、Token 成本、响应延迟"的具体落地。
3.1 六大维度详解
维度 ①:Token 消耗与成本
这是 AI 应用最独特的指标:每一次调用都在烧钱。要拆成三个数:输入 token、输出 token、折算成本(按模型单价算)。
# OpenAI 返回里自带 usage 字段
resp = openai.chat.completions.create(...)
input_tokens = resp.usage.prompt_tokens        # 输入 token
output_tokens = resp.usage.completion_tokens   # 输出 token
cost = input_tokens * 0.15 / 1e6 + output_tokens * 0.60 / 1e6  # 按模型单价折算($/M token)
监控意义:发现"某个用户一天烧了 50 块""某条 prompt 越来越长",成本失控往往就是这样悄悄发生的。
维度 ②:响应延迟(重点看 TTFT)
AI 延迟不能只看总时间,要拆成两段:
- TTFT(Time To First Token,首 token 时间):从发请求到吐出第一个字的时间。用户体感主要看这个:首字快,用户就觉得"反应快"。
- 总时间(Total Latency):从发请求到全部生成完。长文本生成时,总时间天然就长。
import time
t0 = time.perf_counter()
stream = openai.chat.completions.create(..., stream=True)
first_token_time = None
for chunk in stream:
    if chunk.choices[0].delta.content:
        if first_token_time is None:
            first_token_time = time.perf_counter() - t0  # TTFT
        # ...处理 token
total_time = time.perf_counter() - t0
print(f"TTFT={first_token_time:.2f}s, Total={total_time:.2f}s")
监控意义:TTFT 突然从 0.5s 涨到 3s,说明推理服务排队了或网络抖了,比看总时间更能定位问题。
维度 ③:调用成功率 / 错误率
不只是 HTTP 错误率,还要区分错误类型:
- 网络错误(超时、连接拒绝):重试可解决
- 限流错误(429):要降级或换模型
- 内容审核错误(内容被拒):Prompt 有问题
- "软失败":HTTP 200 但输出是空的、格式错的、JSON 解析失败的
最后一类最容易被忽略:200 不代表成功,要自己加校验。
维度 ④:模型分布
一个成熟 AI 应用往往多模型混用(旗舰模型做难题、小模型做简单分类、本地模型做隐私任务)。监控每个模型调用了多少次、花了多少钱,避免"明明该用小模型的场景全用大模型"导致的浪费。
维度 ⑤:输出质量指标(最重要也最难)
这是 AI 监控的深水区:
- 幻觉率(Hallucination rate):回答中编造事实的比例。常用 LLM-as-Judge 自动打分。
- 用户反馈率:点赞、点踩按钮的点击比例。负反馈率是最直接的质量信号。
- 任务完成率:Agent 任务是否真正完成(比如下单成功 vs 中途失败)。
# 用户点了"踩",记录一个负反馈分数
from langfuse import Langfuse
langfuse.score(trace_id=current_trace_id, name="user_feedback", value=0)  # 负反馈
维度 ⑥:RAG 特有:检索召回率 / 命中率
RAG 系统答不好,80% 是检索环节的问题,不是生成环节。要单独监控:
- 召回率(Recall):相关文档有没有被检索到(理想 > 85%)。
- 命中率(Hit Rate):Top-K 里有没有正确答案。
- 检索 vs 生成的耗时占比:检索太慢会拖垮整体延迟。
如果召回率掉到 50%,再强的 LLM 也救不回来,RAG 监控要把检索和生成分开看。
3.2 一张表:AI 监控维度速查
| 维度 | 关键指标 | 告警阈值(参考) | 工具 |
|---|---|---|---|
| Token 成本 | 日消耗 $、人均消耗 | 日预算超 80% | Langfuse |
| 响应延迟 | TTFT、P99 总时间 | TTFT > 3s | Prometheus |
| 成功率 | HTTP 错误率、软失败率 | > 5% | Prometheus |
| 模型分布 | 各模型调用量占比 | 异常倾斜 | Langfuse |
| 输出质量 | 幻觉率、负反馈率 | 负反馈 > 10% | Langfuse + Judge |
| RAG 检索 | 召回率、命中率 | 召回 < 70% | Langfuse span |
3.3 小结
- AI 监控 = 传统监控(QPS/错误率)+ 6 大特有维度。
- 最关键三个:Token 成本(钱)、响应延迟(体验)、输出质量(准不准)。
- RAG 系统要把检索和生成分开监控,检索是 RAG 的命门。
- 其中"质量"最难,需要 LLM-as-Judge 或用户反馈来量化,评估体系值得单独深入。
四、技术栈选型:传统三件套 vs AI 专用
4.1 两大阵营
阵营 A:传统可观测性三件套(为通用软件设计)
| 工具 | 职责 | 类比 |
|---|---|---|
| Prometheus | 采集 & 存储 Metrics | 体温计(定时采样数字) |
| Grafana | 可视化仪表盘 | 仪表盘(画图表) |
| Loki / ELK | 收集 & 查询 Logs | 日记本(翻历史) |
| Jaeger / Tempo | 链路追踪 Traces | 传菜单(看路径) |
优点:成熟、通用、免费,几乎整个互联网公司都在用。缺点:不懂 AI,它不知道什么是 token、什么是 prompt、什么是幻觉。你得自己把这些塞进去。
阵营 B:AI 原生可观测性工具(为 LLM 应用专门设计)
| 工具 | 出品方 | 特点 | 开源 |
|---|---|---|---|
| Langfuse | 社区(德国团队) | 开源、自部署、AI 原生、生态最全 | 是(MIT) |
| LangSmith | LangChain | 与 LangChain 深度集成、闭源 SaaS | 否 |
| Helicone | Helicone | API 代理式(改一行 base_url 就接入) | 部分 |
| Phoenix | Arize | 强于评估 & 实验追踪、开源 | 是 |
| Weave | Weights & Biases | 强于实验记录、偏 ML 训练 | 否 |
4.2 为什么 AI 应用推荐用"AI 原生"工具
传统三件套把 LLM 调用当成一次普通 HTTP 请求,看不到 prompt、output、token 这些 AI 特有信息。而 AI 原生工具天生就懂这些:
传统 Prometheus 看到的:http_request_duration_seconds{path="/chat"} 2.3
Langfuse 看到的:trace 里完整记录了
  - prompt(用户问了什么)
  - 检索到的 5 条文档(内容!)
  - 模型 gpt-4o,输入 800 token,输出 120 token,成本 $0.0002
  - 耗时 2.3s,其中检索 0.3s / 生成 2.0s
  - 用户后续点了"踩"
排查 AI 问题时,后者信息量是前者的 10 倍。
4.3 推荐组合:Langfuse + Prometheus + Grafana
最佳实践是两者结合:
- Langfuse 负责 AI 层:trace 链路、prompt/output、token 成本、质量评分。
- Prometheus + Grafana 负责基础设施层:QPS、错误率、服务器资源。
为什么这么分?因为运维同学看 Grafana(看系统健不健康),AI 工程师看 Langfuse(看 AI 聪不聪明、贵不贵),两拨人看不同的仪表盘。Langfuse 也能把指标导出到 Prometheus,做到统一告警。
选型建议:个人项目 / 小团队直接上 Langfuse(开源自部署,零成本);中大型公司 Langfuse + Prometheus + Grafana 三件套全配齐;预算充足且深度用 LangChain 的团队可选 LangSmith。
4.4 小结
- 传统三件套(Prometheus/Grafana/Loki)通用但不懂 AI。
- AI 原生工具(Langfuse 等)天生懂 prompt/token/幻觉。
- 推荐组合:Langfuse(AI 层)+ Prometheus + Grafana(基础设施层)。
- 本篇重点讲 Langfuse(开源、自部署、AI 原生、最适合上手)。
五、Langfuse 实战:Docker 部署 + 给 LLM / RAG 加 trace
这是本篇的精华。我们用 Langfuse 给一个 LLM 调用和一个完整 RAG 流程加上链路追踪。
5.1 第一步:Docker 自部署 Langfuse
Langfuse 提供官方 docker-compose.yml,一行命令拉起:
# 拉取官方 compose 文件(含 Langfuse + Postgres)
curl -O https://raw.githubusercontent.com/langfuse/langfuse/main/docker-compose.yml

# 启动(首次会拉镜像,约 2-3 分钟)
docker compose up -d
启动后访问 http://localhost:3000,注册一个账号,创建一个 Project,你会拿到两个 Key:
pk-lf-xxx(Public Key,给 SDK 用)sk-lf-xxx(Secret Key,给 SDK 用)
5.2 第二步:装 SDK 并配置环境变量
pip install langfuse openai新建 .env 文件(SDK 会自动读取):
LANGFUSE_HOST=http://localhost:3000
LANGFUSE_PUBLIC_KEY=pk-lf-xxx
LANGFUSE_SECRET=sk-lf-xxx
OPENAI_API_KEY=sk-xxx
5.3 第三步:用 @observe() 给一个 LLM 调用加 trace
Langfuse 最爽的设计是 @observe() 装饰器:给你的函数加一行装饰器,它就自动变成一个 trace span,连嵌套调用都会自动串成父子关系。
import os
from openai import OpenAI
from langfuse import observe          # v3 SDK 的装饰器
from dotenv import load_dotenv

load_dotenv()
client = OpenAI()

# 加这一行装饰器,chat 函数就成了一个 Langfuse span
@observe()
def chat(question: str, model: str = "gpt-4o-mini") -> str:
    response = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": question}],
    )
    return response.choices[0].message.content

if __name__ == "__main__":
    answer = chat("用一句话解释什么是 RAG")
    print(answer)
运行后打开 Langfuse 面板,你会看到:
- 一条 trace,名字叫
chat - 里面记录了:输入
question、输出 answer、自动捕获了 OpenAI 调用的 token、耗时、成本 - 点进去能看到完整的 prompt 和 output 文本
Langfuse 还有个"魔法导入":from langfuse.openai import openai,把 openai 整个替换成带 trace 的版本,连装饰器都不用加就能自动追踪所有 OpenAI 调用,适合不想改业务代码的场景。
5.4 第四步(精华):给一个完整 RAG 流程加 trace
我们把 RAG 的核心环节(向量化 → 检索 → 重排 → 生成)每一个都包成一个 @observe() 函数,Langfuse 会自动把它们串成一条瀑布图 trace。
import os, time
from openai import OpenAI
from langfuse import observe
from dotenv import load_dotenv

load_dotenv()
client = OpenAI()

# ---------- 模拟一个向量库(实际用 pgvector / Qdrant) ----------
KNOWLEDGE = [
    {"id": 1, "text": "RAG 通过检索增强生成,减少幻觉。", "vec": [0.9, 0.1]},
    {"id": 2, "text": "切片大小影响 RAG 召回率,建议 300-500 token。", "vec": [0.8, 0.3]},
    {"id": 3, "text": "Embedding 把文本转成向量用于相似度计算。", "vec": [0.1, 0.9]},
]

# ---------- RAG 核心环节,每个都加 @observe ----------

@observe(name="embedding")           # 自定义 span 名
def embed(text: str) -> list:
    """把查询向量化(这里用 mock,真实场景调 embedding API)"""
    time.sleep(0.02)
    # mock:简单映射,真实用 client.embeddings.create
    return [0.85, 0.25] if "RAG" in text else [0.1, 0.9]

@observe(name="retrieve")
def retrieve(query_vec: list, top_k: int = 2) -> list:
    """向量检索,召回 Top-K 文档"""
    time.sleep(0.045)
    scored = sorted(KNOWLEDGE, key=lambda d: -sum(a*b for a,b in zip(d["vec"], query_vec)))
    return scored[:top_k]

@observe(name="rerank")
def rerank(docs: list, query: str) -> list:
    """重排序(提升精度)"""
    time.sleep(0.015)
    return docs  # mock:实际用 cohere/bge-reranker

@observe(name="generate")
def generate(question: str, docs: list) -> str:
    """把检索结果拼进 prompt,调 LLM 生成"""
    context = "\n".join(d["text"] for d in docs)
    prompt = f"根据以下资料回答问题。\n资料:{context}\n问题:{question}"
    resp = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[{"role": "user", "content": prompt}],
    )
    return resp.choices[0].message.content

# ---------- 顶层:把整条 RAG 串起来 ----------
@observe(name="rag_query")           # 这个 trace 的总名
def rag_query(question: str) -> str:
    """一次完整的 RAG 查询:自动串成一条 trace"""
    q_vec = embed(question)           # 子 span 1
    docs = retrieve(q_vec)            # 子 span 2
    docs = rerank(docs, question)     # 子 span 3
    answer = generate(question, docs) # 子 span 4
    return answer

if __name__ == "__main__":
    print(rag_query("RAG 怎么切片?"))
运行后打开 Langfuse,你会看到一条名为 rag_query 的 trace,下面挂着 4 个子 span(embedding → retrieve → rerank → generate),形成完整的瀑布图。点开 generate span,能看到:
- 完整的 prompt(拼了哪些文档)
- output(模型回了什么)
- token 数 & 成本(自动算好)
- 耗时(一眼看出 LLM 生成占了 90% 时间)
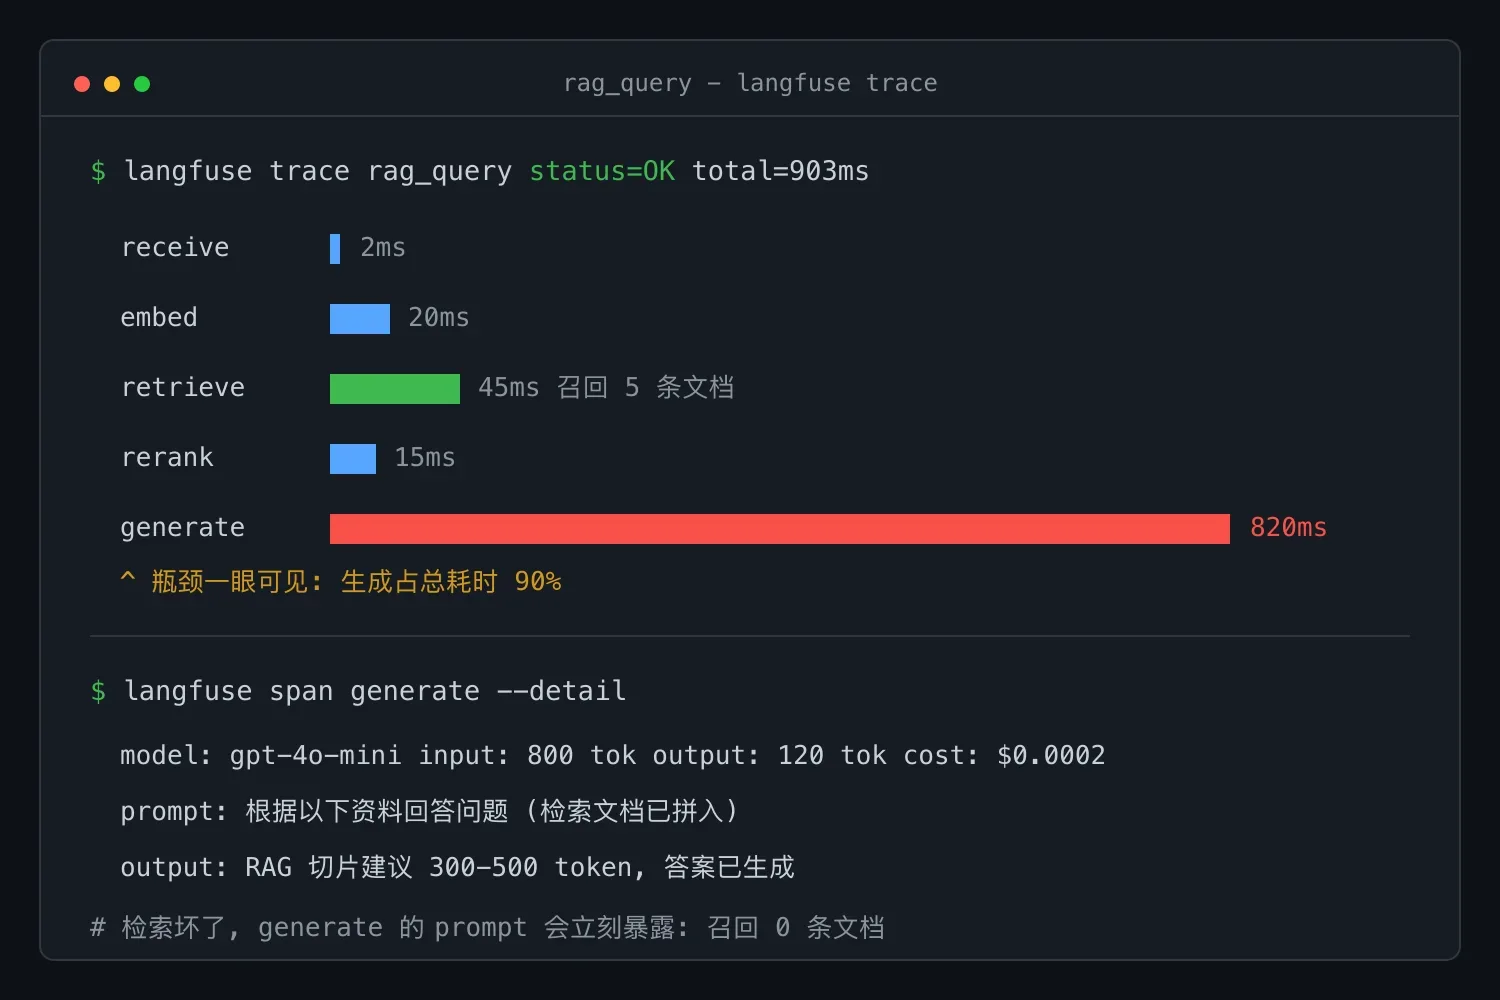
这就是 AI 链路追踪的威力:哪个 span 慢、贵、出错,一目了然。
5.5 第五步:给 trace 打分(质量监控)
光有 trace 不够,还要给"质量"打分。Langfuse 支持 score:
from langfuse import Langfuse

lf = Langfuse()

# 方式1:用户反馈(点赞或点踩时调用)
lf.score(trace_id=current_trace_id, name="user_feedback", value=1)   # 正反馈

# 方式2:LLM-as-Judge 自动评分(用一个便宜模型给主模型打分)
@observe(name="judge")
def judge_quality(question: str, answer: str) -> float:
    prompt = f"给这个回答打 0-1 分,只输出数字。问题:{question}\n回答:{answer}"
    resp = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[{"role": "user", "content": prompt}],
    )
    return float(resp.choices[0].message.content.strip())
打分后,Langfuse 面板能按 score 过滤,直接筛出"所有低分 trace"做 bad case 分析,这是质量优化的核心工作流。
5.6 小结
- Langfuse 自部署只需
docker compose up -d。 @observe()装饰器是灵魂:加一行,函数就变成 trace span,嵌套调用自动成父子链。- 给 RAG 加 trace 的模式:每个环节(embed/retrieve/rerank/generate)各加
@observe,顶层rag_query自动串成一条完整链路。 - 用
lf.score()给 trace 打分,支持用户反馈和 LLM-as-Judge。 - 面板里能看到 prompt、output、token、成本、耗时,这是排查 AI 问题的"上帝视角"。
六、Prometheus 指标采集 + Grafana 仪表盘
Langfuse 管 AI 层,Prometheus + Grafana 管基础设施层 + 业务聚合指标。我们用 prometheus_client 暴露指标。
6.1 用 prometheus_client 暴露三大指标
from prometheus_client import Counter, Histogram, start_http_server
import random, time

# ① Counter:只增不减的计数(请求数、token 总量)
REQUEST_COUNT = Counter(
    "ai_request_total", "Total AI requests",
    ["endpoint", "model", "status"]                # 标签维度
)
TOKEN_COUNT = Counter(
    "ai_token_total", "Total tokens consumed",
    ["model", "direction"]                          # direction: input/output
)

# ② Histogram:分布型指标(延迟),Grafana 可算 P50/P95/P99
LATENCY = Histogram(
    "ai_request_duration_seconds", "Request latency",
    ["endpoint"],
    buckets=(0.1, 0.5, 1, 2, 5, 10, 30)             # 自定义分桶
)

# ③ Gauge:可增可减的瞬时值(当前在线用户、队列长度),本例略

def handle_chat():
    """模拟一次 AI 调用,记录指标"""
    t0 = time.time()
    try:
        # ... 实际调 LLM ...
        latency = time.time() - t0
        in_tok, out_tok = 800, 120
        REQUEST_COUNT.labels(endpoint="/chat", model="gpt-4o-mini", status="success").inc()
        TOKEN_COUNT.labels(model="gpt-4o-mini", direction="input").inc(in_tok)
        TOKEN_COUNT.labels(model="gpt-4o-mini", direction="output").inc(out_tok)
        LATENCY.labels(endpoint="/chat").observe(latency)
    except Exception:
        REQUEST_COUNT.labels(endpoint="/chat", model="gpt-4o-mini", status="error").inc()

if __name__ == "__main__":
    start_http_server(8000)            # 暴露 /metrics 端点
    print("Metrics on http://localhost:8000/metrics")
    while True:
        handle_chat()
        time.sleep(1)
启动后访问 http://localhost:8000/metrics,你会看到 Prometheus 格式的文本指标。Prometheus server 会定时来这个地址抓取(pull 模式)。
6.2 配 Prometheus 抓取
在 prometheus.yml 里加一个 scrape job:
scrape_configs:
  - job_name: "ai-app"
    static_configs:
      - targets: ["host.docker.internal:8000"]   # 你的应用地址
6.3 配 Grafana 仪表盘
在 Grafana 里加 4 个面板,用 PromQL 查询:
| 面板 | PromQL | 类型 |
|---|---|---|
| QPS(每秒请求) | rate(ai_request_total[1m]) | Time series |
| P99 延迟 | histogram_quantile(0.99, rate(ai_request_duration_seconds_bucket[5m])) | Time series |
| Token 总消耗 | sum(increase(ai_token_total[1h])) by (model) | Bar gauge |
| 错误率 | rate(ai_request_total{status="error"}[5m]) / rate(ai_request_total[5m]) | Stat |
配完后,你就有了和一线大厂一样的 AI 监控大盘。
6.4 小结
- 用
prometheus_client的Counter(计数)/Histogram(分布)/Gauge(瞬时值)暴露指标。 - 应用暴露
/metrics端点,Prometheus 定时 pull。 - Grafana 用 PromQL 查询,配出 QPS / P99 / Token / 错误率四大面板。
- Langfuse 看单条 trace 的细节,Grafana 看整体趋势,两者互补。
七、告警体系:什么该响、怎么响
光看仪表盘不够,得让系统主动喊你。这就是告警(Alerting)。
7.1 哪些指标该告警
不是所有指标波动都值得半夜把你叫醒。AI 应用值得告警的几类情况:
| 告警场景 | 触发条件(参考) | 严重度 |
|---|---|---|
| 错误率飙升 | 5 分钟错误率 > 10% | P0(立即处理) |
| 延迟突增 | P99 > 5s 持续 5 分钟 | P1 |
| 成本超阈值 | 日 Token 成本 > 预算 80% | P2(白天处理) |
| 召回率下降 | RAG 召回率 < 70% | P1 |
| 负反馈飙升 | 用户负反馈率 > 15% | P1 |
告警黄金法则:只对"需要人介入"的情况告警。如果某个指标波动不需要人做任何事,就别告警,告警太多会导致"狼来了",真出事反而被忽略。
7.2 用 Alertmanager 配告警规则
在 Prometheus 里写告警规则(alerts.yml):
groups:
  - name: ai-alerts
    rules:
      # 规则1:错误率飙升
      - alert: HighErrorRate
        expr: |
          sum(rate(ai_request_total{status="error"}[5m]))
          / sum(rate(ai_request_total[5m])) > 0.10
        for: 5m                          # 持续 5 分钟才触发,避免抖动
        labels:
          severity: critical
        annotations:
          summary: "AI 应用错误率超过 10%"
          description: "当前错误率 {{ $value | humanizePercentage }}"

      # 规则2:P99 延迟过高
      - alert: HighLatencyP99
        expr: |
          histogram_quantile(0.99, rate(ai_request_duration_seconds_bucket[5m])) > 5
        for: 5m
        labels:
          severity: warning
        annotations:
          summary: "AI P99 延迟超过 5 秒"
配好后,Prometheus 触发的告警会推给 Alertmanager,由它决定怎么通知你(邮件 / 钉钉 / 飞书 / Slack / PagerDuty)。
7.3 小结
- 告警只对"需要人介入"的情况设置,少而准优于多而全。
- AI 应用核心几类告警:错误率、延迟、成本、质量(召回率/负反馈)。
- 用 Prometheus
alerting rules+ Alertmanager 路由到你的通知渠道。 for: 5m防抖,避免短暂波动误报。
八、实战:给自己的 RAG / Agent 项目加监控
把上面的能力落到你已有的 RAG 和 Agent 项目里。改动很小,但效果立竿见影。
8.1 给 RAG 项目加监控(最小改动)
在已有 RAG 代码基础上,只做三件事:
- 顶层入口加
@observe():rag_query、retrieve、generate各加一个。 - 加 Prometheus 指标:在
generate里记录 token 和延迟。 - 加用户反馈通道:把点赞、点踩按钮接到
lf.score()。
# RAG 代码 + 监控 = 生产级 RAG
@observe(name="rag_query")
def rag_query(question: str):
    docs = retrieve(question)        # 已加 @observe
    answer = generate(question, docs) # 已加 @observe
    # 记录业务指标
    REQUEST_COUNT.labels(endpoint="/rag", status="success").inc()
    return {"answer": answer, "trace_id": get_current_trace_id()}

# 前端用户点踩时调这个
def on_user_feedback(trace_id: str, thumbs_up: bool):
    lf.score(trace_id=trace_id, name="user_feedback",
             value=1 if thumbs_up else 0)
就这么几行,你的 RAG 就从"黑盒 demo"变成了"可观测的生产系统"。
8.2 给 Agent 项目加监控
Agent 比 RAG 链路更长(思考→工具→再思考),trace 更是刚需。给 ReAct 循环的每一轮加 @observe:
@observe(name="agent_step")
def agent_step(state):
    thought = llm_think(state)      # @observe
    action = parse_tool_call(thought) # @observe
    result = call_tool(action)       # @observe(每个工具调用都是 span)
    return {"thought": thought, "result": result}

@observe(name="agent_run")
def agent_run(query):
    state = {"query": query}
    for _ in range(MAX_STEPS):
        state = agent_step(state)
        if is_done(state): break
    return state["answer"]
这样 Agent 跑完,你能看到每一轮思考、每个工具调用的完整轨迹。Agent 出问题时,是"想错了"还是"工具调错了"一目了然。
8.3 小结
- 给已有项目加监控改动极小:加几个装饰器 + 几行指标记录。
- RAG:每个环节加
@observe,入口记录 Prometheus 指标,反馈接lf.score。 - Agent:每一步思考 + 每个工具调用都加
@observe,Agent trace 是排查"AI 为什么这么决策"的唯一手段。 - 没有监控的 AI 项目 = 蒙眼狂奔;加了监控 = 给 AI 装上行车记录仪。
本章小结
- AI 应用比传统应用更需要可观测性,因为它是概率黑盒,答错了也不报错。
- 可观测性三支柱:Logs(细节)/ Metrics(趋势)/ Traces(关联),配合使用:Metrics 告警 → Traces 定位 → Logs 查细节。
- AI 特有 6 大维度:Token 成本、TTFT 延迟、成功率、模型分布、输出质量、RAG 召回率,其中质量最难,需 LLM-as-Judge 或用户反馈。
- 技术栈推荐:Langfuse(AI 层)+ Prometheus + Grafana(基础设施层)。
- Langfuse 灵魂是
@observe():加一行装饰器,函数变 span,嵌套自动成链;给 RAG 每个环节加@observe就得到完整瀑布图 trace。 - Prometheus 用 Counter/Histogram 暴露指标,Grafana 用 PromQL 画 QPS/P99/Token/错误率四大面板。
- 告警只设"需要人介入"的:错误率、延迟、成本、质量几类,用 Alertmanager 路由通知。
- 落地极轻:给已有的 RAG、Agent 项目加几个装饰器 + 几行指标,就从"黑盒 demo"升级成"可观测生产系统"。
动手练习
练习 1(入门 · 半小时):用 Docker 跑起 Langfuse,写一个带 @observe() 的 chat() 函数,在面板里找到那条 trace,截图记录它的 prompt、output、token、耗时,这是你简历上"有 LLM 可观测性经验"的第一份证据。
练习 2(进阶 · 2 小时):把第五节的 RAG trace 代码跑通,故意把 retrieve 改成"返回空数组",观察 Langfuse 里 generate span 的 prompt 变化,体会"检索坏了 → 生成 span 立刻暴露问题"的排障流程。然后接一个 Prometheus + Grafana,画出 Token 消耗曲线。
练习 3(思考题):如果你的 AI 客服机器人突然"用户负反馈率从 3% 涨到 20%",但 HTTP 错误率为 0,你会按什么顺序排查?提示:先用 Langfuse 按负反馈 score 过滤 bad case trace → 看是检索环节(召回率)还是生成环节(幻觉)的问题 → 再决定改 RAG 还是改 Prompt。把这个排查流程写成你自己的 SOP。
延伸阅读
- Langfuse 官方文档:langfuse.com/docs(最权威,含 SDK / 自部署 / 集成全套)
- Langfuse GitHub:github.com/langfuse/langfuse(开源 MIT,可自部署)
- Prometheus 官方文档:prometheus.io/docs(PromQL 必查)
- Grafana 官方文档:grafana.com/docs(仪表盘配置)
- OpenTelemetry:opentelemetry.io(可观测性通用标准,Langfuse 底层基于它)
- Google SRE Book 第 6 章《Monitoring Distributed Systems》:告警哲学的经典之作