字节笔记本
2026年10月6日 · 约 21 分钟读完
AI Agent 记忆系统:设计越精妙,越脆弱
本文素材来自一位 AI Agent 开发者 2026 年 6 月的公开实战分享,并结合 Anthropic 的工程博客与多篇框架评测整理而成。
我在做 AI Agent 的过程中,有一个经验反复被验证:
Memory 系统设计得越复杂、越精妙,往往也越烂。
有些时候它能表现出很不错的"记忆和召回"能力,但脆弱得要命。换个场景、换种问法、对话长一点,它就露馅了。
反而是那种短平快糙的方案,看起来一堆毛病,实际跑起来还好一些。
这不是我一个人遇到的问题。过去一年我做 Agent 做得越多,越确认这件事:Memory 系统最可靠的部分,往往是最简单的部分。
为什么精妙的 Memory 系统会脆弱
先说结论:脆弱性的根源在于,你把太多智能塞进了基础设施层。
一个典型的"精妙" Memory 系统长什么样:
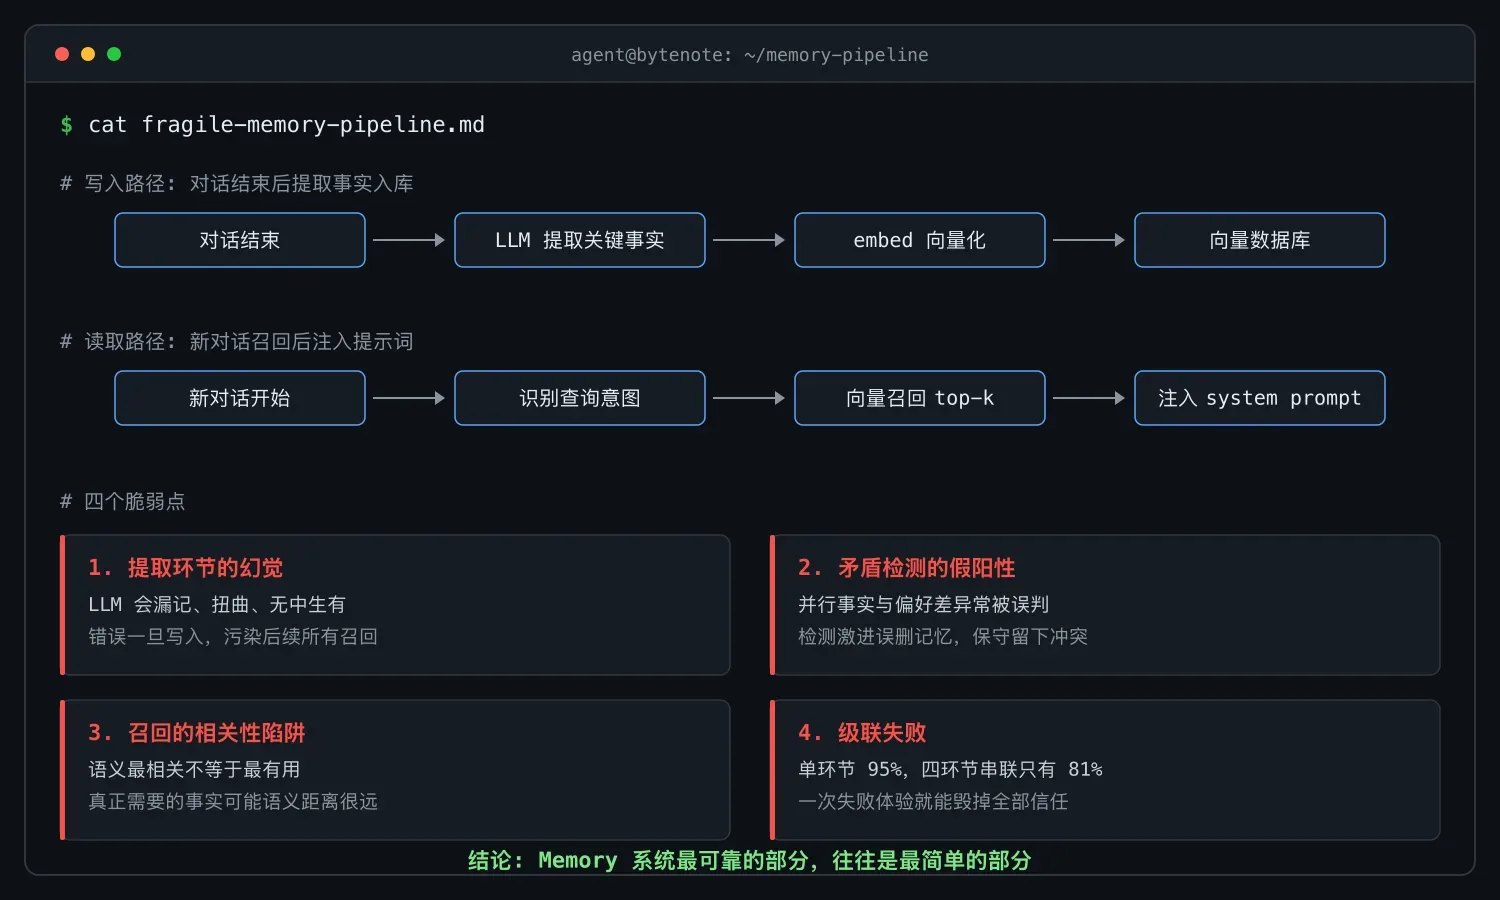
- 对话结束 → LLM 提取关键事实 → embed → 存入向量数据库
- 新对话开始 → 查询意图 → 向量召回 top-k → 注入 system prompt
- 用户说"我搬到北京了" → 检测到矛盾 → 删除旧事实 + 插入新事实
- 多轮对话后 → 自动归纳总结 → 压缩记忆 → 分层存储
每一步都很聪明。每一步都可能出错。
脆弱点 1:提取环节的幻觉
Memory 的起点是从对话中提取事实。谁来提取?LLM。LLM 提取事实可靠吗?
你在一次对话里说了三件事:中午吃了牛肉面,下午开了一个关于 Q3 预算的会,晚上想去看《沙丘 3》。提取器可能会漏掉一条,扭曲一条,甚至无中生有地编造一条你根本没说过的东西。
错误一旦写入 Memory,后续所有召回都会被污染。 这是不可逆的:除非你有纠错机制,但纠错机制本身也是 LLM,又会引入新一轮的不确定性。
脆弱点 2:矛盾检测的假阳性
用户说"我上周说喜欢吃日料,但我现在改吃素了"。一个"精妙"的系统应该检测到矛盾、更新旧记忆。
但实际中,大量所谓"矛盾"根本不是矛盾:
- "这个项目用 Go"和"我在学 Rust",这不是矛盾,是并行事实
- "我觉得 React 比 Vue 好"和"这个项目我们选 Vue",这不是矛盾,是个人偏好与技术决策的区分
- "A 公司是竞品"和"A 公司现在是合作伙伴",这不是矛盾,是时间线上的变化
过于激进的矛盾检测会把正确的记忆删掉。过于保守的矛盾检测会保留冲突的记忆,让后续召回困惑。不管怎么调参,都有 case 过不去。
脆弱点 3:召回的相关性陷阱
向量召回是基于语义相似度的。但"最相关的记忆"不等于"最有用的记忆"。
用户问"帮我看看上个月那个支付 Bug",语义相似度最高的是"上个月"这个时间维度、或者"支付"这个领域维度的记忆。但真正需要的可能是"那个 Bug 根因是第三方 SDK 版本升级"这条具体事实,它可能在语义距离上离得很远。
Mem0 在 LOCOMO benchmark 上测出 67.13% 的准确率,听起来不错。但剩下 33% 的失败案例里,很大一部分是"语义相似但不该召回的"和"应该召回但语义不相似的"。在 benchmark 上是数字,在生产里就是一个 Agent 对用户说"你上次不是说想吃火锅吗?"的尴尬时刻。
脆弱点 4:级联失败
这是最致命的。Memory 系统是一个管道:提取 → 存储 → 召回 → 注入 → LLM 生成。每个环节的成功率假设是 95%,四个环节串联起来整体成功率就是 81%。如果某个环节成功率只有 90%,整体就掉到 77%。
用户体验不是平均概率:一次失败的体验就能毁掉所有信任。 一个 Agent 连续 20 次对话表现完美,第 21 次突然说"你是谁啊?",用户只会记住第 21 次。
Anthropic 的思路:上下文工程,不是记忆工程
Anthropic 最近发了一篇长文叫 Effective Context Engineering for AI Agents,里面有一个观点让我深有共鸣:
"Do the simplest thing that works."
最简单的方案,如果它有效,就不要搞复杂。
Anthropic 的核心论点是:不要试图在基础设施层解决智能问题。 Context engineering 的目标是找到"最小可能的高信号 token 集合",而不是构建一个完美的记忆系统。
他们提出了三个具体策略,我在自己的项目里都用了,效果比任何第三方 Memory 框架都稳定:
1. Compaction:压缩,而不是记忆
当对话接近 context window 上限时,让 LLM 自己总结当前上下文的关键信息,丢弃冗余内容,然后继续。
# Claude Code 的实现方式(伪代码)
def compact(context):
    summary = llm.summarize(
        context,
        instructions="""
        保留以下内容:
        - 架构决策和原因
        - 未解决的 Bug 和当前状态
        - 关键实现细节
        丢弃以下内容:
        - 冗余的工具输出
        - 已完成的任务
        """
    )
    return summary + last_5_messages
关键洞察:压缩不需要外部 Memory 系统。 它只是 context window 内部的自我管理。没有向量数据库、没有 embedding、没有事实提取,就是一个 LLM 调用。
我在项目里用这个方式处理长对话:每 50 轮对话触发一次 compaction,只保留总结 + 最近 10 条消息。效果稳定,不需要任何额外基础设施。
2. Structured Note-taking:Agent 写笔记
让 Agent 自己维护一个结构化的笔记文件。不是让 LLM 提取事实存到数据库里,而是让 Agent 用自然语言写"我做了什么、学到了什么、还有什么没做"。
Claude Code 用的是 TODO 文件。我给自己的 Agent 设计的方案更丰富一些:
<!-- AGENT_NOTES.md -->
## 当前任务
- 正在重构支付模块,将 stripe 集成改为自定义支付网关
- 目标:支持多币种,降低 stripe 手续费

## 已完成
- [x] 数据库 schema 迁移(6/28)
- [x] 新支付网关 SDK 集成(6/29)
- [x] 单元测试通过(6/30)

## 待解决
- [ ] 退款逻辑需要处理幂等性
- [ ] iOS 客户端还没更新 API endpoint
- [ ] 需要 QA 团队在 staging 环境跑一遍支付流程

## 关键决策记录
- 6/28:选择自建网关而非继续用 stripe,因为月交易额超过 $50K 后手续费差距显著
- 6/29:退款采用"创建反向交易"而非"标记原交易为已退款",因为对账更简单
这个方案的优势:Agent 自己读写,格式可控,不需要解析。 新对话开始时,直接把整个文件塞进 system prompt。几 KB 的文本,远比从向量数据库召回的碎片化事实有用。
3. Sub-agent 架构:隔离上下文
不把所有任务塞给一个 Agent,而是让专业子 Agent 处理专业任务。主 Agent 协调,子 Agent 执行后返回压缩结果。
这是 Anthropic 在构建多 Agent 研究系统时用的方案。我在自己的项目里也是这么做的:
- 主 Agent:理解用户意图、分配任务、综合结果
- 代码 Agent:专注改代码,context 只需要代码相关的信息
- 测试 Agent:专注跑测试,context 只需要测试相关的信息
- 文档 Agent:专注写文档
每个子 Agent 用完即销毁,不会把无关信息带回主 Agent 的 context。记忆负担降为零。
2026 Memory 框架全景:为什么我不推荐生产级方案
为了让这篇文章不是纯吐槽,我调研了一下当前市场上主流的 Memory 框架。如果你坚持要用第三方方案,这里是我的判断:
| 框架 | GitHub Stars | 核心架构 | LOCOMO 得分 | 我的评价 |
|---|---|---|---|---|
| Mem0 | 41k | 事实提取 + 向量存储 + ADD/UPDATE/DELETE | 67.13% | 生态最好,AWS 选它做 SDK 默认 Memory,但索引可靠性在生产中有问题 |
| Zep | 10k+ | 时序知识图谱(Graphiti) | 75.14%(自报) | 图结构适合复杂推理,但内存开销大(60 万 token/对话),实时召回延迟高 |
| Letta(原 MemGPT) | 15k+ | OS 式内存管理(RAM/recall/archival) | 约 50% | 理念超前但 overhead 大,简单任务反而更贵更慢 |
| LangMem | 无公开数据 | LangGraph 原生集成 | 58.10% | P95 延迟 59.82 秒,实时场景不可用 |
| Hindsight | 新项目 | 四层记忆网络(事实/经验/观点/实体) | 91.4%(LongMemEval) | 架构最先进,但太新,生产验证不足 |
Benchmark 陷阱
注意这些数字的差异:Mem0 用 LOCOMO benchmark,Zep 用 LongMemEval,Hindsight 也用 LongMemEval。不同 benchmark 之间不能直接对比。
LOCOMO:10 段对话,每段约 600 轮、26,000 token。控制变量好,但不代表真实场景。
LongMemEval:对话最长 150 万 token,500 个问题,五个时间复杂度层级。公认更难、更真实。
所以你会看到 Mem0 在 LOCOMO 上 67%,Zep 说自己在 LOCOMO 上 75%,而 Hindsight 在 LongMemEval 上 91%。谁比谁好?没法说。选 benchmark 能让你赢 benchmark,但未必能让你赢生产环境。
我的真实经历
我试过在自己的项目里集成 Mem0。第一周很惊艳,Agent 真的记住了用户说过的话。第二周开始出问题:
- 用户纠正了某个信息,但 Agent 有时候还是用旧的(更新没成功)
- 有些该记住的细节没被提取(提取 prompt 太保守)
- 有些不该记住的废话被当作重要信息存了下来(提取 prompt 太激进)
- 一次错误的记忆导致 Agent 连续三次给错误建议
调了两周 prompt,加了后处理逻辑,做了监控面板。有效果,但维护成本太高。我在一个"让 Agent 记住事情"的功能上花的时间,比核心业务逻辑还多。
最后我回退到了最简单的方案:结构化笔记 + compaction + 少量硬编码的用户偏好存储。效果不惊艳,但稳定。
如果你要给自己的 Agent 加 Memory,我建议这样做
以下是我踩过坑之后总结的最佳实践,按优先级排序:
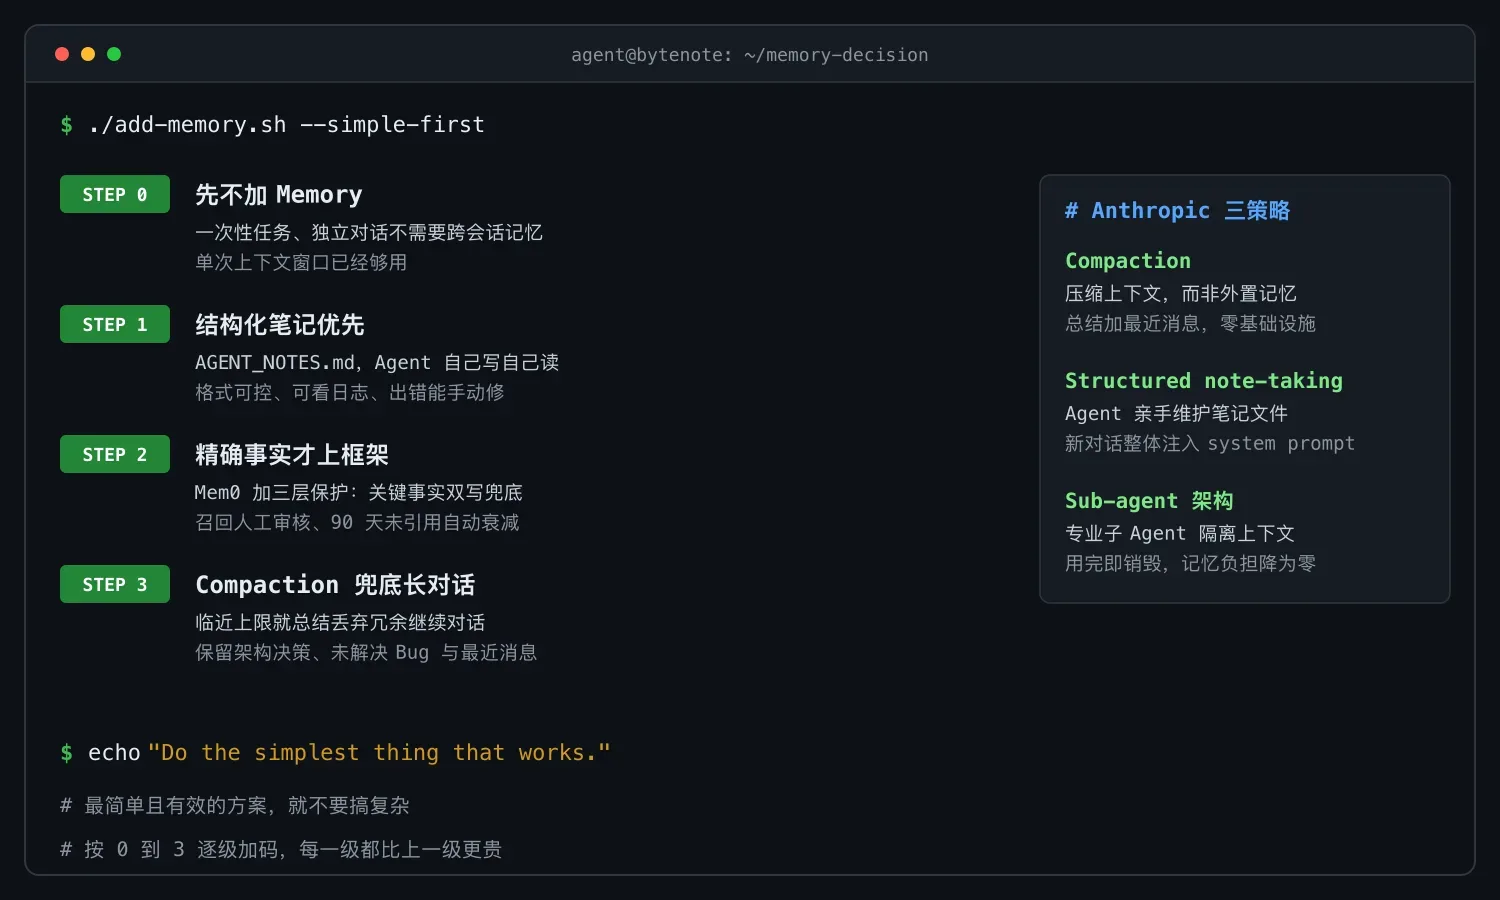
第一步:先不加 Memory
很多团队上来就要 Memory 系统。先问自己:你的 Agent 真的需要记住上次对话的内容吗?
如果你的 Agent 是:
- 一次性任务执行型("帮我写一个函数"、"分析这个数据")
- 每次对话独立(客服、问答、翻译)
不需要 Memory。 单次 context window 就够了。
第二步:需要的话,先用结构化笔记
如果确实需要跨对话记忆,从最简单的开始:
# 写入
def save_note(user_id, content):
    key = f"notes:{user_id}"
    redis.set(key, json.dumps({
        "updated": now(),
        "content": content  # Agent 自己写的结构化文本
    }))

# 读取(每次新对话开始)
def load_note(user_id):
    key = f"notes:{user_id}"
    data = redis.get(key)
    if data:
        return f"以下是关于这个用户的笔记:\n{data['content']}"
    return ""
这个方案的优点:
- 零外部依赖(Redis 你已经有了)
- Agent 自己写、自己读,格式自己定
- 出错了你能直接看日志、手动修
- 没有向量数据库、没有 embedding、没有提取 pipeline
第三步:需要精确事实存储?用 Mem0,但要加监控
如果结构化笔记不够用,比如你需要精确记住"用户的地址是 XX 路 XX 号"这种事实,再用 Mem0 这类框架。
from mem0 import Memory

memory = Memory()

# 存储
memory.add("用户的全名是张三,住在北京市朝阳区", user_id="u_001")

# 搜索
results = memory.search("用户住在哪里", user_id="u_001")
但我强烈建议你加上这几层保护:
- 关键事实双写:同时存到结构化字段和 Mem0 的向量存储。Mem0 召回失败时,结构化字段兜底
- 召回结果人工审核模式:初期把召回结果打在日志里,但不自动注入 prompt。人工确认没问题后再上线
- 记忆衰减:超过 90 天未引用的记忆自动降权或清除。人的记忆会退化,Agent 的记忆也应该
# 我的实际实现:双写 + 衰减
def store_user_fact(user_id, fact, category):
    # 路径 1:结构化存储(可靠但有限)
    redis.hset(f"user:{user_id}:facts", category, fact)

    # 路径 2:向量存储(灵活但可能不准)
    memory.add(fact, user_id=user_id, metadata={"category": category, "created": now()})

def recall(user_id, query):
    # 先从结构化存储拿精确匹配
    structured = redis.hgetall(f"user:{user_id}:facts")
    if query.lower() in str(structured).lower():
        return structured  # 精确命中,直接返回

    # 结构化没命中,再走向量召回
    vector_results = memory.search(query, user_id=user_id)
    return vector_results
第四步:Compaction 做长对话兜底
不管用不用 Memory 系统,长对话的 compaction 都是必须的。它不是 Memory 的替代品,而是 context window 管理的基础设施。
MAX_CONTEXT_TOKENS = 180000  # 给 model 留 20k 余量(以 200k window 为例)

def maybe_compact(messages):
    token_count = count_tokens(messages)
    if token_count < MAX_CONTEXT_TOKENS:
        return messages  # 不需要压缩

    # 把最早的消息交给 LLM 总结
    to_summarize = messages[:-10]  # 保留最近 10 条
    summary = llm.generate(
        system="你是一个总结专家。请保留以下关键信息,丢弃冗余内容:架构决策、未解决问题、关键实现细节、待办事项。",
        input=to_summarize
    )

    # 返回:总结 + 最近 10 条原始消息
    return [{"role": "system", "content": f"以下是之前对话的总结:\n{summary}"}] + messages[-10:]
一个反直觉的结论
做完这些之后,我发现了一个反直觉的事:最好的 Memory 系统,是让 Agent 显式地管理自己的记忆,而不是把记忆管理藏在基础设施里。
为什么?因为当记忆管理是 Agent 的行为(写笔记、做总结)时,出了错你能看到、能修、能调试。当记忆管理是基础设施(embedding、向量检索、事实提取 pipeline)时,出了错你只能调参,而调参是一个没有尽头的游戏。
Anthropic 说得对:"Do the simplest thing that works."
不要追求 human-like 的记忆。人类的记忆系统精妙到不可思议:我们有海马体、前额叶皮层、多个记忆系统协同工作,经过几十万年进化。想让一个 2026 年的 AI 系统复现这个?先把期望降下来。
一个 Agent 能记住用户上周说过的话、不会在对话中途失忆、出错率在 5% 以内,这已经是当前能做到的最好水平了。
延伸阅读
- Effective Context Engineering for AI Agents:Anthropic 工程博客
- AI Agent Memory Systems in 2026: Mem0, Zep, Hindsight, Memvid Compared
- Mem0: Building Production-Ready AI Agents with Scalable Long-Term Memory(arXiv 论文)
- AI Agent Memory Systems: A 2026 Engineering Guide
- 原始观点来自 X 平台一位 Agent 开发者 2026 年 6 月的公开分享