字节笔记本
2026年10月6日 · 约 35 分钟读完
AI 工作流专栏 25:成本治理与质量评估
本文出自《从零成为 AI 工作流工程师》系列,这一章处理生产环境里最现实的两件事:把账单降下来,把效果说清楚。中级工程师能把 demo 跑通,高阶工程师能让它又准又省钱地长期跑下去,分水岭就在成本治理与质量评估这两项能力上。
AI 应用和传统软件有个本质区别:传统软件跑起来对了就是对了,AI 应用"答得对不对"是概率性的,还会随时间变化,靠人的感觉判断很不靠谱。不搭一套量化体系,你就会永远在"我觉得还行"和"用户投诉"之间反复横跳,没法系统性改进。下面分两部分展开:第一部分讲怎么省钱,第二部分讲怎么知道它到底准不准,全部做法都配了可运行的代码。
一、AI 应用的成本构成:开车的油钱
想象你刚买了一辆车。表面看买车花了 20 万,是一次性投入,但真正长期掏空钱包的是油钱:每开一公里烧一点油,天天开、月月开,三年后回头看油费小票,可能比车本身还贵。
AI 应用一模一样:搭系统是"买车",写 Prompt、调 RAG、接 API 都是一次性开发成本;每一次调用大模型则是"油钱",用户每问一句话,你就掏一次钱给模型厂商。更麻烦的是,传统软件上线后用户多用一次几乎不增加成本,AI 应用却是线性增长:用户翻 10 倍,Token 费也翻 10 倍。这就是为什么 AI 工程师必须会算账、会省钱。
一个生产级 AI 应用的总成本,通常由四块构成:
| 成本类型 | 说明 | 占比(经验值) |
|---|---|---|
| Token 成本(LLM 推理费) | 每次调用按输入/输出 token 计费,最大头 | 60% 到 80% |
| Embedding 成本 | 文档入库时调用 Embedding 模型,一次性为主 | 5% 到 10% |
| 向量库与基础设施 | 向量库托管费、GPU 和服务器、CDN、带宽 | 10% 到 20% |
| 人力运维 | 标注、监控、Prompt 调优、故障处理 | 5% 到 10% |
新手最容易踩的坑是只盯 Token 成本。其实知识库规模上去之后,Embedding 一次性算下来也不便宜,向量库托管费同样可能高达每月数千美元。但毫无疑问,Token 成本是绝对大头,也是优化空间最大的地方,下面重点讲它。
二、先算一笔账:三种模型月成本差多少
单次调用成本的公式很简单:
单次调用成本 = (输入 token 数 / 1,000,000 × 输入单价) + (输出 token 数 / 1,000,000 × 输出单价)
月成本 = 单次调用成本 × 日均调用次数 × 30
假设你有一个客服问答机器人,日均 1 万次调用,每次平均 2000 token,其中输入 1500、输出 500,这是 RAG 场景的典型比例:塞进去的上下文多,吐出来的回答短。套用公开定价(以下数字仅供参考,请以厂商官网实时价格为准):
| 模型 | 输入单价(每 1M token) | 输出单价(每 1M token) | 单次成本 | 月成本(30 天) |
|---|---|---|---|---|
| GPT-4o | $2.50 | $10.00 | $0.00875 | $2,625 |
| DeepSeek-V3 | $0.27 | $0.42 | $0.000615 | $184.5 |
| 本地 Qwen3-8B(vLLM) | $0 | $0 | 0(仅 GPU 折旧) | GPU 租金约 $300 到 $600 |
结论一目了然:同一个业务,用 GPT-4o 一年要烧 3 万多美元,换 DeepSeek 一年只要 2200 美元,差了 14 倍。如果 80% 的问题其实简单到用 DeepSeek 就能答对,你却全量用 GPT-4o,那就是在白白烧钱。成本治理的第一个认知是:不是所有问题都配得上最贵的模型。
把这套算法封装成一个通用计算器,接进自己的系统:
# cost_calculator.py 通用 LLM 成本计算器
MODEL_PRICING = {
    "gpt-4o":        {"input": 2.50, "output": 10.00},
    "gpt-4o-mini":   {"input": 0.15, "output": 0.60},
    "deepseek-chat": {"input": 0.27, "output": 0.42},
    "qwen3-local":   {"input": 0.00, "output": 0.00},   # 仅 GPU 折旧
}

def calc_single_cost(model: str, input_tokens: int, output_tokens: int) -> float:
    p = MODEL_PRICING[model]
    return (input_tokens / 1_000_000 * p["input"]) + (output_tokens / 1_000_000 * p["output"])

def calc_monthly_cost(model: str, daily_calls: int, avg_input: int, avg_output: int, days: int = 30) -> float:
    return calc_single_cost(model, avg_input, avg_output) * daily_calls * days
强烈建议把这段逻辑接进监控系统,每次调用实时算成本,按模型、用户、接口等维度聚合,做到账单透明。
三、降本七大手段
会算账只是第一步,真正值钱的是把账单砍下来。下面七个手段按投入产出比排序,前三个几乎零成本就能省一大笔。
手段 1:模型分级路由,简单问题用小模型
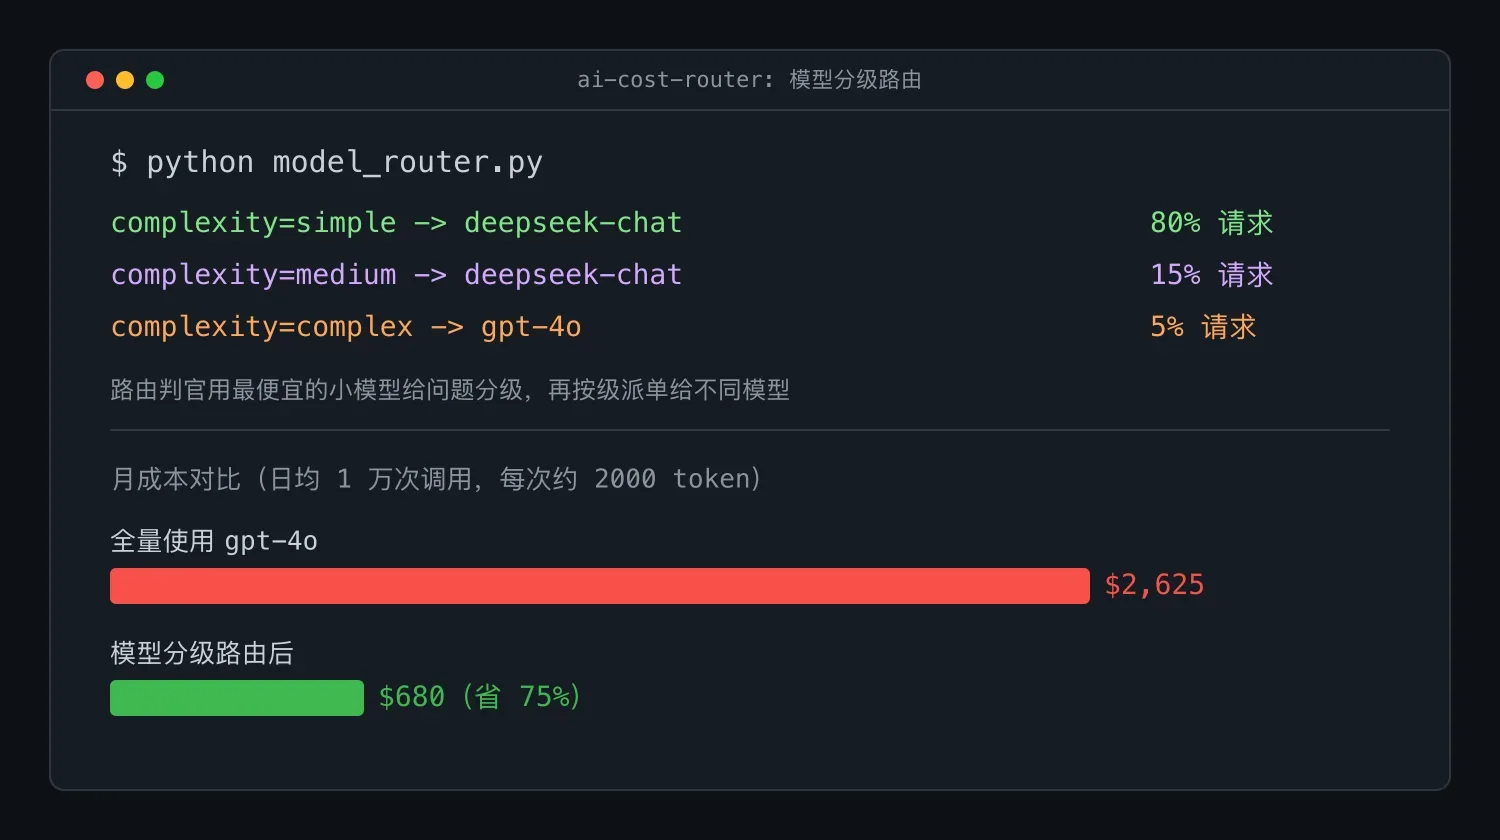
80% 的用户问题是"营业时间是什么""怎么退货"这类简单问题,用最贵的大模型纯属浪费;只有 20% 的复杂推理才需要大模型出场。让问题先过一道"路由判官",是性价比最高的降本手段。
# model_router.py 模型分级路由
import os
from openai import OpenAI

client = OpenAI(api_key=os.getenv("OPENAI_API_KEY"))

def classify_complexity(question: str) -> str:
    """用便宜的小模型判断复杂度,返回 simple/medium/complex"""
    resp = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[
            {"role": "system", "content": "判断用户问题的复杂度,只输出一个词:simple/medium/complex。"
                                          "simple=查信息/闲聊;medium=需要多步推理;complex=数学/编程/复杂分析。"},
            {"role": "user", "content": question},
        ],
        temperature=0,
    )
    return resp.choices[0].message.content.strip().lower()

ROUTE_TABLE = {
    "simple":  "deepseek-chat",
    "medium":  "deepseek-chat",
    "complex": "gpt-4o",
}

def smart_chat(question: str) -> str:
    level = classify_complexity(question)
    model = ROUTE_TABLE.get(level, "deepseek-chat")
    print(f"[路由] 复杂度={level} -> 选用 {model}")
    # 实际项目中通过统一的模型适配层调用对应模型
    return f"(用 {model} 回答了:{question})"
假设 80% 的请求被路由到便宜模型,月成本立刻从 2625 美元降到约 680 美元,省下 75%,而用户几乎无感知。
手段 2:Prompt 精简,少塞废话
RAG 场景里,输入 token 的大头是塞进去的上下文。很多团队一股脑把检索到的 10 段文档全塞进去,其实只有 2 段真正相关。三个实操技巧:检索后用 cross-encoder 重排,只保留最相关的前 3 条;去掉 Prompt 里重复的指令和失效的示例;把较早的多轮对话历史压缩成一句总结,而不是全量保留。
手段 3:语义缓存,相似问题直接命中
用户问"营业时间"和"你们几点开门"是同一个意思,没必要每次都调大模型。把问题和答案按语义存进缓存,相似问题直接返回缓存结果,token 成本为零:
# semantic_cache.py 语义缓存
import os, json
import redis
from openai import OpenAI

r = redis.Redis(host="localhost", port=6379, decode_responses=True)
client = OpenAI(api_key=os.getenv("OPENAI_API_KEY"))

def get_embedding(text: str) -> list:
    resp = client.embeddings.create(model="text-embedding-3-small", input=text)
    return resp.data[0].embedding

def find_cached_answer(question_emb: list, threshold: float = 0.92):
    """在缓存里找语义相似的问题,生产环境建议用向量库做近邻检索"""
    for key in r.keys("cache:*"):
        cached_emb = json.loads(r.hget(key, "embedding"))
        sim = cosine_similarity(question_emb, cached_emb)  # 余弦相似度
        if sim >= threshold:
            return r.hget(key, "answer"), sim
    return None, 0

def chat_with_cache(question: str) -> str:
    q_emb = get_embedding(question)
    cached, sim = find_cached_answer(q_emb)
    if cached:
        print(f"[缓存命中] 相似度={sim:.3f},省一次 LLM 调用")
        return cached
    answer = call_llm(question)
    r.hset(f"cache:{hash(question)}", mapping={"embedding": json.dumps(q_emb), "answer": answer})
    r.expire(f"cache:{hash(question)}", 86400)
    return answer
语义缓存对客服、FAQ 这类高频相似问题的场景效果惊人,命中率经常能达到 30% 到 50%,相当于把账单直接砍掉一半。
手段 4:Batch API,同一个模型半价用
主流厂商提供批处理接口:把成千上万条请求打包提交,24 小时内异步返回结果,价格直接打五折。批量打标签、批量摘要、离线评估这类不要求实时的任务,都应该走这条路,相当于什么都不改就省一半。
手段 5:流式输出配合早停
用户看流式输出时如果提前关闭页面,服务端要立刻停止生成,而不是把剩下的几百个 token 全部生成完再扔掉。给流式请求加一个取消检测:逐块接收时检查用户是否已断开,一旦断开就关闭流,尾部的 token 就省下来了。
手段 6:开源模型替代,边际成本为零
对分类、抽取、改写、简单问答这类窄任务,一个微调过的开源小模型效果往往不输大模型,跑在自家 GPU 上边际成本为零。判断标准很简单:任务越窄、越重复,越适合开源小模型;任务越开放、越需要复杂推理,越得用大模型。
手段 7:结构化输出省 token
让模型输出 JSON 而不是自然语言散文。JSON 结构紧凑,没有"好的,很高兴为您解答"这类客套话,输出 token 能省 30% 到 50%,前端还能把 JSON 渲染成更整齐的卡片,体验和成本双赢。
降本优先级
把七个手段按优先级排:模型分级路由最划算,立省 75%;语义缓存适合高频问答场景,命中率高的能砍一半;Prompt 精简零成本随时可做;Batch API 让离线任务半价;结构化输出压缩回答体积;流式早停避免为离开的用户白烧钱;开源模型替代长期最省,但前期投入大。实际项目里把路由、缓存、精简三招一起上,月成本常常能从 2625 美元压到 300 美元以内。
四、成本监控:看得见才省得下
光会省还不够,得看得见。成本监控的核心是每次调用实时记录成本,按维度聚合,超过阈值告警:
# cost_monitor.py 成本监控装饰器
import time
from datetime import datetime

COST_LOG = []

def track_cost(model: str, user_id: str, endpoint: str):
    """包装 LLM 调用,自动记录每次成本,生产环境可接入 Prometheus 等监控系统"""
    def decorator(fn):
        def wrapper(*args, **kwargs):
            start = time.time()
            resp = fn(*args, **kwargs)
            usage = resp.usage
            cost = calc_single_cost(model, usage.prompt_tokens, usage.completion_tokens)
            COST_LOG.append({
                "ts": datetime.now().isoformat(),
                "model": model, "user_id": user_id, "endpoint": endpoint,
                "cost": cost, "latency": time.time() - start,
            })
            return resp
        return wrapper
    return decorator
接进仪表盘之后,你就能实时看到今天烧了多少、哪个模型最贵、哪个用户最费 token。账单透明,是省钱的前提。
五、为什么必须建评估体系
想象你是老师,给学生出了一套没有标准答案的考卷,只能凭感觉打分:今天心情好打 90,明天心情差打 60。学生不知道自己哪里没学好,你也不知道教学有没有进步。AI 应用不搭评估体系就是这个状态:产品经理问 RAG 准不准,你只能说"我觉得还行";改了一版 Prompt,不知道变好了还是变差了;模型厂商静默升级,你完全没察觉效果在下滑。
评估体系的定义:用一组固定的、人工标注的标准问题和标准答案,配合自动化评分算法,周期性地测量 AI 系统的输出质量,让"准不准"变成一个可追踪的数字。它的价值有三条:可比较,改动前后用同一个测试集跑,数字直接对比;可发现,效果悄悄下滑时数字会告诉你;可决策,上线与否看通过率,而不是拍脑袋。
六、Golden Set:AI 系统的质量基准线
Golden Set(黄金测试集)就是你的期末考卷:50 到 200 道精心挑选的题,每道都有标准答案。每次系统改动(换 Prompt、换模型、升级 RAG)都先拿这套卷子考一遍,分数掉了就不上线,分数涨了才放行。这也是 AI 工程师招聘要求里"评估框架搭建经验"一词背后的硬技能。
构建三步法:
- 从真实日志采样:别凭空编题,按比例采样线上真实用户问题,覆盖 80% 高频问题和 20% 边缘情况。
- 人工标注标准答案:每个问题配一个理想答案,不要求逐字一样,但要点必须齐全。这一步最费人力,也最值钱。
- 覆盖各类场景:简单问题、复杂推理、模糊提问等边界情况,以及问到知识库之外时应当拒答的场景。
经验值:50 到 200 条够用,少于 50 统计不显著,多于 200 标注成本太高、收益递减。
# golden_set_eval.py 跑一遍测试集,算通过率
import os, json
from openai import OpenAI

client = OpenAI(api_key=os.getenv("OPENAI_API_KEY"))

GOLDEN_SET = [
    {"id": "q1", "question": "你们的营业时间是什么?",
     "expected_keywords": ["9:00", "18:00", "周一至周五"], "category": "simple"},
    {"id": "q2", "question": "我上周买的耳机有杂音,能退货吗?",
     "expected_keywords": ["7天", "退货", "质量问题"], "category": "policy"},
]

def get_ai_answer(question: str) -> str:
    resp = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[
            {"role": "system", "content": "你是客服助手,基于公司知识回答。"},
            {"role": "user", "content": question},
        ],
    )
    return resp.choices[0].message.content

def evaluate_single(answer: str, expected_keywords: list) -> bool:
    return all(kw in answer for kw in expected_keywords)

def run_golden_eval() -> dict:
    results, passed = [], 0
    for item in GOLDEN_SET:
        answer = get_ai_answer(item["question"])
        ok = evaluate_single(answer, item["expected_keywords"])
        results.append({**item, "answer": answer, "passed": ok})
        passed += ok
        print(f"[{item['id']}] {'通过' if ok else '失败'} | {item['question']}")
    return {"pass_rate": passed / len(GOLDEN_SET), "total": len(GOLDEN_SET), "details": results}

if __name__ == "__main__":
    report = run_golden_eval()
    print(f"通过率: {report['pass_rate']:.1%}")
    with open("eval_report.json", "w") as f:
        json.dump(report, f, ensure_ascii=False, indent=2)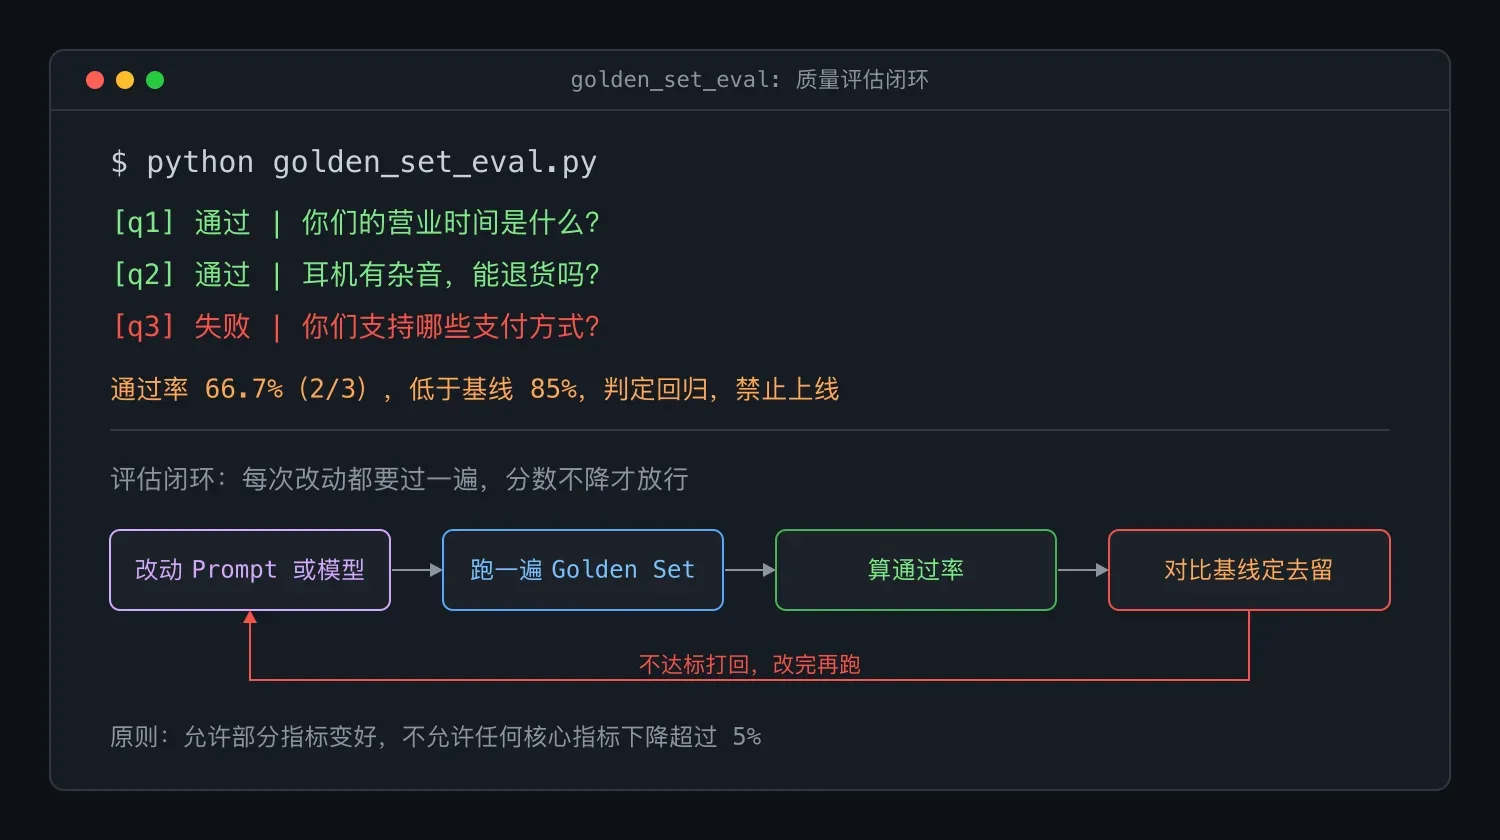
这就是"测试集加回归测试"的完整闭环:改任何东西之前先跑一遍卷子,分数不降才放行。把它写进 CI/CD,就是工业级 AI 工程的标准动作。
七、四大评估指标与 LLM-as-a-Judge
关键词匹配只是最粗糙的评估。真实场景尤其是 RAG 系统,需要更精细的指标。
准确率:回答和标准答案的匹配程度,适合分类、抽取这类有明确标准答案的场景。
忠实度:RAG 专属且最重要。回答里的每个陈述,是否都能在检索到的文档里找到依据?找不到依据就是幻觉。一个"听起来很顺但在瞎编"的回答,比老老实实说"不知道"危险一百倍。
相关性:回答是否切题、是否聚焦用户的问题。问营业时间却扯了一堆退货政策,相关性就低。
LLM-as-a-Judge:人工评估太贵,就用一个强模型给回答打分。这是近年工业界的主流做法,便宜、可规模化,与人工评估结果的相关性可以做到 0.8 以上。
# llm_as_judge.py 用强模型当裁判打分
import os, json
from openai import OpenAI

client = OpenAI(api_key=os.getenv("OPENAI_API_KEY"))

JUDGE_PROMPT = """你是一个严格的评分员。请根据用户问题和参考答案,给候选回答打分(1-5 分)。
评分维度:准确性(2分)、完整性(2分)、简洁性(1分)。
只输出 JSON:{"score": 数字, "reason": "一句话理由"}
"""

def judge_answer(question: str, candidate: str, reference: str) -> dict:
    resp = client.chat.completions.create(
        model="gpt-4o",
        messages=[
            {"role": "system", "content": JUDGE_PROMPT},
            {"role": "user", "content": f"问题:{question}\n参考答案:{reference}\n候选回答:{candidate}"},
        ],
        response_format={"type": "json_object"},
        temperature=0,
    )
    return json.loads(resp.choices[0].message.content)
它的妙处在于:只要准备好 Golden Set,剩下的全自动。每次改完 Prompt,一键跑完几百题打分,几分钟出报告。
八、三大评估框架与 RAGAS 实战
手写评估代码能跑,工业界也有成熟框架:RAGAS 是 RAG 评估的事实标准,内置忠实度、相关性、上下文指标;DeepEval 走 pytest 风格,方便集成进 CI/CD;TruLens 把评估和线上持续监控做成一体。新手首选 RAGAS。
RAGAS 的四个核心指标:忠实度(回答是否基于检索文档,防幻觉)、答案相关性(回答是否切题)、上下文精确率(检索到的文档有多少真正相关)、上下文召回率(该检索到的文档检索到了多少)。
# ragas_eval.py 用 RAGAS 评估 RAG 系统(pip install ragas)
import os
from datasets import Dataset
from ragas import evaluate
from ragas.metrics import faithfulness, answer_relevancy, context_precision, context_recall

os.environ["OPENAI_API_KEY"] = os.getenv("OPENAI_API_KEY")

eval_data = {
    "question": ["你们的退货政策是什么?"],
    "answer": ["商品售出 7 天内,非人为损坏可无理由退货。"],
    "contexts": [["退货政策:商品售出 7 天内可退货,需保留小票。"]],
    "ground_truth": ["7 天内非人为损坏可退货。"],
}

dataset = Dataset.from_dict(eval_data)
result = evaluate(dataset, metrics=[faithfulness, answer_relevancy, context_precision, context_recall])
print(result)
拿到四个 0 到 1 之间的分数后怎么读:忠实度低于 0.8 就要警惕幻觉;上下文精确率低说明检索质量差,要回头调切片、Embedding 和重排。把这段代码接进 CI/CD,每次改 RAG 配置自动跑一遍,分数低于阈值就阻止合并,这就是工业级 RAG 迭代的纪律。
九、回归测试:改好 A,别改坏 B
你修好了客厅的灯,结果一不小心把卧室的电路搞短路了。AI 系统特别容易犯这个错:为"退货问题"优化了 Prompt,"营业时间"的回答反而变啰嗦了。
回归测试的定义:每次改动(改 Prompt、换模型、升级 RAG)之后,在完整的 Golden Set 上重新跑一遍评估,确保没有指标显著下降。核心原则是允许部分指标上升,但不允许任何重要指标下降超过阈值(比如 5%)。
# regression_test.py 对比新旧两次评估报告
def compare_reports(old_report: dict, new_report: dict, threshold: float = 0.05) -> dict:
    old_pass = old_report["pass_rate"]
    new_pass = new_report["pass_rate"]
    delta = new_pass - old_pass
    status = "通过,允许上线" if delta >= -threshold else "出现回归,禁止上线"
    return {"old": old_pass, "new": new_pass, "delta": delta, "status": status}
把它写进 CI/CD,任何代码合并前必须跑通 Golden Set,通过率不降才允许合并。这是区分业余和专业的关键动作。
十、质量漂移监控:发现效果在悄悄变差
你请了个保姆,刚来时干活又快又好,半年后发现家里越来越乱,原来是家政公司悄悄换了个同名同姓的新保姆,能力差了一截,你却一直没察觉。AI 应用天天发生这种事:模型厂商静默升级,输出风格突然变了,格式解析开始报错;用户提问的分布变了,知识库没覆盖到,准确率悄悄下滑;知识库三个月没更新,答的还是老信息。
质量漂移(Quality Drift)的特点是效果不是某天突然崩掉,而是缓慢、隐蔽地变差,等你发现时已经损失了一批用户。对策是持续地、周期性地在 Golden Set 上跑评估,追踪指标随时间的变化曲线,一旦下降超过阈值立刻告警:
# drift_monitor.py 每天定时跑测试集,追踪通过率变化
import os, json

DRIFT_THRESHOLD = 0.05
HISTORY_FILE = "eval_history.json"

def check_drift(today_pass_rate: float) -> dict:
    history = json.load(open(HISTORY_FILE)) if os.path.exists(HISTORY_FILE) else []
    if len(history) < 7:
        return {"status": "数据不足,继续积累"}
    recent = [h["pass_rate"] for h in history[-7:]]
    baseline = sum(recent) / len(recent)
    delta = today_pass_rate - baseline
    if delta < -DRIFT_THRESHOLD:
        return {"status": "警告:检测到质量漂移", "delta": delta,
                "排查方向": ["模型是否被厂商升级", "知识库是否陈旧", "用户提问分布是否变化"]}
    return {"status": "稳定", "baseline_7d": baseline, "delta": delta}
把这段逻辑放进定时任务,指标连续下跌就发告警。质量漂移监控是高阶工程师的早期预警雷达,配合成本监控,你就拥有了完整的 AI 健康度看板。
小结
成本治理这一半:Token 成本占总成本的六到八成,是最值得优化的地方;GPT-4o 和 DeepSeek 的月成本能差 14 倍;分级路由、语义缓存、Prompt 精简三招组合,常能把账单砍到原来的几分之一;成本监控要做到每次调用可记录、可聚合、可告警。
质量评估这一半:AI 是概率系统,没有量化就没有改进;Golden Set 用 50 到 200 条人工标注的问答对撑起质量基准线;准确率、忠实度、相关性、LLM-as-a-Judge 四个指标覆盖大多数场景,RAG 系统优先用 RAGAS;回归测试守住"改好 A 别改坏 B"的底线;质量漂移监控盯住厂商静默升级和输入分布变化。
一句话总结:成本治理让 AI 跑得起,质量评估让 AI 跑得对。这两件事做到位,你就能对线上系统同时交代得了账单和效果,这也是高级 AI 工程师岗位要求里那两行硬指标背后的真实能力。
上手建议
- 把成本计算器拷下来,换成自己业务的日均调用量和 token 分布,算出三种模型的月成本,做成一张对比图发给团队,这是说服大家做模型路由最有力的证据。
- 给自己的 RAG 系统搭一个 30 条的 Golden Set,覆盖简单、复杂、边界三类问题,记录当前通过率作基线,改一版 Prompt 再跑一次,亲手走一遍评估闭环。
- 用 RAGAS 跑四个指标,如果忠实度低于 0.8,回头检查切片、Embedding 和重排,并把这个检查固化进发布流程。
延伸阅读
- RAGAS 官方文档:docs.ragas.io
- RAGAS 论文:Es et al., Ragas: Automated Evaluation of Retrieval Augmented Generation, arXiv 2309.15217
- DeepEval 文档:docs.confident-ai.com
- TruLens 文档:trulens.org
- OpenAI Batch API 指南:platform.openai.com/docs/guides/batch
- LLM-as-a-Judge 论文:Zheng et al., Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena, 2023