字节笔记本
2026年9月24日 · 约 13 分钟读完
光有心法不够,工作流得先能自己跑起来
深夜十一点半,我窝在沙发上刷手机,飞书突然弹出一条消息,是我挂在 Mac Mini 上的一个 agent 发来的,说它把一个复现了三天的 bug 定位到了,附带了测试用例和修复方案,等我确认要不要合并。我点了个"可以",它就自己跑格式化、跑测试、提交代码,整个过程我全程没碰电脑。
这个场景,其实就是我读完 Meathill 那篇《什么样的工作流,让我觉得 Fable 也不过如此》之后,一直想补的那块内容。
那篇文章讲得很好,核心观点我很认同:AI 更像人,不像传统程序,管理它得靠软件工程的老经验——行为规范、开发流程、知识沉淀、定期加固、沉淀 SOP,这五件事都对。
但读完之后我总觉得少了点什么,后来想明白了,缺的是承接这套心法的那一层:工具和基础设施。
心法讲的是该怎么做,基础设施解决的是在哪儿做、靠什么做。没有后者,前者就是一套写在纸上的规范,agent 该怎么接、任务该怎么派、结果该怎么收,全靠人工手动操作,稳定下限根本提不起来。
工作流得先有个能一直待命的地方
先说个最基础的问题:AI 团队总得有个办公室。
我的做法是留一台 Mac Mini 常年开机,当成远程 agent 的入口。它不用多强,只要稳定在线,接上飞书和 Telegram,就能变成我随时随地派活的通道。人在地铁上,在外面吃饭,掏出手机发条消息,agent 就能在 Mac Mini 上把任务跑起来。
这就跟你雇了个团队,总得给他们一间办公室一样。哪怕这个团队里的每个人能力都很强,没有固定的工位,没有对接的流程,活照样派不下去。
多台机器怎么串成一个团队
光有一台常驻机器还不够,真正跑起来的任务经常要跨机器。
我自己是 Mac 和 Linux 混着用,服务端跑在 k3s 集群和几台海外 VPS 上。本地写代码,agent 在云端跑测试,部署又在另一台机器,这种链路很常见。
这里最容易卡壳的地方是文件怎么在机器之间搬。我用夸克网盘的 64TB 空间当传送带,本地生成的东西丢进去,云端机器几秒钟就能同步到,不用再折腾 scp 或者临时开端口。这个思路说白了很朴素:给团队配一个大家都能访问的共享盘,谁都不用为了传个文件专门连一次线。
光有一个 agent 不够,还得让几个工具搭伙干活
多台机器解决的是在哪儿跑,另一个经常被忽略的问题是用谁来跑。
现在能打的 AI 编程工具不止一个,Claude Code、Codex、Grok Build,各有各的脾气。我没有把自己焊死在某一个平台上,而是按任务类型分工:复杂架构决策交给擅长深度推理的那个,日常琐碎的重构和测试补全交给响应快、成本低的那个,卡壳了再换一个视角重新看。
这背后没什么复杂的架构,就是维护了一套统一的任务描述格式。不管派给哪个工具,输入输出的结构保持一致,agent 之间才好互相接力,而不用每换一个工具就重新写一遍上下文。
说到底,这也是原文那句"抬高稳定下限"的另一种落地方式:让好几个普通水平的工具,在各自擅长的场景里发挥,拼出一个整体不差的结果,比死磕一个最贵最强的模型更容易长期维持。
任务怎么真正派下去
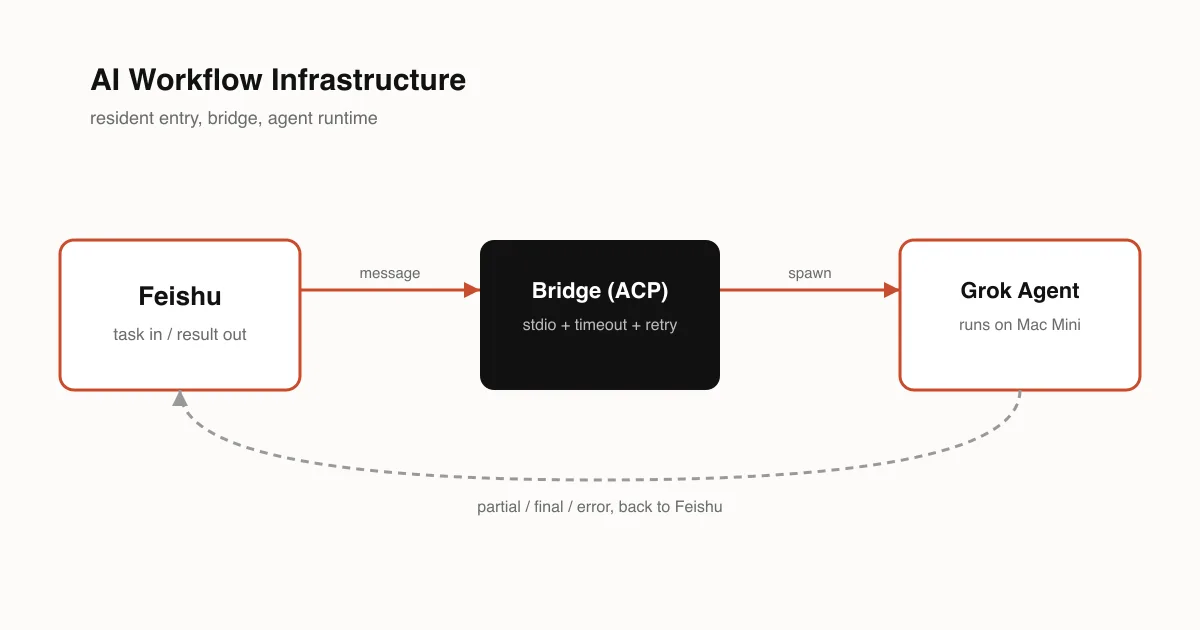
前面这些是骨架,真正让 agent 干活,还得有一层把消息和 agent 对接起来的代码。
我用的是 ACP 协议下 agent 的 stdio 通道,写了一个飞书和 Grok 之间的桥接服务。它做的事情很直接:收到飞书消息就转发给本地起的 agent 进程,agent 一边跑一边往回吐结果,桥接服务再把结果推回飞书。
下面是简化版的实现,保留了核心的错误处理逻辑:
// feishu-grok-bridge.ts
// 通过 ACP 协议的 stdio 通道,把飞书消息转发给 Grok agent,再把结果推回飞书

import { spawn, ChildProcessWithoutNullStreams } from 'node:child_process';
import { createInterface } from 'node:readline';

interface FeishuMessage {
  chatId: string;
  userId: string;
  content: string;
}

interface AcpResponse {
  type: 'partial' | 'final' | 'error';
  content: string;
}

class GrokFeishuBridge {
  private agentProcess: ChildProcessWithoutNullStreams | null = null;
  private readonly agentCommand = 'grok';
  private readonly agentArgs = ['agent', '--acp'];

  private startAgentProcess(): ChildProcessWithoutNullStreams {
    const proc = spawn(this.agentCommand, this.agentArgs, {
      stdio: ['pipe', 'pipe', 'pipe'],
    });

    // agent 进程的错误日志单独收集,方便排查连不上的问题
    proc.stderr.on('data', (chunk: Buffer) => {
      console.error(`[grok-agent stderr] ${chunk.toString()}`);
    });

    // 进程意外退出时清空引用,下次消息来了会重新拉起一个新进程
    proc.on('exit', (code, signal) => {
      console.warn(`grok agent 进程退出,code=${code} signal=${signal}`);
      this.agentProcess = null;
    });

    return proc;
  }

  async handleFeishuMessage(message: FeishuMessage): Promise<string> {
    if (!message.content?.trim()) {
      throw new Error('收到空消息,已忽略');
    }

    if (!this.agentProcess) {
      this.agentProcess = this.startAgentProcess();
    }

    const proc = this.agentProcess;
    const rl = createInterface({ input: proc.stdout });

    return new Promise((resolve, reject) => {
      // agent 偶尔会卡住不返回,必须有超时兜底,否则整条链路会一直挂着
      const timeout = setTimeout(() => {
        rl.close();
        reject(new Error('等待 agent 响应超时,任务已终止'));
      }, 120_000);

      let finalText = '';

      rl.on('line', (line: string) => {
        try {
          const response: AcpResponse = JSON.parse(line);
          if (response.type === 'partial') {
            finalText += response.content;
          } else if (response.type === 'final') {
            clearTimeout(timeout);
            rl.close();
            resolve(finalText + response.content);
          } else if (response.type === 'error') {
            clearTimeout(timeout);
            rl.close();
            reject(new Error(`agent 返回错误:${response.content}`));
          }
        } catch {
          // 输出里偶尔夹杂非 JSON 的调试信息,跳过即可,不能让一行脏数据打断整个会话
          console.warn('无法解析的一行输出,已跳过');
        }
      });

      const payload = JSON.stringify({
        chatId: message.chatId,
        userId: message.userId,
        text: message.content,
      });

      proc.stdin.write(`${payload}\n`, (err) => {
        if (err) {
          clearTimeout(timeout);
          reject(new Error(`写入 agent 失败:${err.message}`));
        }
      });
    });
  }
}

export const bridge = new GrokFeishuBridge();
这段代码没什么高深的地方,但几个细节是踩过坑之后才加上去的。超时机制是必须的,不加超时,agent 一卡住整个流程就会一直挂着。JSON 解析加了容错,agent 的输出偶尔会夹杂非结构化的调试信息,一行解析失败不能让整个会话崩掉。进程退出也要监听,agent 进程意外挂了,下一条消息进来得知道要重新拉起,而不是对着一个死掉的进程干等。
这些看起来琐碎的错误处理,恰恰是心法落不了地的地方。规范里写遇到问题要及时反馈,落到代码里就是这几行 try catch 和超时判断。
文档写多了,还得让 AI 找得到
知识沉淀这块,原文提到的 WIP.md、TODO.md、DEV_NOTE.md 我完全认同,但有个隐藏的坑:项目跑得久了,这几份文档会越写越长,AI 每次翻这些文档的成本也跟着涨。
我自己在做内容相关的项目时踩过这个坑,后来的解法是把长期沉淀的知识做了向量化索引,需要用的时候按相关度检索片段,而不是把整份文档一股脑塞进上下文。文档本身还是要维护,只是取用的方式换了个更省成本的路子。
光讲心法容易,把这套东西搭起来才是真门槛
说句实话,Meathill 那篇文章的心法部分我几乎没什么可挑的,行为规范该怎么写,流程该怎么定,都是经过验证的经验。我自己项目里的 AGENTS.md 思路也差不多。
但我觉得很多人看完这类文章,会有一种"我也就差这一步"的错觉。规范谁都会写,难的从来不是写规范,是把 agent 真正接进一个能被随时唤醒、能跨机器协作、能容错重试的系统里。这部分工作枯燥、琐碎,还很容易出 bug,但它才是决定这套工作流能不能真正跑一整年的地基。
写在最后
管理团队,光靠一份员工手册是带不动人的,你还得给他们工位,给他们系统权限,给他们能对接的工具。AI 团队也是一样,规范之外,还得有基础设施把这些团队成员真正接进你的日常。
古人说工欲善其事,必先利其器,放在这儿再合适不过。心法教我们怎么用人,基础设施决定我们有没有趁手的器可用。两者缺一不可,这大概就是我这一年多折腾下来最深的体会。