字节笔记本
2026年9月26日 · 约 4 分钟读完
本地部署大模型,显卡怎么选?从 8G 到 32G 全档位说清
本文整理自「老林说 · AIPC」系列第三集(抖音视频口播稿,原视频),数据经原UP主实测口径,个别型号按读音校正。
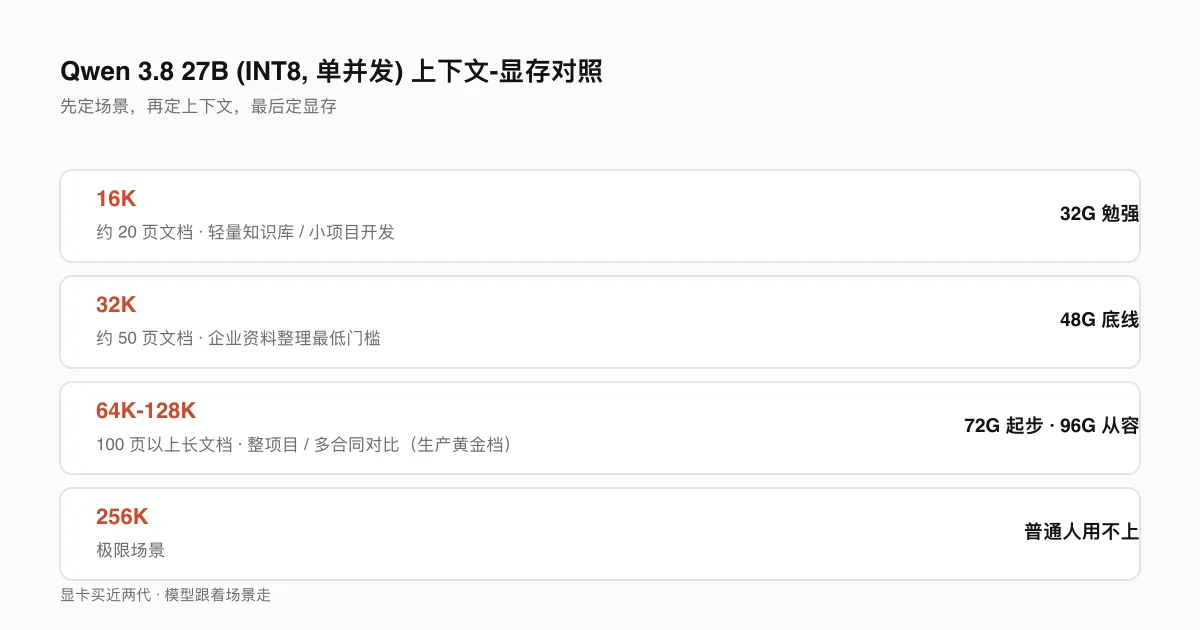
前两集算出了本地部署大模型真实的显存需求,这集讲显卡怎么选。先说一个重要前提:N 卡 30 系跟 40 系基本只剩二手了,所以以 50 系为主,30/40 系只在对应档位提一下。
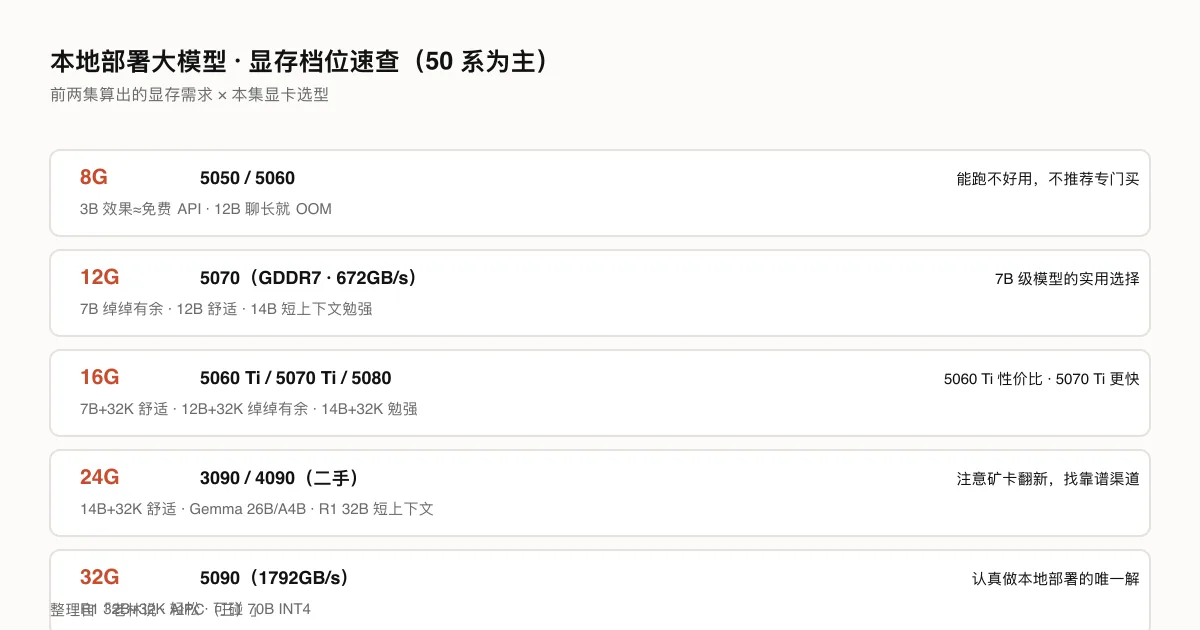
8GB:能跑,但不好用
可选 5050 和 5060。千问 3B 跟 Gemma 12B 的短上下文塞得进去,但塞得进去和好用是两码事——3B 的效果跟云端免费 API 差不多,12B 聊长一点就 OOM。已经有 8G 卡想玩没问题,专门为部署大模型去买一个,不推荐。
12GB:50 系的新档位
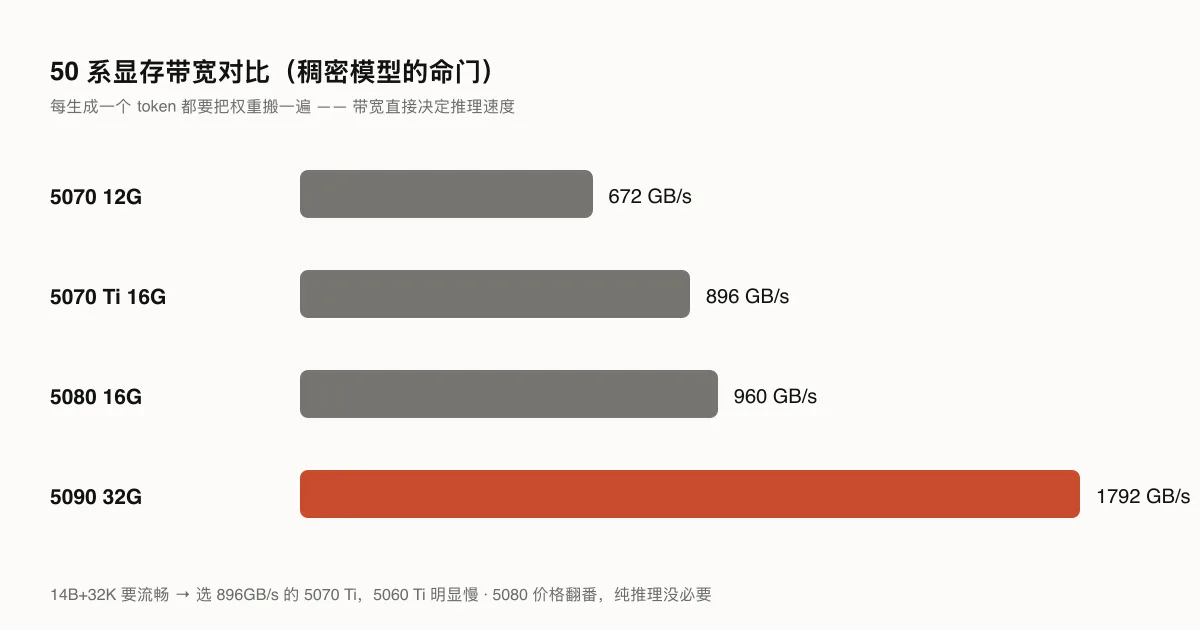
5070 12GB(GDDR7,带宽 672GB/s)。7B 模型正常上下文占 5-7GB,绰绰有余;Gemma 12B 正常上下文 8GB 左右也能舒适跑;14B 短上下文约 9GB,勉强可以。7B 级别模型终于可以舒适使用了。
16GB:三张卡怎么分
5060 Ti 16GB、5070 Ti 16GB、5080 16GB。跑分数据:7B+32K 约 6.8GB(舒适)、14B+32K 约 14.6GB(勉强,余量不多)、Gemma 12B+32K 约 8.4GB(绰绰有余)。
- 只跑 7B 和 12B → 5060 Ti 16GB 性价比最高;
- 要跑 14B+32K 且流畅 → 5070 Ti(带宽 896GB/s,明显快于 5060 Ti);
- 5080(960GB/s)更快但价格翻番——除非同时打游戏或渲染,纯 AI 推理没必要。
24GB:二手市场的甜点区
甜点卡是 4090(二手约小两万),3090 二手大几千。24GB 能舒适跑 14B+32K、Gemma 一类 26B/A4B,也能勉强跑 R1 蒸馏 32B 短上下文。二手风险不小,矿卡翻新卡鱼龙混杂——预算有限的话 3090 可能更合适,但务必找靠谱渠道。
32GB:认真玩的唯一解
5090 是消费级第一款 32GB 卡:GDDR7、带宽 1792GB/s、Blackwell 架构加第五代 Tensor Core。轻松驾驭 R1 蒸馏 32B+32K,甚至可以碰 70B 级别 INT4。确定要认真做本地部署、跑 32B 以上模型,5090 就是目前消费级唯一的解。
两个雷区
二手算力卡:V100、P100、A100。二手平台 V100 16GB 现在两千块,看着诱人——但 V100 是 2017 年架构,没有 INT4/FP4 量化支持,推理框架效率极低。同样 7B 模型,一张便宜的 5060 都比它快得多。这类卡为数据中心设计、不是为消费级推理设计,再便宜也不要买。
AMD 显卡:显存看着不少,但推理生态是 CUDA 的天下,ROCm 兼容性远不如 CUDA,主流框架"能用但不那么好用"。不是 A 卡硬件不行,是生态还没成熟到让普通人省心。技术强、愿意折腾的人可以玩;对大多数人,目前最省心的还是英伟达。
总结
8G 能跑不好用;12G 的 5070 是 7B 实用线;16G 里 5060 Ti 性价比最高、5070 Ti 更快;24G 的 3090/4090 二手注意渠道;32G 的 5090 是消费级旗舰;算力卡和 AMD 能不碰就不碰。
下一集预告:本地部署大模型的另一条路径——统一内存。(系列出处:老林说 · AIPC,第三集原视频)