字节笔记本
2026年10月14日 · 约 4 分钟读完
一张 4GB 显卡跑 2.8T 参数:AirLLM 的笨办法反而最有效
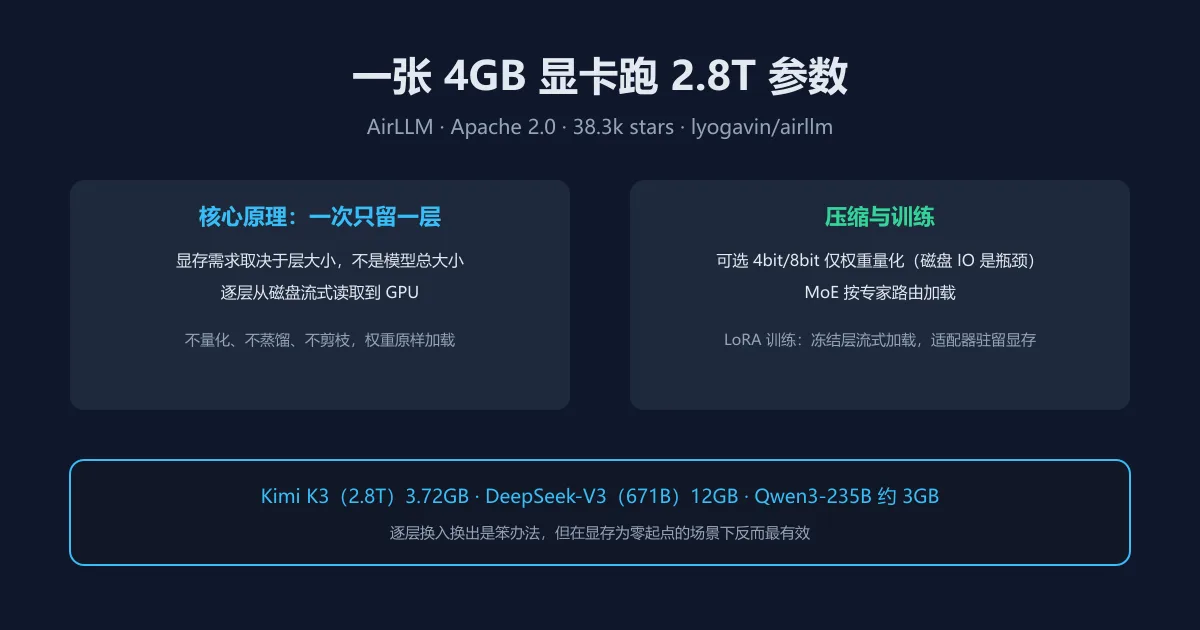
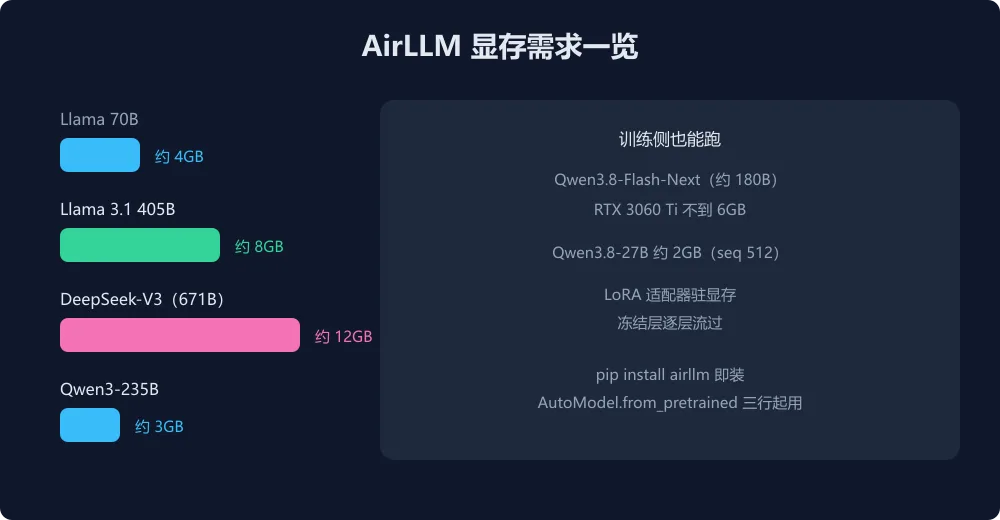
想在本地跑一个 671B 的 DeepSeek-V3,显存 12GB 就够;跑 2.8T 参数的 Kimi K3,3.72GB 就能起。这不是魔法压缩,是 lyogavin 的 AirLLM(Apache 2.0,GitHub 38.3k 星、3.9k fork)用的笨办法:一次只在 GPU 上放一层,其余的留在磁盘里按需流式读取。对买不起 H100 的个人开发者和预算有限的团队,这把万亿参数俱乐部的门第一次用游戏卡就能推开。
项目简介
AirLLM 的核心思路用一句话讲完:显存需求取决于单层大小,不是模型总大小。传统推理把整个模型加载进显存,70B 模型就要上百 GB;AirLLM 只把当前正在计算的解码层换入 GPU,算完换出,下一层换入,以此把任意大模型的显存需求压到个位数 GB。磁盘与计算之间还可以做预取重叠,官方称约提速 10%。模型首次使用时先按层切分成 shard 存入 HF 缓存目录,之后加载走同一套流式管线。对 MoE 架构(如 Kimi K3 的 2.8T 参数),AirLLM 只按 token 实际路由到的专家加载,跳过不活跃专家,MoE 的稀疏性第一次在推理显存上兑现。这个思路看起来最笨,但在显存为零起点的场景下反而最有效。
核心功能
三个层次的工程细节值得展开。第一,可选的 block-wise 仅权重量化:提供 4bit 和 8bit 两档,只压权重不压激活,作者的理由是瓶颈在磁盘 IO 而非计算,仅压权重对精度损伤更小,最高能带来三倍加速。第二,训练也能跑:冻结层逐层流过,LoRA 适配器常驻显存,Qwen3.8-Flash-Next(约 180B)在 RTX 3060 Ti 上不到 6GB 显存即可微调,Qwen3.8-27B 约 2GB,个人开发者用游戏卡微调大模型第一次成为现实。第三,覆盖面够宽:Llama 全系、Qwen 全系含 VL 与 FP8、DeepSeek V2/V3/R1、Mistral、Phi、Gemma、ChatGLM、Baichuan、InternLM、Yi、Kimi K3 基本一网打尽,macOS Apple Silicon 走 mlx 后端,纯 CPU 也能推理,CPU 模式磁盘约占 5GB。
快速上手
一条命令装,三行代码跑。首次运行时模型会被自动按层切分到缓存目录,这一步耗时较长但只需做一次;之后每次加载直接走流式管线。压缩与自定义 shard 路径都通过 from_pretrained 的参数控制,对已经熟悉 HuggingFace 生态的用户没有额外学习成本。
pip install airllmfrom airllm import AutoModel
model = AutoModel.from_pretrained("Qwen/Qwen3-32B")之后照常调用 tokenizer 与 generate,支持 4bit/8bit 压缩参数与自定义 shard 路径等选项。
适合谁用
手里有旧显卡或想用笔记本验证大模型的开发者是第一受众:不用租 H100 就能看看 2.8T 模型的表现,代价是速度慢(IO 主导)。团队内部做数据隐私敏感的推理原型,权重不出磁盘就能验证可行性。对追求生成速度的场景,流式加载不适合生产高并发,本地开发调试用完再换全显存方案更合理。诚实的定位是:这是一把钥匙,把万亿参数俱乐部的门打开了,至于进去之后跑多快,得看你的 NVMe 给不给力。