字节笔记本
2026年9月24日 · 约 5 分钟读完
1.7 万次会话实测:三大编码 Agent 是怎么选工具的
开发工具圈最近有一份挺特别的研究:Armature 团队跑了 16,893 个会话,就为了回答一个问题——Claude Code、Codex、Cursor 这三个编码 Agent,在给项目选第三方服务(数据库、支付、邮件、部署)的时候,到底是怎么做决定的,最后谁会赢。
背景是 Vercel 今年 4 月公布的一组数据:超过 30% 的部署已经由编码 Agent 发起,半年涨了十倍。Agent 不只在写代码,它在替你做技术选型。这对开发者是个信任问题,对工具厂商则是生死问题——你的产品会不会被 Agent 选中。
先说清楚这项研究的方法和它的立场。Armature 自己是给开发工具做增长服务的,这项研究本来就属于"怎么影响编码 Agent 选择"的工作的一部分,数据有立场,解读时要带着这个前提看。但方法做得相当扎实。
实验怎么做的
他们先分析了数千个公开 GitHub 仓库的语言、框架、第三方服务和团队规模分布,然后搭了 75 个仿真仓库:10 种编程语言,假公司名、假 Git 历史、假 API key,但锁文件是真的、能和 npm registry 对上的。
任务来自四种人设:只描述症状的 vibe coder、提到类目的初级工程师、讲约束的高级工程师、带合规和采购要求的大厂工程师。共 1,163 种提示词变体,在 E2B、Blaxel、Daytona 三家沙箱轮换执行。
还有一个细节很讲究:他们用 Gemini 3.7 Flash 扮演"模拟人类"在环。因为真实使用中很少是一句提示就放手,通常是 Agent 先给推荐,人拍板。另一个 Gemini 实例当裁判,剔除仓库预先选边等无效会话。最后 16,893 次运行里,5,292 个会话被认定有效发布。
五个发现
一、三个 Agent 的信息来源完全不同,而且经常吵不出结果。
Cursor 三分之二的会话靠联网搜索做决策;Codex 94% 的会话都联网,而且十次里有九次用 site: 这类搜索指令只看信任域名;Claude Code 主要靠模型自身记忆,只有约 30% 的场景联网,但一旦联网,浏览的页面数是 Codex 的三倍——在沙箱这类它记忆里没有的新兴品类,联网率会跳到 80%。
结果是:三个 Agent 只有 42% 的场景选出同一个工具。语音 agent 品类里,Claude Code 选 Twilio,Codex 选 OpenAI Realtime API,Cursor 选 Vapi。另外 Claude Code 自研方案的比例(19%)几乎是另外两家(10%)的两倍。
二、仓库上下文是最大的变量。
同一个需求,四种语言的仓库,选出四个不同的邮件服务赢家:TypeScript 仓库 Resend 赢(55/89),Python 仓库 SendGrid 赢(22/24),Go 仓库 Postmark 赢(20/24),Java 仓库 Azure ACS 赢(22/23)。Vercel 在 TypeScript 仓库通吃(Next.js 项目 100% 中选),在 Python 仓库却从未被推荐,那边是 Render 的地盘。
三、被提及不等于被选中。
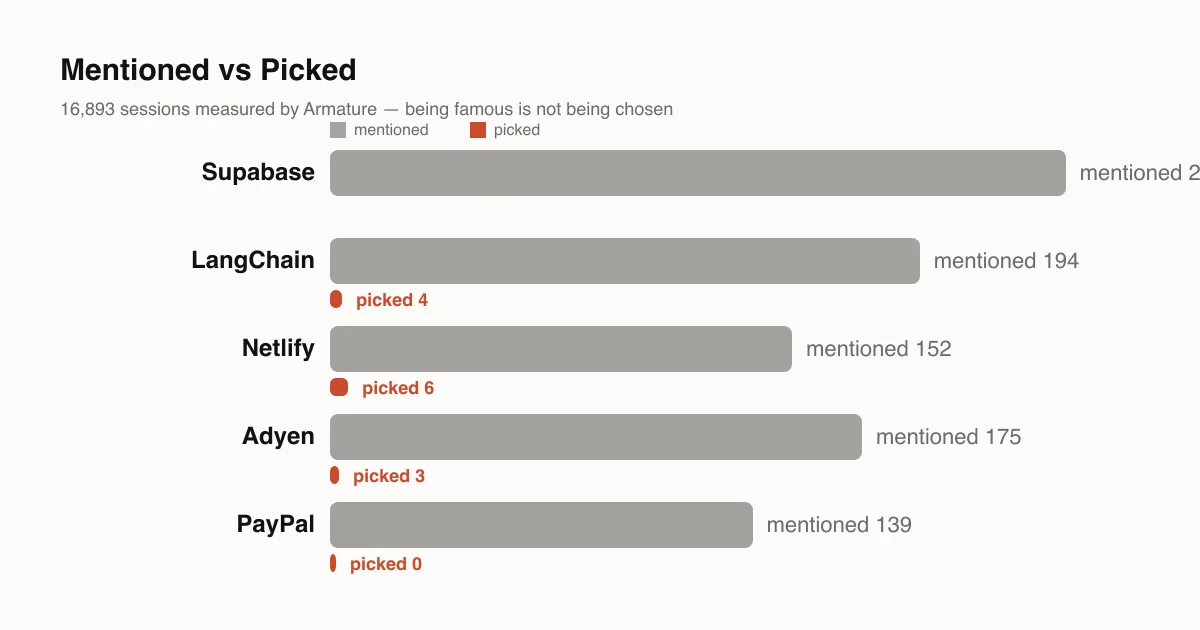
这是整份研究里最有传播力的数据。支付品类,PayPal 被提及 139 次、选中 0 次(这 139 次里 Stripe 赢了 124 次);Adyen 被提 175 次、只中 3 次。LangChain 是被提及最多的框架(194 次),只被选中 4 次。Netlify 被提 152 次选中 6 次。Supabase 是被提及最多的数据库(242 次),依然被 Neon 大幅压制。
四、细节能翻盘。
Mailgun 经常输给 Postmark,原因是 Agent 读到了它免费版的"日志只保留 1 天";Supabase 总是输,是因为它把 auth、存储、realtime 这些 BaaS 功能打包展示,而 Agent 要的只是一个纯数据库。5,292 个会话里,388 次提到平台管理开销、195 次提到成本——其中不少是信息呈现方式的问题,不是产品真的不行。
五、有的市场一家独大,有的高度分散。
支付里 Stripe 十战九胜,只在欧盟合规场景输给 Paddle、Mollie 这些专精玩家。数据库 Neon 拿下 66%,其余归云厂商原生方案。文件存储 Amazon S3 占 45%。邮件服务 Resend(35.6%)和 Postmark(27.4%)缠斗正酣。
几点想法
对开发者,这份研究最大的价值是把"Agent 的判断可信吗"量化了:同一个需求,换个语言换个仓库,答案就完全不同。Agent 的推荐是强上下文相关的,不是客观评测。
对工具厂商,游戏规则变了:被提及只是入场券,被选中才是结果,而决定后者的可能只是文档里一句话的呈现方式。当然,这份研究本身出自一家做 Agent 增长服务的公司,实验设计和数据都公开了(完整 traces 可查),但"如何被 Agent 选中"正是它们的生意,这个立场要记住。
Agent 时代的 SEO,可能真的要来了。
原文:armature.tech/blog/which-tools-coding-agents-install(本文为解读转述,数据与结论均归 Armature 原作者)。