字节笔记本
2026年10月6日 · 约 29 分钟读完
一本书一美元:把书变成 AI Skill 的三条路线
把一本几百页的书读完,能留下多少?大多数人的答案是:很快忘掉 90%。最近 X 上有一条热议的推文给出了另一个思路:读任何一本技能书,都可以直接转成 Skill,让 AI Agent 随时调用。我的第一反应是:一本几百页的书,怎么就变成一个 SKILL.md 了?
答案是:它不是把书扔进上下文里让你问问题,而是把书拆解成结构化的决策框架,让 AI Agent 在你工作的时候按需调用。
GitHub 上这个方向已经至少有三个独立项目。这篇文章把它们全部拆开,讲清各自怎么用、适合谁、差在哪,最后给一份可以直接照着做的实操指南。
一、book-to-skill 到底在做什么
1.1 传统方式 vs book-to-skill 方式
以前你想「用一本书」来辅助工作,大概有三种做法:
| 做法 | 问题 |
|---|---|
| 直接把 PDF 扔给 AI | 上下文窗口塞不下整本书;就算塞下了,AI 只会给你概述,不会帮你做决策 |
| 自己总结重点贴在提示词里 | 你总结了 3000 字,还是丢掉了书的 90%;而且每次换场景得重新写提示词 |
| 手动把书里的方法论写成 Skill | 最理想,但工作量大到没人会去做:没人愿意花一整天把一本书拆成结构化的 SKILL.md |
book-to-skill 做的就是第三件事:自动化地把书拆解成结构化的 Skill。
但它不是简单粗暴地「总结每章内容」,它的核心设计是:
- 提取决策框架,不是总结故事;
- 按需加载章节,不一次性塞进上下文;
- 以从业者视角(practitioners voice)输出:「当 X 时用 Y」,而不是「书中提到了 X」。
1.2 一个具体的例子
假设你把《穷查理宝典》变成了 Skill。以后你在 AI Agent 里工作,遇到这种场景:
你: "我在纠结要不要继续投这个项目,已经投了 200 万了"

AI(加载了穷查理宝典的 Skill):
"你现在陷入了沉没成本陷阱。Charlie Munger 的原则是:
 不要考虑已经投入的成本,只看未来收益。

 具体建议:
 1. 假设你今天才听说这个项目,你会投吗?
 2. 如果不会,立刻止损
 3. 设置一个 tripwire:亏损超过 300 万就自动退出"
这比你自己翻书找答案快得多,也比直接问 AI「穷查理芒格会怎么说」精准得多,因为 Skill 里已经把书里的智慧结构化了。
二、三个项目,三条路线
GitHub 上这个方向有三个主要项目,分别面向不同的书和不同的人群。
2.1 项目 A:virgiliojr94/book-to-skill,英文技术书,最成熟
仓库:virgiliojr94/book-to-skill,2026 年 5 月 23 日登上 GitHub Trending Python 日榜第 10 名。
这是最早、最成熟、功能最全的版本:把任何技术书的 PDF/EPUB/DOCX 拆解成一个 Agent Skill,支持 Claude Code、GitHub Copilot CLI、Amp。
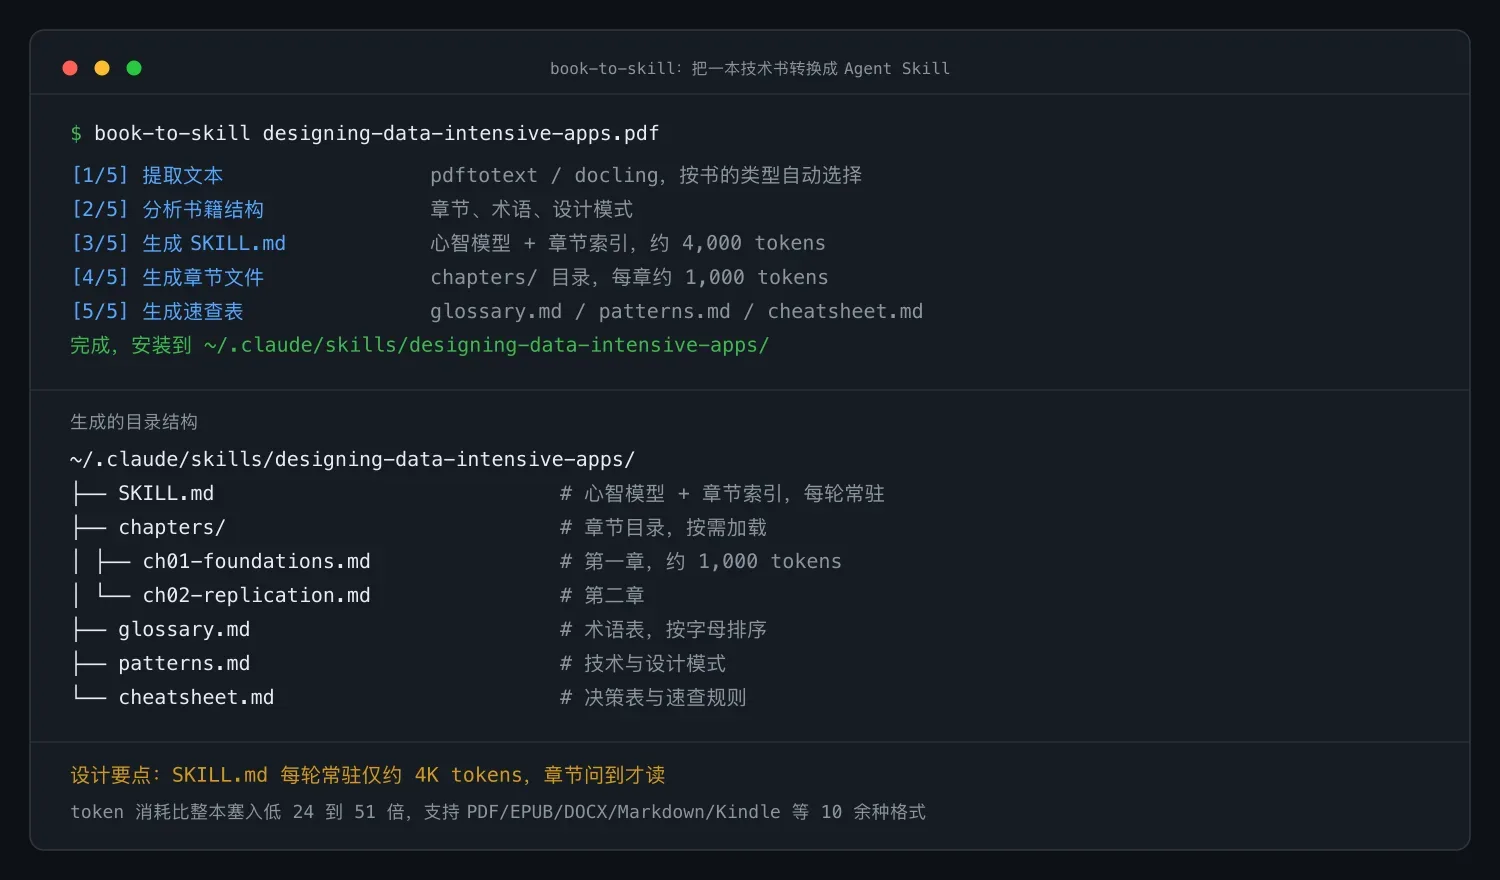
生成的文件结构:
~/.claude/skills/designing-data-intensive-apps/
├── SKILL.md           # 核心心智模型 + 章节索引(约 4,000 tokens)
├── chapters/
│   ├── ch01-foundations.md       # 第一章核心内容(约 1,000 tokens)
│   ├── ch02-replication.md       # 第二章
│   ├── ch03-storage-engines.md   # 第三章
│   └── ...
├── glossary.md         # 所有关键术语,按字母排序(约 1,500 tokens)
├── patterns.md         # 所有技术、算法、设计模式(约 2,000 tokens)
└── cheatsheet.md       # 决策表和速查规则(约 1,000 tokens)
注意一个关键设计:SKILL.md 本身只有约 4,000 tokens,它不包含书的全部内容,只包含心智模型和章节索引。每一章的详细内容是按需加载的,只有当你问到那章的内容时才会被读取。
性能数据:相比把整本书扔进上下文,节省 24 到 51 倍的 token 消耗。
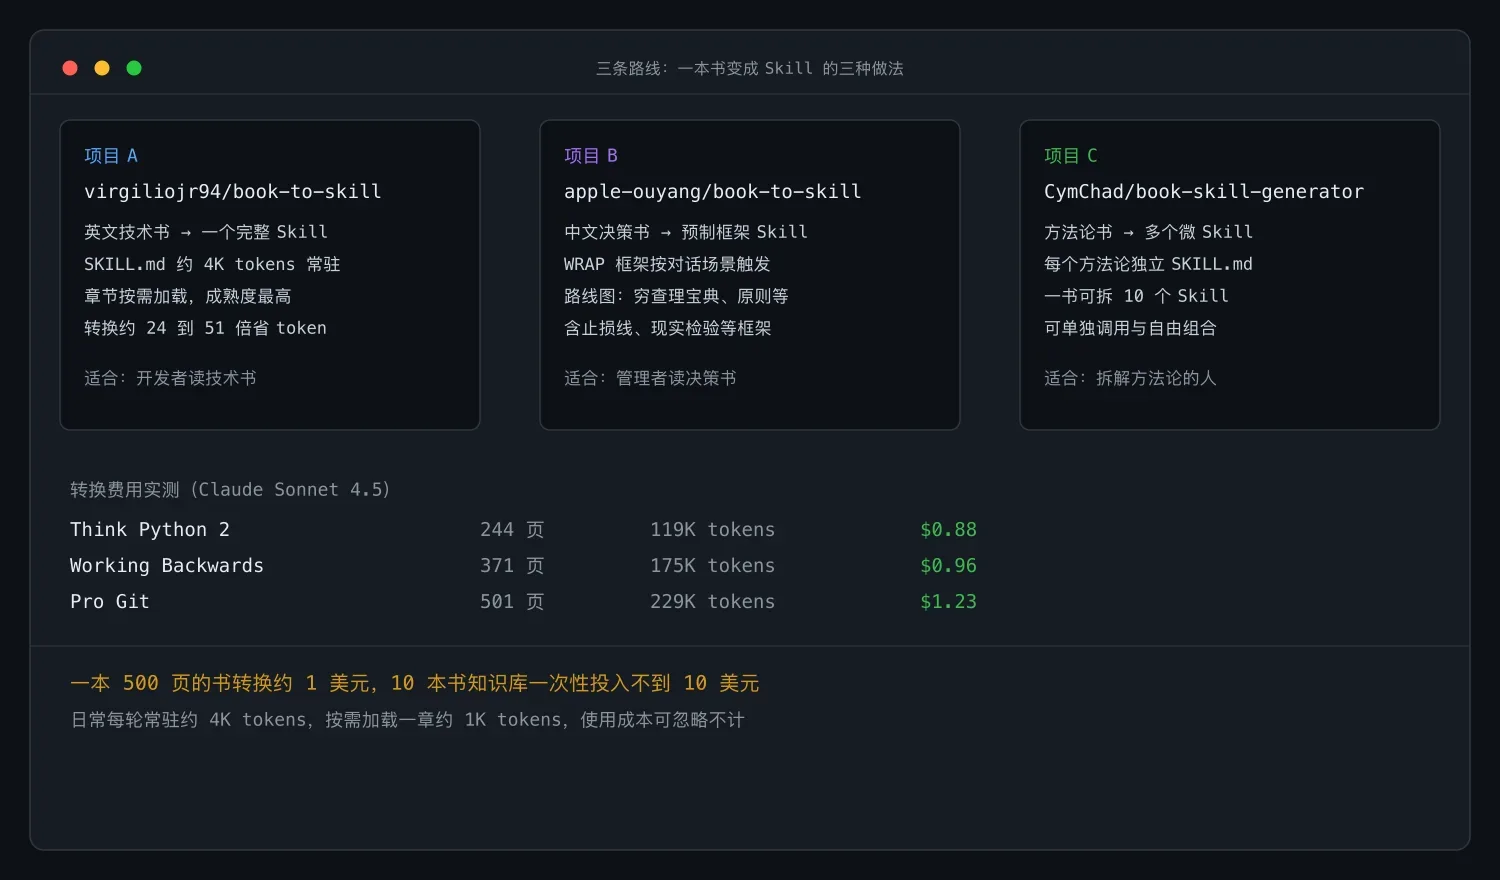
费用:用 Claude Sonnet 4.5 处理一本书大约 1 美元:
- Think Python 2(244 页):119K tokens,0.88 美元
- Working Backwards(371 页):175K tokens,0.96 美元
- Pro Git(501 页):229K tokens,1.23 美元
2.2 项目 B:apple-ouyang/book-to-skill,中文决策书,聚焦框架
仓库:apple-ouyang/book-to-skill。
这个版本专门针对中文决策类书籍,做了很多本地化的工作。核心设计差异:它不是一个通用转换器,而是一套预制的决策框架 Skill。目前已实现的包括:
| Skill 名称 | 触发场景 | 功能 |
|---|---|---|
| making-decisions | 「要不要做X」「我在纠结」 | WRAP 决策框架:拓宽、现实检验、保持距离、准备好 |
| reality-testing-decisions | 「我觉得这个会成功」 | 用小实验代替预测 |
| seeking-disconfirming-evidence | 「大家都同意」 | 扮演魔鬼代言人,主动寻找反面证据 |
| decision-tripwires | 「再等等看」「已经投了很多」 | 设置止损线,克服沉没成本 |
它的路线图里有《穷查理宝典》,还有《原则》、《思考快与慢》、《高效能人士的七个习惯》、《巴菲特致股东的信》。
2.3 项目 C:CymChad/book-skill-generator,方法论提取器
仓库:CymChad/book-skill-generator。
核心差异:一本书拆成多个独立 Skill。比如从《精益创业》中提取 10 个独立 Skill:
/mvp                  最小可行产品方法论
/build-measure-learn  构建-测量-学习循环
/pivot                转向决策框架
/validated-learning   验证式学习
每个方法论是一个完全独立的 Skill,有自己的 SKILL.md,可以单独调用。
2.4 三个项目对比
| 维度 | 项目 A | 项目 B | 项目 C |
|---|---|---|---|
| 语言 | 英文为主 | 中文为主 | 中文 |
| 适合书类 | 技术书 | 决策/商业书 | 方法论书 |
| 输出形式 | 一本书对应一个 Skill | 预制框架 Skill | 一本书对应多个微 Skill |
| 章节加载 | 按需加载 | 框架触发 | 独立调用 |
| 成熟度 | 最高,Trending 上榜 | 中等,路线图还在 | 较新 |
| 适合人群 | 开发者读技术书 | 管理者读决策书 | 想拆方法论的人 |
三、项目 A 深度拆解:技术书 Skill 的最佳实践
项目 A 是目前最成熟的方案,重点拆它的设计。
3.1 三步工作流
Step 1: 指向文件
  /book-to-skill ~/books/designing-data-intensive-apps.pdf

Step 2: 自动拆解
  AI 读取全书,提取心智模型,生成章节文件,构建术语表,制作速查表

Step 3: 按需使用
  /designing-data-intensive-apps              # 加载核心心智模型
  /designing-data-intensive-apps replication  # 查找并解释特定主题
  /designing-data-intensive-apps ch05         # 深入第五章
3.2 为什么「按需加载」是关键设计
你可能会问:为什么不直接把整本书的摘要塞进一个 SKILL.md?
因为 Agent 的上下文窗口是有限的,每一个 Skill 的 description 都会占用每一轮对话的上下文。如果 SKILL.md 有 20,000 tokens,那就是每一轮都多花 20K tokens 的成本。
项目 A 的设计是:
SKILL.md(4K tokens):每一轮都加载,包含心智模型和章节索引

chapters/ch*.md(每个约 1K tokens):只在需要时加载,你问什么,加载什么

glossary.md / patterns.md / cheatsheet.md:独立文件,按需查阅
这意味着日常使用的 token 成本只有 4K,但需要详细信息时可以按需扩展到几十 K。
3.3 密度优先(Density over Completeness)
项目 A 的核心设计原则:1,000 token 的精炼总结,好过 10,000 token 的原文摘录。
它不是「压缩」书,而是在重新创作:从书里提取框架、决策规则、反模式,用从业者视角重写。对比一下:
错误示范: "书中第三章讨论了分布式系统的 CAP 定理..."

正确示范: "当你在设计分布式系统时,先问自己:这个场景需要 CP 还是 AP?
   - 需要强一致性(如银行转账)选 CP
   - 需要高可用(如社交点赞)选 AP
   - 两者都要:设计上做不到,必须取舍"
3.4 PDF 提取策略
不同类型的书用不同的 PDF 提取方式:
| 书的类型 | 推荐提取器 | 速度 | 原因 |
|---|---|---|---|
| 文字为主(散文,少表格) | pdftotext | 极快 | 纯文本效果好 |
| 技术类(代码、表格、公式) | docling | 约 1.5 秒/页 | 保留 Markdown 表格和代码块 |
工具会自动问你书的类型,选择最优的提取策略。
四、项目 B 深度拆解:中文决策框架 Skill
项目 B 的设计思路和项目 A 有根本性差异,而且更贴近开头「穷查理芒格」的场景:它不是把一本书变成一个通用 Skill,而是从书中提取特定的决策框架,每个框架做一个独立的 Skill。
以《行为设计学:掌控关键决策》为例,书中提出的 WRAP 框架被拆成了 4 个独立 Skill:
making-decisions               WRAP 总框架
reality-testing-decisions      R:Reality-test(现实检验)
seeking-disconfirming-evidence W:Widen(拓宽)
decision-tripwires             Prepare(准备好)
每个 Skill 有自己的触发场景,AI Agent 在你日常对话中检测到这些场景时自动加载。实际触发效果:
你: "我觉得这个项目一定会成功,所有人都看好"

AI 检测到触发词,加载 reality-testing-decisions Skill:

AI: "让我帮你做一个现实检验。
  目前你的判断基于什么证据?

  建议你做三件事:
  1. 找一个'唱反调的人',让他给你 3 个这个项目会失败的理由
  2. 做一个小实验:先投 10 万跑一个月看数据
3. 写下你的预测和信心程度,一个月后对照"你: "已经投了 200 万了,现在停的话就全打水漂了"
AI 检测到触发词,加载 decision-tripwires Skill:
AI: "你正在受沉没成本效应影响。Charlie Munger 说:
'如果让你今天重新决定,你会投吗?'
建议设置止损线:
1. 定义一个明确的标准:再亏损 50 万就退出
2. 把这个标准写下来,现在就告诉团队
3. 用'事前验尸'的方法:假设项目已经失败,倒推最可能的原因"项目 B 还有一个叫 swarm 的 Skill,支持多 Agent 并行处理:多个 Agent 同时处理一本书的不同章节,每个 Agent 负责一个章节、提取框架,最后合并成一个统一的 Skill。
五、实操指南:从零开始把一本书变成 Skill
5.1 把一本技术书变成 Skill(用项目 A)
# Step 1: 安装 book-to-skill
git clone https://github.com/virgiliojr94/book-to-skill.git \
    ~/.claude/skills/book-to-skill

# Step 2: 在 Claude Code 会话中使用
/book-to-skill ~/books/designing-data-intensive-apps.pdf

# AI 会自动:
# 1. 提取 PDF 内容
# 2. 分析书籍结构(章节、术语、模式)
# 3. 生成 SKILL.md + chapters/ + glossary.md + patterns.md + cheatsheet.md
# 4. 安装到 ~/.claude/skills/designing-data-intensive-apps/

# Step 3: 开始使用
/designing-data-intensive-apps                 # 查看核心心智模型
/designing-data-intensive-apps replication     # 查询复制相关内容
/designing-data-intensive-apps ch03            # 深入第三章
费用估算:一本 500 页的技术书,用 Claude Sonnet 4.5 大约 1.23 美元。
5.2 安装中文决策框架 Skill(用项目 B)
# 方式 1: 在 Claude Code 中直接说
"帮我安装 book-to-skill 的所有 Skills:https://github.com/apple-ouyang/book-to-skill"

# 方式 2: 手动安装
git clone https://github.com/apple-ouyang/book-to-skill.git
cd book-to-skill

# 安装决策框架 Skill
cp -r skills/making-decisions ~/.claude/skills/
cp -r skills/reality-testing-decisions ~/.claude/skills/
cp -r skills/seeking-disconfirming-evidence ~/.claude/skills/
cp -r skills/decision-tripwires ~/.claude/skills/

# 可选:安装 PDF 处理能力
npx @anthropic-ai/claude-code-skills install pdf
安装后直接在对话中使用:「我在纠结要不要接受那个 offer」会自动触发 making-decisions;「这个项目已经投了 300 万了,要不要继续」会自动触发 decision-tripwires。
5.3 从一本书提取多个方法论 Skill(用项目 C)
# 安装
git clone https://github.com/CymChad/book-skill-generator.git
mkdir -p ~/.claude/skills/
cp -r book-skill-generator ~/.claude/skills/

# 使用(以《精益创业》为例)
"帮我把《精益创业》拆成多个独立的方法论 Skill"
AI 会从书中提取多个独立的方法论,每个生成一个独立的 SKILL.md,如 mvp、build-measure-learn、pivot、validated-learning,各自独立目录、独立调用。
5.4 把多本书合并成一个知识 Skill
项目 A 支持多个输入:
/book-to-skill ~/papers/paper1.pdf ~/notes/export.txt unified-research
/book-to-skill "~/books/*.epub" my-library
/book-to-skill ~/workspace/project-docs/ project-knowledge
如果你已经有一个 Skill,想加入新的内容,fold-in 更新可以把新文件折叠进已有的 Skill,不会覆盖之前的内容:
/book-to-skill ~/articles/new-paper.pdf ~/.claude/skills/project-knowledge5.5 支持的文件格式
项目 A 支持 PDF、EPUB、DOCX、纯文本、Markdown、reStructuredText、AsciiDoc、HTML、RTF,以及 Kindle 的 mobi/azw/azw3,共 10 余种格式。
5.6 如果你用的不是 Claude Code
book-to-skill 不只支持 Claude Code:GitHub Copilot CLI 放到 ~/.copilot/skills/ 后执行 /skills reload;Amp 与其他通用 Agent 放到 ~/.agents/skills/;也可以作为独立 CLI 工具安装:
pip install "book-to-skill[pdf,epub,docx]"
book-to-skill ~/path/to/book.pdf --mode text
或者用 skills.sh(Agent Skill 包管理器)一键安装:
npx skills add https://github.com/virgiliojr94/book-to-skill六、进阶玩法:自己写「书级」Skill
如果不想用现成的工具,也可以参考 book-to-skill 的设计原则,手动把一本书拆成 Skill。设计模板:
---
name: your-book-skill
description: 当你提到[书名]相关的问题,或需要[核心主题]的指导时使用
---

# [书名] 核心心智模型

## 三个最核心的框架
1. **框架一名称**:一句话定义
   - 什么时候用:[触发场景]
   - 怎么用:[2-3 步骤]
2. **框架二名称**:...
3. **框架三名称**:...

## 反模式(千万别做的事)
- 反模式 1:描述 + 正确做法
- 反模式 2:描述 + 正确做法

## 决策表
| 你在做什么 | 你应该用什么 | 避免用什么 |
|-----------|------------|-----------|
| 场景 A    | 框架 X     | 框架 Y    |
| 场景 B    | 框架 Y     | 框架 X    |

## 章节
- [ch01](chapters/ch01-xxx.md) - 章名
- [ch02](chapters/ch02-xxx.md) - 章名
关键原则有五条:
- SKILL.md 控制在 4,000 tokens 以内:心智模型加索引就够了;
- 每个章节单独一个文件:按需加载,不浪费上下文;
- 用从业者视角写:「当 X 时用 Y」,不是「书里说了 X」;
- 密度优先:1K token 的精炼好过 10K token 的摘录;
- 包含反模式:知道「不该做什么」和知道「该做什么」一样重要。
七、这件事的深层意义
7.1 书不再是「读过就忘」的东西
我们都有这个体验:买一本书,读的时候觉得「说得太好了」,放下之后很快就忘了 90%。
book-to-skill 的本质是把「阅读体验」变成「工作能力」:不是让你记住书的内容,而是让你在遇到实际问题时,AI 能自动帮你调用书里的智慧。
7.2 知识的「可执行化」
传统的知识管理方式是:
书 → 笔记 → Evernote → 灰尘
book-to-skill 的方式是:
书 → 结构化 Skill → AI Agent 按需调用 → 影响你的决策
知识从「存放在那里」变成了「随时可执行」,这是知识管理的一次范式转移。
7.3 Skill 是新一代的「知识资产」
以前团队的知识资产是 Wiki 文档(没人看)、Confluence 页面(没人更新)、共享笔记(没人搜索)。现在可以是一套 Skill,每个对应一本书的核心框架,AI Agent 在工作流中自动调用,新人入职时一句话就能安装所有团队知识。
7.4 生态信号
这个方向在 2026 年年中已经很热闹:book-to-skill 登上 GitHub 趋势榜 Top 10;至少 3 个独立项目在做同一件事;skills.sh 包管理器已支持 Skill 分发;CSDN、知乎上已经有中文教程;MCP Market 有了专门的 book-to-skill 入口。
这说明一件事:「把知识变成可执行的 Skill」正在成为一个被验证的方向。
八、适用人群和落地建议
8.1 谁应该关注
| 角色 | 推荐项目 | 用法 |
|---|---|---|
| 开发者 | 项目 A | 技术书转 Skill,工作中随时查阅 |
| 管理者/创业者 | 项目 B | 决策书转框架 Skill,辅助决策 |
| 方法论研究者 | 项目 C | 一本书拆成多个微 Skill |
| 团队知识管理者 | 项目 A 加自定义 | 把团队必读书变成共享 Skill |
| 个人知识管理 | 项目 A 加项目 B | 建立自己的「决策知识库」 |
8.2 推荐落地路径
第 1 周:用项目 A 把你最常查阅的一本技术书变成 Skill
         体验一下「工作中随时调用心智模型」的感觉

第 2 周:用项目 B 安装决策框架 Skill
         在日常决策中观察 AI 的触发效果

第 3 周:挑一本对你影响最大的书
         按模板手动拆成 Skill
         理解 SKILL.md 的设计原则

第 4 周:为团队建立一套「必读 Skill」
         每本核心书一个 Skill
         新人入职时一句命令安装全部
8.3 费用估算
| 操作 | Token 消耗 | 费用(Sonnet 4.5) |
|---|---|---|
| 把一本书变成 Skill | 约 120K 到 230K | 0.88 到 1.23 美元 |
| 日常使用 SKILL.md | 约 4K/轮 | 0.012 美元/轮 |
| 按需加载一个章节 | 约 1K/次 | 0.003 美元/次 |
| 10 本书的知识库 | 约 2M(一次性) | 约 10 美元(一次性) |
结论:建一个 10 本书的 Skill 知识库,一次性投入不到 10 美元,日常使用成本可以忽略不计。
九、信息汇总
| 项目 | 仓库 | 许可证 | 核心定位 |
|---|---|---|---|
| virgiliojr94/book-to-skill | GitHub | MIT | 英文技术书转完整 Skill |
| apple-ouyang/book-to-skill | GitHub | MIT | 中文决策书转框架 Skill |
| CymChad/book-skill-generator | GitHub | MIT | 方法论书转多个微 Skill |
| skills.sh | skills.sh | 无 | Agent Skill 包管理器 |
| 兼容的 Agent | 安装路径 |
|---|---|
| Claude Code | ~/.claude/skills/ |
| GitHub Copilot CLI | ~/.copilot/skills/ |
| ZCode / Amp | ~/.agents/skills/ |
| 独立 CLI | pip install "book-to-skill[pdf,epub,docx]" |
Skill 不只是一种 AI 工具的配置文件,它可能是下一代的知识载体。以前我们把知识存在书里、笔记里、Wiki 里,都是静态的,需要你主动去翻;现在知识可以变成 Skill,AI Agent 在你工作的时候、在你需要的时候,自动帮你调出来。
一本书从 PDF 变成 Skill,不是简单的格式转换,而是把「被动知识」变成「主动能力」。一本书 1 美元的转换成本,换来的是这本书的智慧在未来的每一次决策中都能被即时调用。这个投入产出比,很难找到不做的理由。