字节笔记本
2026年10月9日 · 约 10 分钟读完
换后端还改模型泛型,这种写法不该再续了
换一次后端还要改模型上的泛型,这种写法不该再续了。Burn 0.22.0 在 2026-10-06 放出,官方博文 Burn 0.22.0: Faster Builds, Easier Extensions, and Smarter Autotuning 和发布页把用户侧的 B: Backend、AutodiffBackend 拿掉,改成设备自己选后端。仓库 tracel-ai/burn 本轮 API 核到 16078 星、1084 个 fork,许可证 Apache-2.0,创建 2022-07-18,最近推送 2026-10-09。语言是 Rust。发布页写成四年稳定接口之后的大改,后面跟了五个月训练和推理工作。
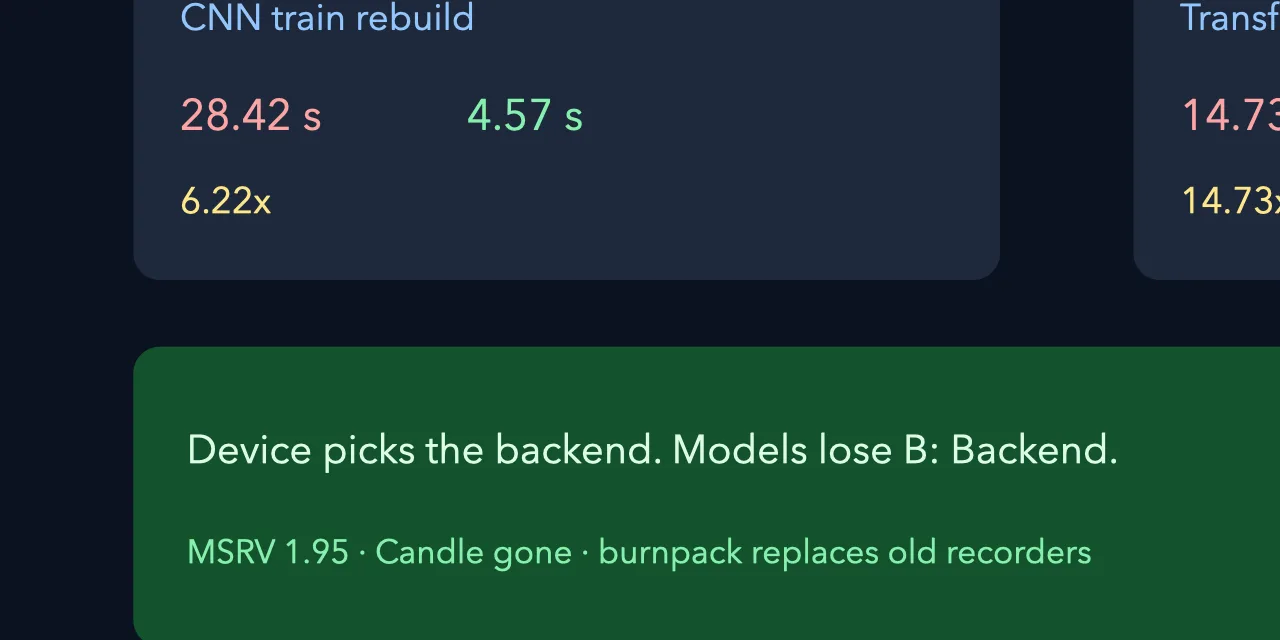
重建时间是这篇最硬的数。官方用三次运行的中位数:CNN 训练重建从 28.42 秒(27.50 到 31.18)降到 4.57 秒(4.29 到 4.78),6.22 倍;Transformer 自定义循环从 14.73 秒(14.36 到 15.06)降到 1.00 秒(1.00 到 1.01),14.73 倍。博文把上限写成大约 15 倍。这些是官方表,不是本轮复现。路径写成 Tensor 到 Bridge 到 Dispatch 到 Backend,自定义算子走 #[backend_extension],示例是融合的矩阵乘加 ReLU。
设备选后端,模型不再背 B
迁移指南 Migrating to 0.22 把张量和模块上的后端泛型去掉,写成 Tensor<D>、Tensor<D, Int> 和 Device。构造要显式:Device::cuda(0)、Device::wgpu(...)、Device::flex()。远程是 Device::remote_options(&host).init()?,要开 remote 特征,需要时再加 remote-websocket。种子、同步、刷新都在 Device 上。flush() 返回 Result<(), ExecutionError>。不要再用 Device::default() 当主路径。
自动微分改成运行时开关。先 device.autodiff() 再初始化。检查用 is_autodiff()、is_tracked()、is_require_grad()。require_grad() 只打在源叶子上。set_require_grad(false)、detach()、without_autodiff() 不是同一件事。backward() 会吃掉可达步,再来一次要重算或把损失并起来。to_device() 会保住自动微分和检查点上下文。模块侧用 fork 做独立叶子,train() / valid() 替换原来的 AutodiffModule。valid() 快照会丢掉检查点策略,训练模型要自己留着。
最低 Rust 版本写成 1.95,上一档是 1.92。Candle 已移除,NdArray 和 LibTorch 标成弃用。没有默认后端,Cargo 特征按用到的开:sqlite 或 sqlite-bundled、linalg、signal、safetensors / pytorch(会拉 store)、optim、rl。要删掉的旧特征包括 candle*、router、dispatch、distributed、collective、record-item-custom-serde。跟踪改成按需开。本轮没有在本机跑 cargo test。
检查点从 Recorder 换成 burnpack。新接口是 model.save_file("model.bpk")? 和 model.try_load_file("model.bpk")?。load_file 出错会直接崩。改文件名不会完成格式转换。旧的 MessagePack、二进制、JSON 要先在 0.21 里读出来,再经 SafeTensors 进 0.22。迁移指南写:参数能过去,优化器和调度器状态过不去。耦合的 LSTM 检查点先 allow_unused(true) 再另存。默认训练检查点会分别给模型、优化器、调度器写 burnpack。
use burn::{module::Module, nn::{Linear, LinearConfig}, tensor::{Device, Tensor}};

#[derive(Module, Debug)]
struct Model { linear: Linear }

impl Model {
    fn new(device: &Device) -> Self {
        Self { linear: LinearConfig::new(4, 2).init(device) }
    }
    fn forward(&self, input: Tensor<2>) -> Tensor<2> {
        self.linear.forward(input)
    }
}

let device = Device::flex().autodiff();
let model = Model::new(&device);
let input = Tensor::<2>::ones([8, 4], &device);
0.21 到 0.22 的权重迁移按指南抄两条:旧项目用 NamedMpkFileRecorder 读入,再 SafetensorsStore 写出;新项目用同一个 store 读回。本轮不代跑转换。
步时、显存和还没做完的口
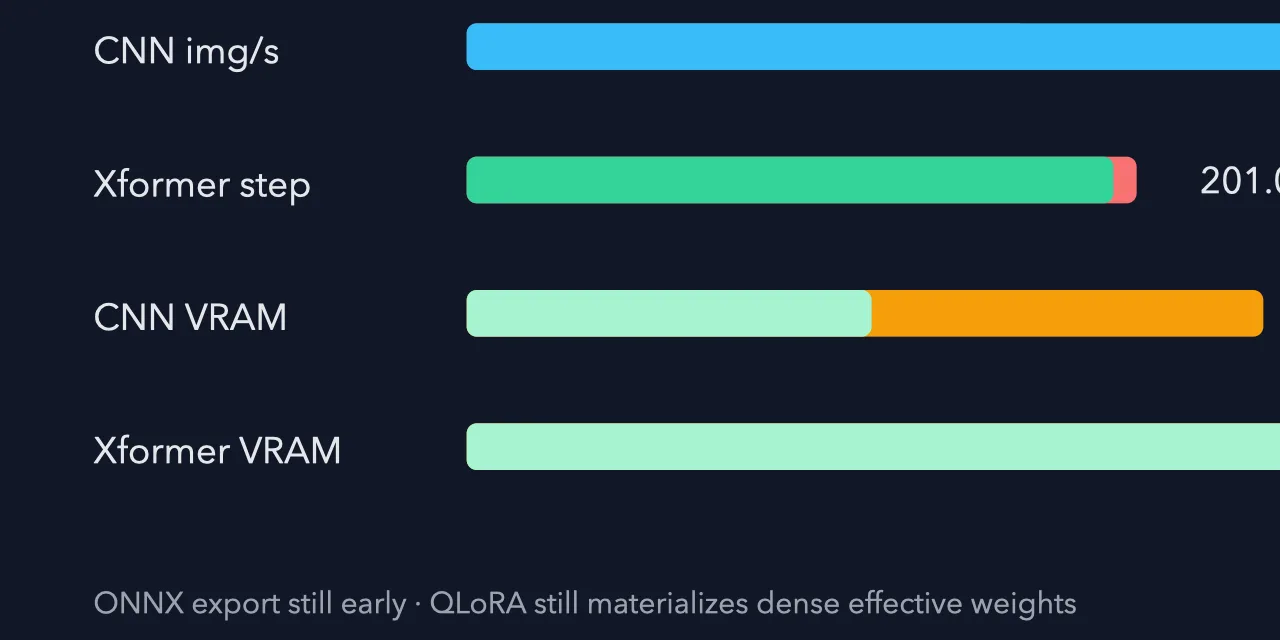
CUDA FP32 写在 RTX 4050 笔记本上,50 步预热加 500 步。CNN 步时 37.96 毫秒(37.91 到 37.97)降到 21.13 毫秒(21.08 到 21.17),少 44.3%;吞吐 6743.93 张/秒到 12115.55 张/秒,1.80 倍。Transformer 步时 201.04 毫秒(200.94 到 201.25)到 193.76 毫秒(193.05 到 195.68),只少 3.6%;序列吞吐 39.79 到 41.29,1.04 倍。预热后峰值显存:CNN 956 MiB 到 486 MiB,少 49.2%;Transformer 3486 MiB(3390 到 3742)到 2868 MiB,少 17.7%。自适应内存池、自适应自动调参、CUDA/HIP 图回放、WGPU 软件图、CubeCL Environment 缓存都写在同一篇博文里。CubeCL 编译器走 Pliron,还有 LLVM GPU 目标、CubeK 分块、LoRA / QLoRA、早期 ONNX 导出、Iroh 远程。
限制也写死了。ONNX 导出仍早,算子覆盖有限;Burn 能跑或 ONNX 能导入,不等于能导出。QLoRA 训练仍会铺开稠密有效权重,峰值显存可能超过打包权重加适配器。发布页另有 0.22.0-pre.1 / pre.2 / pre.4。标签后还记了 34 个提交。Lobsters 今日有人贴过 0.22.0,分数 4,热度以仓库和官方博文为准,不要把论坛分当成星数。
读这篇记住四件事。一,模型不再背后端泛型,设备自己选。二,重建时间的 6.22 倍和 14.73 倍绑在官方三次中位数上。三,CUDA 表绑在 RTX 4050 笔记本、FP32、50 加 500 步。四,许可证 Apache-2.0,Candle 已删,旧 Recorder 要自己迁。站内旧稿写过 Whisper 烧录字幕,那是另一条搜索命中,和这个深度学习框架不是一篇。mini-AGI 是消费卡上按字节持续学习,框架层和模型实验不要并成一篇。ONNX 导出仍早,不要把 0.22 理解成已经能随便导出。QLoRA 仍会铺开稠密有效权重,峰值显存别按打包体积去估。远程设备要单独开特征,不是默认就有。发布页把这次写成四年稳定接口之后的大改,升级前先走迁移指南,不要只改版本号。GitHub 周榜上的调试器仓和这次发版无关,不并进。日榜上的技能包、代码评审和逆向工程仓本轮都已写过,也不拿来垫框架发版。cs.CL 新稿 PHRBench 和 CoTrace 没有可装的框架发行,留下一季。读 0.22 先改 Device,再迁检查点,最后才看那两张加速表。本轮打开的是 2026-10-06 博文、同日发布页和迁移指南,数字以这三处为准。标签后还记了三十四个提交,预发布有三个号。最低语言版本从一点九二抬到一点九五,旧项目先过这一关再谈倍速。自定义循环那条从十四点七三秒降到一秒,和卷积训练重建的六点二二倍不是同一张表,引用时写清任务。笔记本上的四百零五十卡只代表官方 CUDA 单精度设置,不要外推成桌面旗舰卡。