字节笔记本
2026年10月28日 · 约 3 分钟读完
配音不用录了:Chatterbox 三档开源模型按需选
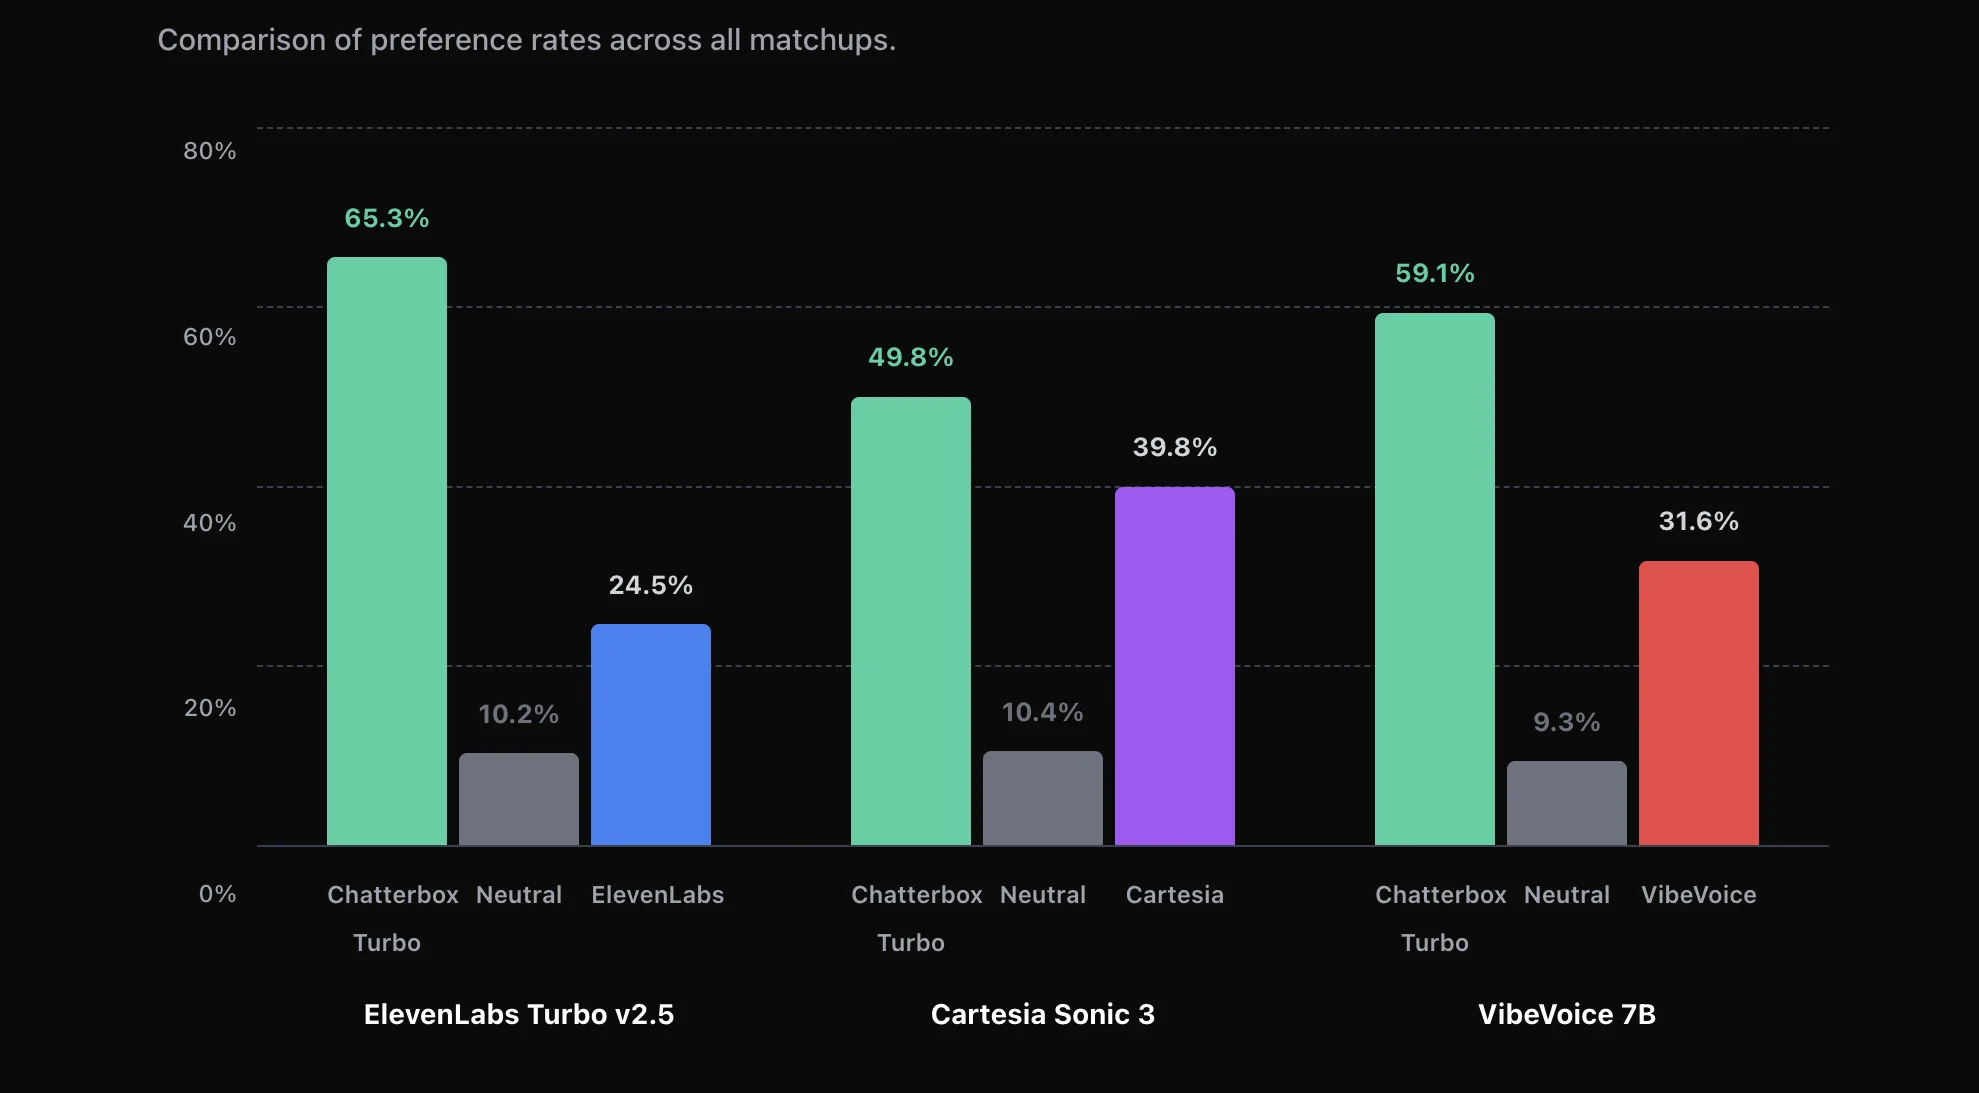
出片的配音环节,很多人还卡在「要么自己录、要么按字数付费」的两难里。Resemble AI 开源的 Chatterbox 已经悄悄从单一模型长成了一个家族:2.7 万星、MIT 协议,官方定位是 SoTA 开源 TTS。现在的阵容里有主打多语言的 Multilingual V3、主打低延迟的 Turbo 和塞进手机的 Nano,本系列第 16 个工具就是它。
一、家族三档,按预算选
Multilingual V3 是当前旗舰,0.5B 参数、覆盖 23 种以上语言,相比前代提升了说话人相似度、减少了幻觉,官方推荐做跨语言声音克隆选它;配套还有 6 个单语言专精微调组成的 Language Pack。Turbo 走另一条路,350M 参数、面向英语语音 agent,解码器从 10 步蒸馏成 1 步,还原生支持 [laugh]、[chuckle]、[cough] 这类副语言标签,文本里写上方括号就能让配音带上笑场。Nano 再砍到 110M,专门面向设备端和 CPU 推理,8 核 CPU 跑出 3 倍实时速度。
安装就是一句 pip install chatterbox-tts,Turbo 的生成代码很短:
from chatterbox.tts_turbo import ChatterboxTurboTTS

model = ChatterboxTurboTTS.from_pretrained(device="cuda")
text = "Hi there, Sarah here [chuckle], have you got one minute to chat?"
wav = model.generate(text, audio_prompt_path="your_10s_ref_clip.wav")
注意声音克隆的方式:给一段 10 秒的参考音频,模型照着这个音色念你的文本。
二、放进出片流水线
配音在流水线里的位置很清晰:文案定稿后,Chatterbox 批量生成旁白音轨,多语言版本选 Multilingual V3;生成结果可以再交给 faster-whisper 反向转录,和原稿逐句校对,字幕就有了。整条链路零人工录音,改一处文案重跑一遍脚本即可,这正是 MIT 协议加开源权重给本地部署带来的自由度。
一句必要的提醒:声音克隆请只用自己的声音或拿到授权的声音,这条线别越。
声音之外还差配乐和音效,下一篇是 Tone.js,浏览器里的合成器与音效引擎。