字节笔记本
2026年10月10日 · 约 4 分钟读完
三步让编码智能体先读仓库演进史
三步让编码智能体先读仓库演进史
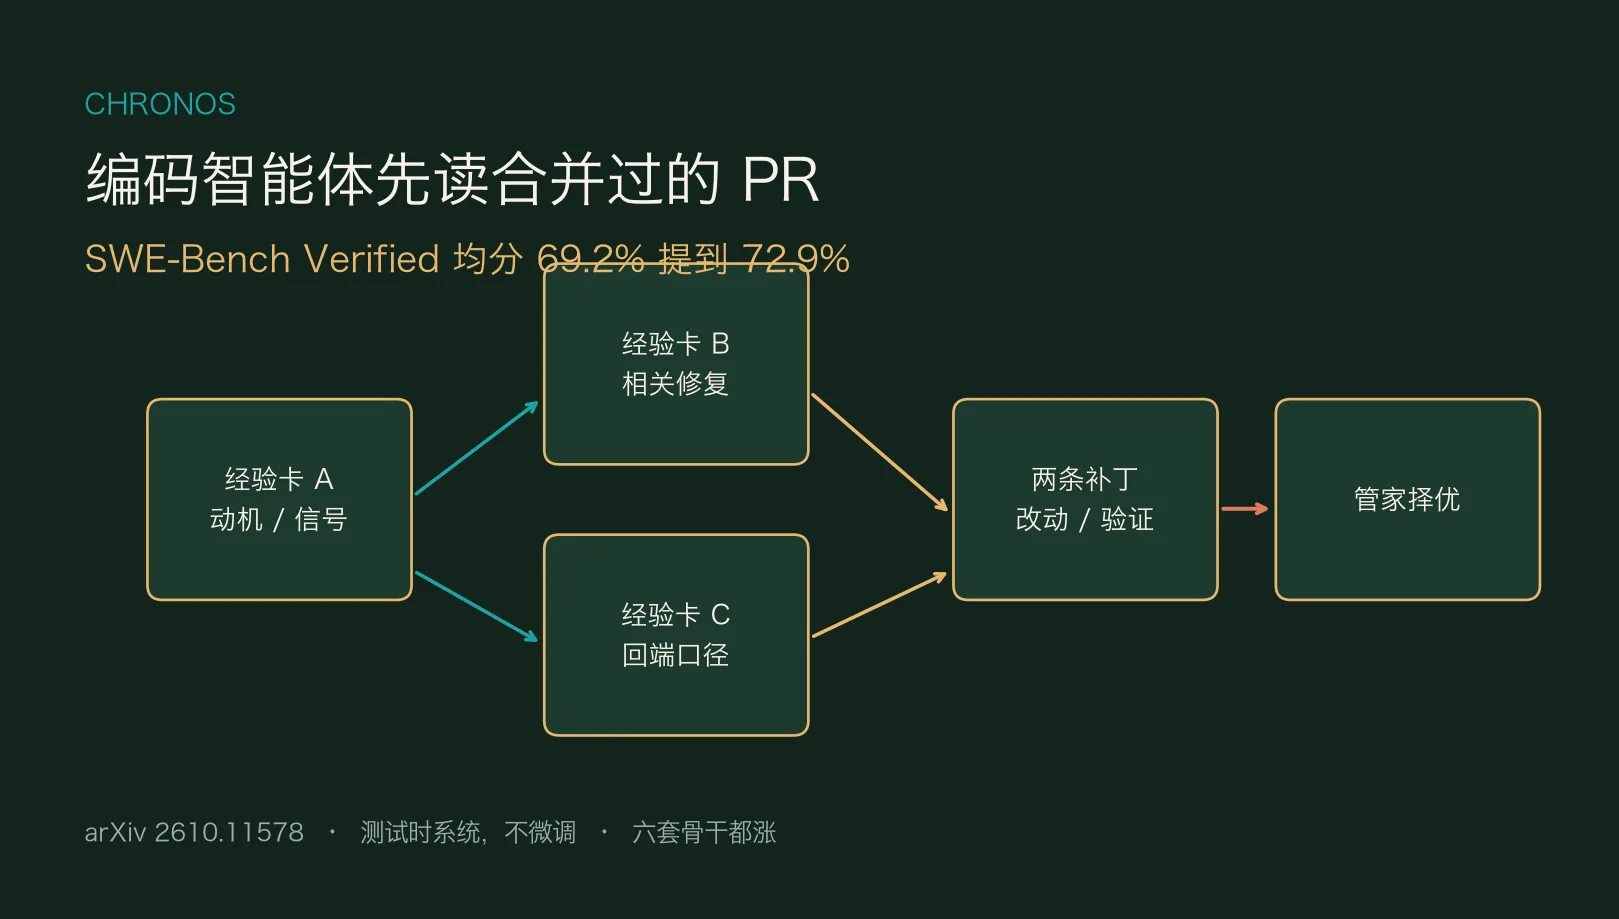
只把当前工作树丢给编码智能体,它会漏掉已经合并进主线的约束:为什么这种改法被否过,回端口径怎么写,同一批评审人后来又补了哪一层检查。Chronos 不微调模型,只在测试时把历史拉取请求做成经验卡,再按类型图往外扩几跳。
第一步:把已合并的 PR 压成四字段卡
每张经验卡有摘要、信号、动机、方案四个字段,用 Qwen3.5-Plus 从已合并的拉取请求里蒸馏出来。卡挂在一张带类型的多重图上,边覆盖代码连续性、开发者意图和组织关系,一共 11 种:先后、扩展、跟随、回端口、引用、同一批评审人、同一批评论者、同一里程碑、相近标签、评论里互相点名、依赖。历史截止到任务对应拉取请求之前,避免把后来的修复泄漏进当前题。
第二步:检索入口卡,再按权重扩三跳
任务到来时,先用 DashScope text-embedding-v4 做向量检索,找到入口卡,再按边权做多跳扩展,默认入口 K 等于 5、跳数 H 等于 3,候选短名单最多 10 张。智能体还能调用 graph_search 和 graph_read。这不是把整本仓库史塞进上下文,而是先收到和当前缺陷相关的一小簇经验。
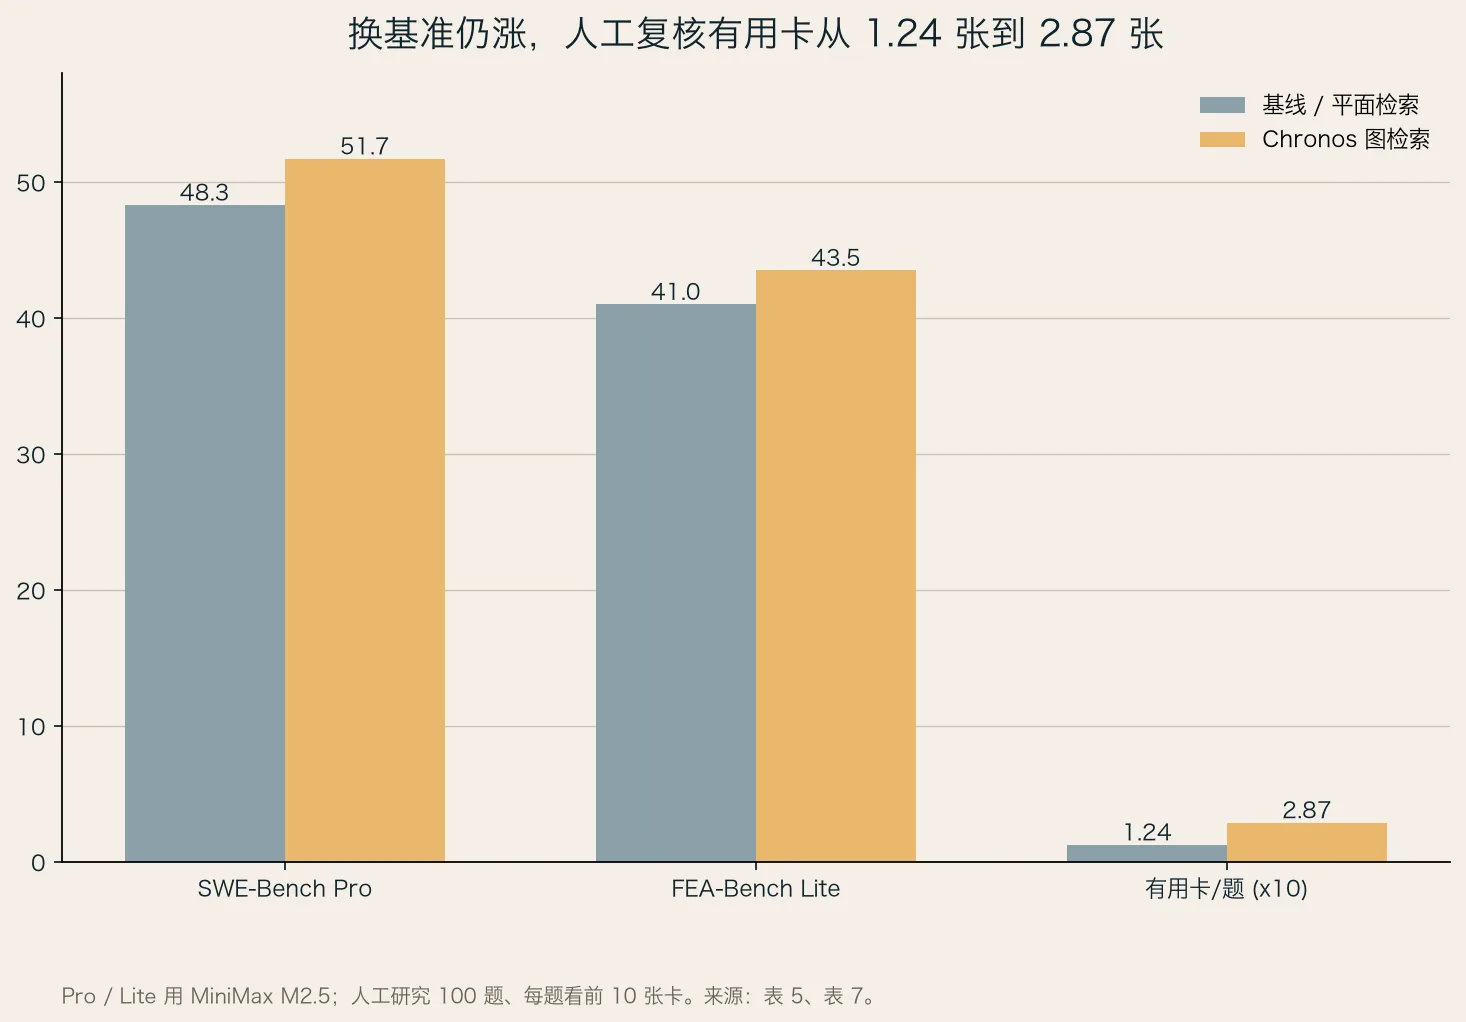
人工复核 100 题、每题看前 10 张卡:平面语义检索平均只有 1.24 张有用,命中率 68%;加上类型图之后,有用卡升到 2.87 张,命中率 89%。两位组内标注者的 Kappa 是 0.86。论文自己写明:有用不等于来源叙述完全准确,蒸馏也会丢掉或扭曲上下文。
第三步:两条补丁分工,管家按演进史挑一条
一套生成器盯补丁本身,另一套盯验证策略,各自交一版;演进管家读历史和代码,只留一条。单次运行预算按 1.5 美元、最多 250 步封顶。它是套在 SWE-Agent 上的测试时插件,同样的流程也能接到 mini-SWE-Agent。
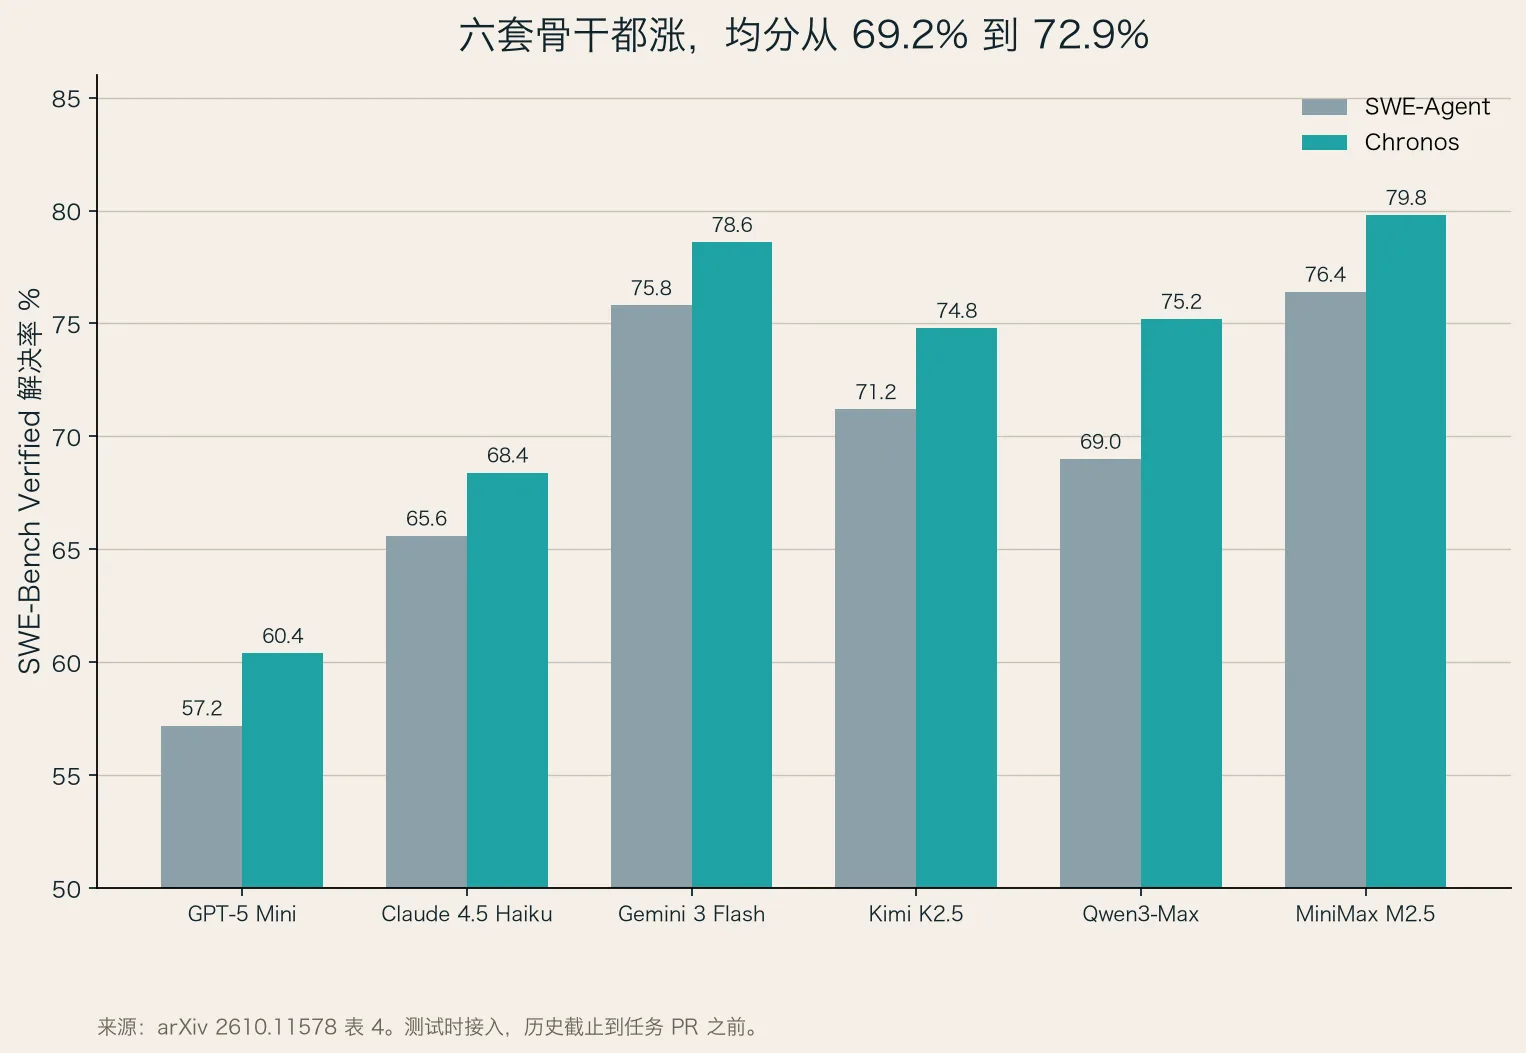
SWE-Bench Verified 共 500 题。六套骨干从 SWE-Agent 接到 Chronos 后,解决率分别是:GPT-5 Mini 57.2% 到 60.4%,Claude 4.5 Haiku 65.6% 到 68.4%,Gemini 3 Flash 75.8% 到 78.6%,Kimi K2.5 71.2% 到 74.8%,Qwen3-Max 69.0% 到 75.2%,MiniMax M2.5 76.4% 到 79.8%。均分从 69.2% 到 72.9%,平均涨 3.7 个百分点。MiniMax M2.5 跑满流程五次,得到 79.8、80.0、80.6、79.6、80.0,均值 80.0%,标准差 0.37 个百分点。
同一骨干迁到另外两份基准:SWE-Bench Pro 731 题从 48.3% 到 51.7%,FEA-Bench Lite 200 题从 41.0% 到 43.5%。消融里,拿掉验证策略智能体剩 78.4%,拿掉补丁向智能体剩 77.8%,拿掉演进图剩 79.0%;原 SWE-Agent 是 76.4%,mini-SWE-Agent 从 75.8% 到 79.2%。单智能体只喂经验也高于原套件:改动向 78.4%,验证向 77.8%。
边权是手调的,论文没有做敏感性扫描;多数配置只跑一轮。摘要和正文都没有给出独立代码仓,能核的是方法、表 4 到表 7 的数字,以及 CC BY 4.0 的预印本。把它当可复现配方,还得等作者把图构建和管家提示公开。
参考:论文 2610.11578。