字节笔记本
2026年10月5日 · 约 28 分钟读完
人类对 Cloudflare 的开发程度还不到 5%
01 / 一个被严重低估的帝国
先做一个思想实验。
假设你今天想上线一个网站或 API 服务,需要:一个能抗住流量尖峰的入口、一个能跑后端逻辑的地方、一个能存文件和数据库的存储层、一个能自动扩缩容的 AI 推理能力,最好还能在全球各地都快,而且预算为零。
十年前,这是一个笑话。五年前,你需要 AWS 的免费额度、各种折腾、还要担心信用卡被意外扣款。而今天,你只需要一个 Cloudflare 账号。
过去几年,Cloudflare 已经从一个 CDN 公司,长成了一个**"边缘云"(Edge Cloud)平台**。它的核心叙事是:把计算、存储、网络能力下沉到全球 330 多个城市的边缘节点,让代码和数据离用户更近,而不是集中在几个大型数据中心。
这个故事 AWS、Google Cloud 也在讲,但 Cloudflare 的差别在于两点:
- 免费额度慷慨到离谱:每天 10 万次 Worker 请求、10GB 对象存储、5GB 数据库、每天 1 万次 AI 推理……这些是"永久免费",不是 12 个月试用。
- 边缘优先:你的代码默认跑在离用户最近的城市节点,而不是某个固定的 us-east-1 区域。
很多人知道 Cloudflare,但只用了它的 DNS 和 CDN。这就是本文标题的意思:绝大多数人对 Cloudflare 的开发程度,不到它能力的 5%。
下面,我们按层次把 Cloudflare 的主要组件拆开讲。
02 / 第一层:网络的入口(DNS + CDN + WAF)
这是 Cloudflare 最老、最知名的部分,也是大多数人和 Cloudflare 的第一次接触。
DNS:互联网的电话簿
当你访问 example.com,浏览器首先要问 DNS 服务器:"这个域名对应的 IP 是什么?"Cloudflare 提供全球最快的权威 DNS 解析之一,免费用户就能用。
把域名的 NS(Name Server)改成 Cloudflare 给你的那两条,DNS 就接管了。一个有意思的细节:Cloudflare 的 DNS 默认会隐藏你的源站 IP:别人查 example.com 拿到的是 Cloudflare 的 IP,而不是你服务器的真实 IP。这一步直接挡掉了大量直接打源站的攻击。
CDN:内容分发网络
CDN 的逻辑很简单:把你网站的静态资源(图片、CSS、JS)缓存到全球各地的节点,用户访问时从离他最近的节点拿,不用每次都回源到你的服务器。
Cloudflare 的 CDN 免费版就包含:
- 无限带宽(这点很关键,AWS CloudFront 免费额度只有 100GB/月)
- 全球 330+ 城市节点
- 页面规则(Page Rules):精细控制哪些路径缓存多久、哪些不缓存
实操上,你只要把域名接入 Cloudflare,DNS 记录旁那个橙色的云朵图标点亮(Proxied),CDN 就自动开启了。一个常见配置:静态资源走 CDN 缓存,动态请求透传回源。
WAF:Web 应用防火墙
免费版自带基础 WAF,可以挡掉常见的 SQL 注入、XSS、机器人扫描。付费版有自定义规则、速率限制、机器学习规则集,但对个人项目和小站,免费版的默认规则集已经够用。
一个被低估的用法:用 WAF 的自定义规则做"地理封锁"或"路径白名单"。比如只允许你自己的 IP 访问 /admin,一行规则搞定,不用在应用代码里写。
这一层的核心价值:免费给你一个"互联网入口"。DNS、CDN、WAF、DDoS 防护、SSL 证书(自动续签)打包在一起,别人单独买这些服务一年要好几百块,Cloudflare 全包了。
03 / 第二层:计算(Workers)
这是 Cloudflare 最革命性的产品,也是"边缘云"叙事的核心。
Workers 是什么
传统的服务器:你租一台机器(或一个容器),代码跑在那台机器上,用户请求路由到那台机器。
Workers 的模型完全不同:你写一段 JavaScript / TypeScript / Python / Rust 代码,上传到 Cloudflare,这段代码会被复制到全球所有节点。用户请求到来时,由离他最近的节点执行你的代码。
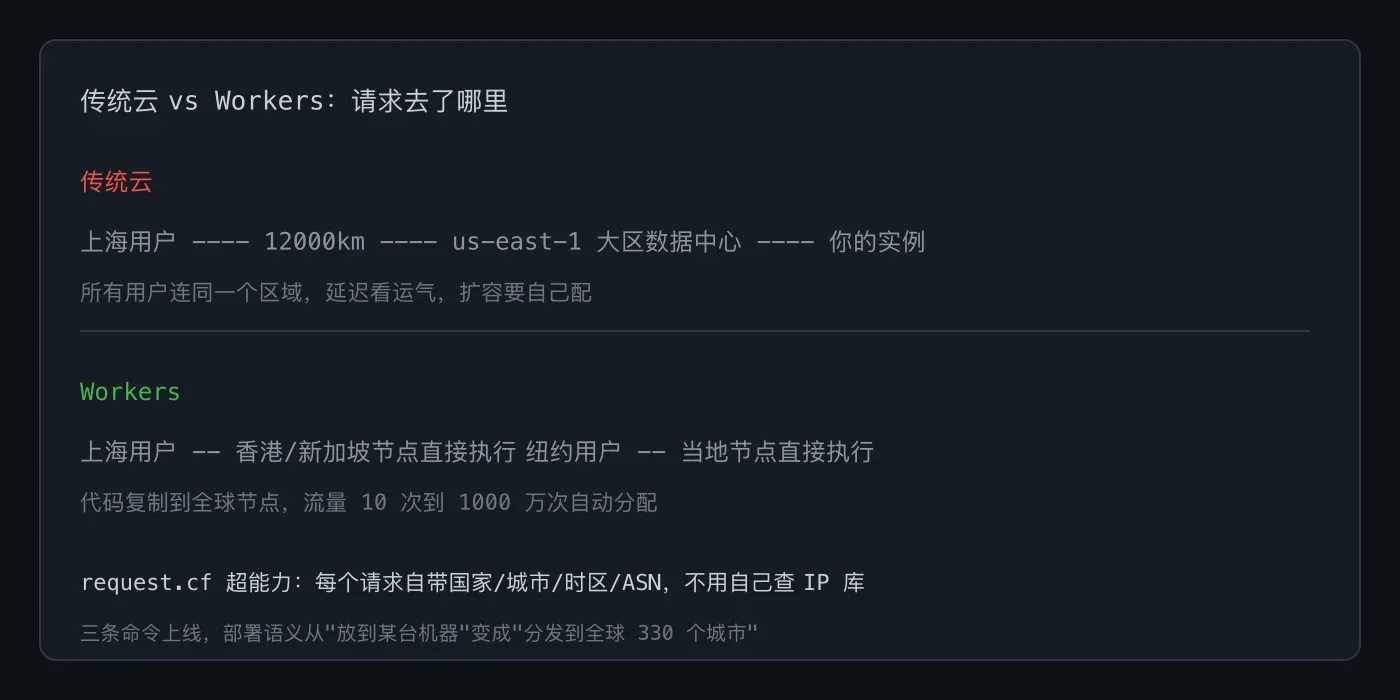
传统云:用户 → 大区数据中心(us-east-1)→ 你的实例
Cloudflare:用户 → 最近的城市节点 → 直接执行你的 Worker 代码
这意味着什么?
- 延迟低:上海用户访问,由香港/新加坡节点处理;纽约用户访问,由当地节点处理。
- 无需扩缩容:流量从 10 次涨到 1000 万次,Cloudflare 自动分配,你什么都不用配。
- 冷启动几乎为零:Workers 用的是 V8 isolate(和 Chrome 里跑 JS 的引擎同源),不是 Docker 容器,启动在毫秒级。
免费额度
| 项 | 免费版 |
|---|---|
| 每日请求数 | 10 万次/天(UTC 0 点重置) |
| 每次 CPU 时间 | 10ms |
| 单 Worker 大小 | 1MB(压缩后) |
10 万次/天,对个人项目、小工具、API 中转、Bot 后端,绰绰有余。这个额度永久免费,不是试用期。
一个最小例子
// worker.js:一个会返回访问者位置和时间的 Worker
export default {
  async fetch(request, env, ctx) {
    const city = request.cf?.city ?? "unknown";  // Cloudflare 自动注入地理位置
    return new Response(`Hello from ${city}! Time: ${new Date().toISOString()}`);
  },
};
request.cf 是 Cloudflare 给你的"超能力":每个请求都自带访问者的国家、城市、时区、ASN 等信息,不用你自己查 IP 库。
部署
npm create cloudflare@latest my-worker
cd my-worker
npx wrangler deploy
三条命令,代码上线全球。这就是 Workers 的魅力:你写的不是"部署到某台机器",是"分发到全球 330 个城市"。
⚠️ 注意 CPU 时间的限制:免费版每次请求 10ms CPU 时间(不是墙钟时间,是真正在执行计算的时间)。等数据库 IO、等外部 API 的时间不算。所以一个主要做"转发 + 简单处理"的 Worker,10ms 绰绰有余;但一个做图片处理、加密计算的 Worker,可能会触限。
04 / 第三层:存储(R2 + D1 + KV)
有计算就要有存储。Cloudflare 的存储层有三个主力产品,覆盖不同的数据形态。
R2:对象存储(对标 AWS S3)
R2 是 Cloudflare 版的 S3:存文件、图片、视频、备份。API 完全兼容 S3,意味着所有现成的 S3 SDK、工具(如 aws-cli)改个 endpoint 就能用。
它最香的一点不是存储本身,而是出口流量免费:
| 项 | Cloudflare R2 | AWS S3 |
|---|---|---|
| 存储 | $0.015/GB·月 | $0.023/GB·月 |
| 出口流量 | $0 | $0.09/GB(贵!) |
| 免费额度 | 10GB 存储 + 100 万 A 类操作/月 | 5GB(仅首年) |
"出口流量免费"这件事,对有大量下载流量的场景(图片站、视频站、软件分发、CDN 回源)是革命性的:S3 的出口费是很多公司云账单的大头,R2 直接砍掉这一项。
D1:SQL 数据库(SQLite 的全球分布版)
D1 是 Cloudflare 的关系型数据库,底层是 SQLite,但不是你本地那种单文件 SQLite,而是一个全球分布的读副本 + 单点写入的架构。
简单说:读可以在任何边缘节点就近完成(快),写会路由到主库。对读多写少的应用(内容站、博客、CMS)特别合适。
| 项 | 免费版 |
|---|---|
| 存储 | 5GB |
| 行读取 | 500 万行/天 |
| 行写入 | 10 万行/天 |
D1 的 SQL 语法就是 SQLite,所以你熟悉的一切(JOIN、CTE、窗口函数)都能用。在 Worker 里查询:
const result = await env.DB.prepare(
  "SELECT * FROM posts WHERE published = 1 ORDER BY created_at DESC LIMIT 10"
).all();
KV:键值存储
KV 是最简单的存储:一个 key 对一个 value,全球分布,读取极快(平均几十毫秒)。
| 项 | 免费版 |
|---|---|
| 存储 | 1GB |
| 读取 | 10 万次/天 |
| 写入 | 10 万次/天 |
KV 适合存读多写少、可最终一致的数据:配置、缓存、特征开关、用户会话。它不适合频繁更新的数据(写延迟高、最终一致)。
💡 三者怎么选:文件/图片/视频 → R2;结构化业务数据 → D1;简单 key-value 缓存 → KV。一个典型全栈应用三个都会用上。
05 / 第四层:托管与函数(Pages + Functions)
Pages:静态站托管
如果你只想托管一个静态网站(博客、文档站、落地页、SPA),Pages 是最省事的选择。
| 项 | 免费版 |
|---|---|
| 项目数 | 100 个 |
| 带宽 | 无限 |
| 请求数 | 无限 |
| 构建次数 | 500 次/月 |
接入方式有两种:
- 连接 Git 仓库:连 GitHub/GitLab,每次 push 自动构建部署
- 直接上传:
wrangler pages deploy ./dist
Pages 的"无限带宽"是另一个反 AWS 的设计:S3 + CloudFront 托管一个静态站,流量大了账单很难看;Pages 是真的零成本。
Pages Functions:给静态站加后端
Pages Functions 让你在静态站里直接写服务端逻辑:本质上就是 Workers,但和 Pages 项目一体化。文件即路由:
functions/
  api/
    users.js    →  /api/users
  projects/
    [id].js     →  /projects/123
放一个 functions/api/hello.js,访问 /api/hello 就能跑这段后端代码。不用单独维护一个 Worker 项目,全栈一站搞定。
06 / 第五层:AI(Workers AI)
这是 Cloudflare 最年轻、也最激进的产品线:把 AI 模型推理搬到边缘节点。
怎么理解
传统 AI 推理:你的请求飞到一个集中式 GPU 集群(OpenAI 的服务器、RunPod、AWS),跑完再飞回来。
Workers AI:模型被加载到 Cloudflare 全球节点的 GPU 上,你的请求由离你最近的 GPU 节点处理。对低延迟场景(聊天、分类、生成)非常合适。
模型库覆盖主流开源模型:Meta Llama 系列、Mistral、Microsoft Phi、Qwen、GLM 等。文本生成、图像生成、语音识别、翻译都有。
免费额度
| 项 | 免费版 |
|---|---|
| 每日推理量 | 10,000 neurons/天 |
| 超出部分 | $0.011 / 1,000 neurons |
"neurons(神经元)"是 Cloudflare 自创的计费单位,用来统一不同模型的成本(大模型消耗的 neurons 多,小模型少)。1 万 neurons 大概能支撑几百到上千次对话。
一个最小例子
// 在 Worker 里调用 GLM 模型
const response = await env.AI.run("@cf/zai-org/glm-5.2", {
  messages: [
    { role: "user", content: "用一句话解释什么是边缘计算" }
  ]
});
或者直接用 REST API:
curl https://api.cloudflare.com/client/v4/accounts/$ACCOUNT_ID/ai/v1/models/@cf/zai-org/glm-5.2 \
  -H "Authorization: Bearer $CF_API_TOKEN" \
-d '{ "messages": [{"role":"user","content":"hi"}] }'这正好一个真实案例是用 Cloudflare Workers AI 免费跑 GLM-5.2,零成本、无日限额、官方授权。和中转商的"来路不明的 3 折 OpenAI"完全是两码事。
07 / 第六层:自动化与高级能力
还有几个产品值得知道,它们把 Cloudflare 从"基础设施"推向"自动化平台"。
Workers Cron / Queues
- Cron Triggers:给 Worker 加定时触发,类似 cron job。这也是 Loop Engineering 里"调度层"的经典实现:一个 Cron Trigger + 一个 Worker,就是一个最小可用的循环。
- Queues:消息队列,生产者-消费者模式。适合异步任务(发邮件、写日志、后台处理)。
Durable Objects
这是 Workers 体系里最"黑科技"的产品:有状态的、单实例的、全球唯一的对象。
普通 Worker 是无状态的(每次请求可能是不同节点处理)。但有些场景必须有状态:实时协作(多人编辑同一个文档)、WebSocket 长连接、限流计数器。Durable Objects 给你一个"全球只有一个实例"的对象,所有请求都会路由到它。
这也是 Cloudflare 强调"边缘有状态"的关键产品:以前实时应用必须搭一台中心服务器,现在可以用 Durable Objects 在边缘完成。
AI Gateway
一个 AI 流量网关:把你对各种 LLM 的调用统一走 Cloudflare 的代理,提供缓存、限流、监控、故障转移。如果你同时用 OpenAI、Anthropic、Workers AI,AI Gateway 让你在一个地方管所有 AI 流量。
Tunnel(cloudflared)
反向隧道:不用公网 IP、不用开端口,把内网的服务安全暴露到互联网。家里有 NAS、本地跑着开发服务器、想临时分享给外地同事看?cloudflared tunnel 一行命令搞定,不用碰路由器端口转发。
cloudflared tunnel --url http://localhost:3000这一行给你一个 *.trycloudflare.com 的临时域名,指向你本机的 3000 端口。本地开发、内网穿透、临时演示的瑞士军刀。
08 / 实战:用免费额度搭一个全栈应用
讲这么多组件,不如拼一个完整的东西。我们用上面所有产品,搭一个**"留言板"**,它覆盖了几乎所有核心组件。
架构:
用户 → Pages(前端 HTML/JS)
         ↓
       Pages Functions(后端 API)
         ↓
D1(存留言)+ R2(存头像图片)+ KV(缓存热门留言)全部跑在免费额度内,每月成本:0 元。
Step 1:创建项目
npm create cloudflare@latest my-guestbook
cd my-guestbook
Step 2:建数据库
npx wrangler d1 create guestbook-db这会输出一段配置,粘到 wrangler.toml:
[[d1_databases]]
binding = "DB"
database_name = "guestbook-db"
database_id = "你的-id"
建表:
npx wrangler d1 execute guestbook-db --command \
  "CREATE TABLE messages (id INTEGER PRIMARY KEY, name TEXT, content TEXT, created_at INTEGER)"
Step 3:写后端 API
functions/api/messages.js:
export async function onRequestGet(request, env) {
  // 先查 KV 缓存
  const cached = await env.CACHE.get("recent_messages");
  if (cached) return new Response(cached, { headers: { "content-type": "application/json" }});

  // 没缓存就查 D1
  const { results } = await env.DB.prepare(
    "SELECT * FROM messages ORDER BY created_at DESC LIMIT 50"
  ).all();

  // 写回 KV,缓存 60 秒
  await env.CACHE.put("recent_messages", JSON.stringify(results), { expirationTtl: 60 });
  return Response.json(results);
}

export async function onRequestPost({ request, env }) {
  const { name, content } = await request.json();
  await env.DB.prepare(
    "INSERT INTO messages (name, content, created_at) VALUES (?, ?, ?)"
  ).bind(name, content, Date.now()).run();

  // 失效缓存
  await env.CACHE.delete("recent_messages");
  return Response.json({ ok: true });
}
Step 4:部署
npx wrangler pages deploy .四步走完,你拥有了一个:全球分布、自动扩缩容、带数据库和缓存的留言板,0 元成本,且不用维护任何服务器。
09 / 边界:什么场景不适合用 Cloudflare
讲了这么多好处,也得说清楚 Cloudflare 的边界。它不是万能的。
不适合的场景:
- 重计算、长 CPU 任务:视频转码、机器学习训练、大数据 ETL:Workers 的 10ms CPU 限制挡住了这类任务。这些还是得回传统云(GPU 实例、K8s)。
- 深度依赖特定云服务的应用:如果你整个架构绑死 AWS(用了一堆 Lambda + DynamoDB + SQS),迁移成本高。
- 对数据驻留有严格合规要求:Cloudflare 数据全球分布,某些行业(金融、医疗)要求数据不能出境,需要单独评估。
- 关系型数据库的复杂场景:D1 是 SQLite 内核,对超大规模、高并发写入、复杂事务的场景,不如 Postgres/MySQL(这方面可以看 Cloudflare 自己的 Hyperdrive。连接外部 Postgres 的加速器)。
最适合的场景:
- 个人项目、独立开发者产品、MVP
- 读多写少的内容站、API、Bot
- 静态站 + 轻量后端
- 对延迟敏感、用户全球分布
- 想零成本验证一个想法
10 / Cloudflare 的真正野心
回到开头那句话:人类对 Cloudflare 的开发程度还不到 5%。
这句话有两层意思。
第一层是字面的:绝大多数用户只用了它的 DNS + CDN,没碰过 Workers、R2、D1、AI、Tunnel。这些产品的免费额度足够撑起一个独立开发者的全部基础设施,但很多人甚至不知道它们存在。
第二层是战略的:Cloudflare 在做的事,本质是用"边缘"重写云计算。
传统云计算(AWS、GCP、Azure)的模型是"中心化大区":你把代码和数据放在几个巨大的数据中心,用户从全球连过来。这套模型统治了过去十五年,但它的瓶颈是延迟和出口费。
Cloudflare 提出的替代方案是"边缘优先":代码和数据下沉到离用户最近的地方,按需在全球分布。而它用免费额度作为获客手段,让开发者在第一天就默认在 Cloudflare 上构建,等业务长大了自然留在生态里。
这个策略很奏效。越来越多的独立开发者、小团队,整个技术栈就是 Cloudflare 一家:DNS、CDN、Workers、R2、D1、Pages、AI,全免费起步,长大了才按量付费。这是对 AWS 模式的正面挑战。
而对中国的开发者,Cloudflare 还有个额外价值:它是少数对中国大陆访问相对友好(虽然偶尔抽风)的海外基础设施。Workers 和 Pages 的节点在香港、新加坡,国内访问延迟可控;DNS 和 CDN 免费版就能用。做面向全球用户的工具、想出海的独立产品,Cloudflare 是绕不开的选项。
11 / 怎么开始:一份行动清单
如果你看完想动手,这是我的建议路径:
第 1 天:感受边缘计算
- 注册 Cloudflare 账号
- 用
npm create cloudflare@latest创建第一个 Worker - 部署一个返回
Hello World的 Worker,感受全球分发
第 2 天:加存储
- 创建一个 D1 数据库,建张表
- 在 Worker 里读写它
- 再创建一个 R2 桶,上传个文件,在 Worker 里读出来
第 3 天:全栈
- 创建一个 Pages 项目,连 Git 仓库
- 加 Pages Functions 写后端 API
- 把 D1、KV 都接上,做一个最小的全栈应用
第 4 天:玩 AI
- 在 Worker 里调用 Workers AI,跑一个 GLM 或 Llama 模型
- 用免费额度的 1 万 neurons 跑通一个聊天接口
第 5 天:自动化
- 给 Worker 加一个 Cron Trigger,每天定时跑一次
- 装一个 cloudflared,体验内网穿透
- 用 AI Gateway 代理你对其他 LLM 的调用
五天走完,你对 Cloudflare 的开发程度,就超过 95% 的人了。
写在最后
Cloudflare 不是一家"CDN 公司",它是一家用边缘计算重新定义云计算的公司。而它的免费额度,本质上是给所有开发者发了一张"零成本创业"的入场券。
DNS、CDN、计算、存储、数据库、AI、自动化,你能想到的基础设施它都有,而且免费起步。唯一的限制是你愿不愿意花几天时间,把这些组件摸熟。
人类对 Cloudflare 的开发程度还不到 5%。剩下那 95%,等你去开垦。
本文提到的所有免费额度基于 2026 年 6 月 Cloudflare 官方文档,具体限制以官网实时为准。Workers、R2、D1、KV、Pages、Workers AI 等产品的边界和定价可能随版本更新调整。
主要参考来源: