字节笔记本
2026年10月5日 · 约 22 分钟读完
别再逐句提示了:Claude Code 循环工程实战指南
我花了一个月,把一半的开发工作"外包"给了 Claude Code 的循环。这篇文章不讲理论,只讲我真正用过的 4 个案例。
写在前面
如果你用 Claude Code 还停留在"打一句、回一句、再打一句"的阶段,那你可能漏掉了它最强大的能力:循环(Loop)。
Anthropic 官方最近发了一篇文章,叫《Getting started with loops》。它抛出了一个观点,我觉得很准:
不要去"提示(prompt)"智能体,要去"设计循环(loop)"。
什么意思?
提示词是你每回合都在干预;循环是你把工作的某个部分整个交出去。
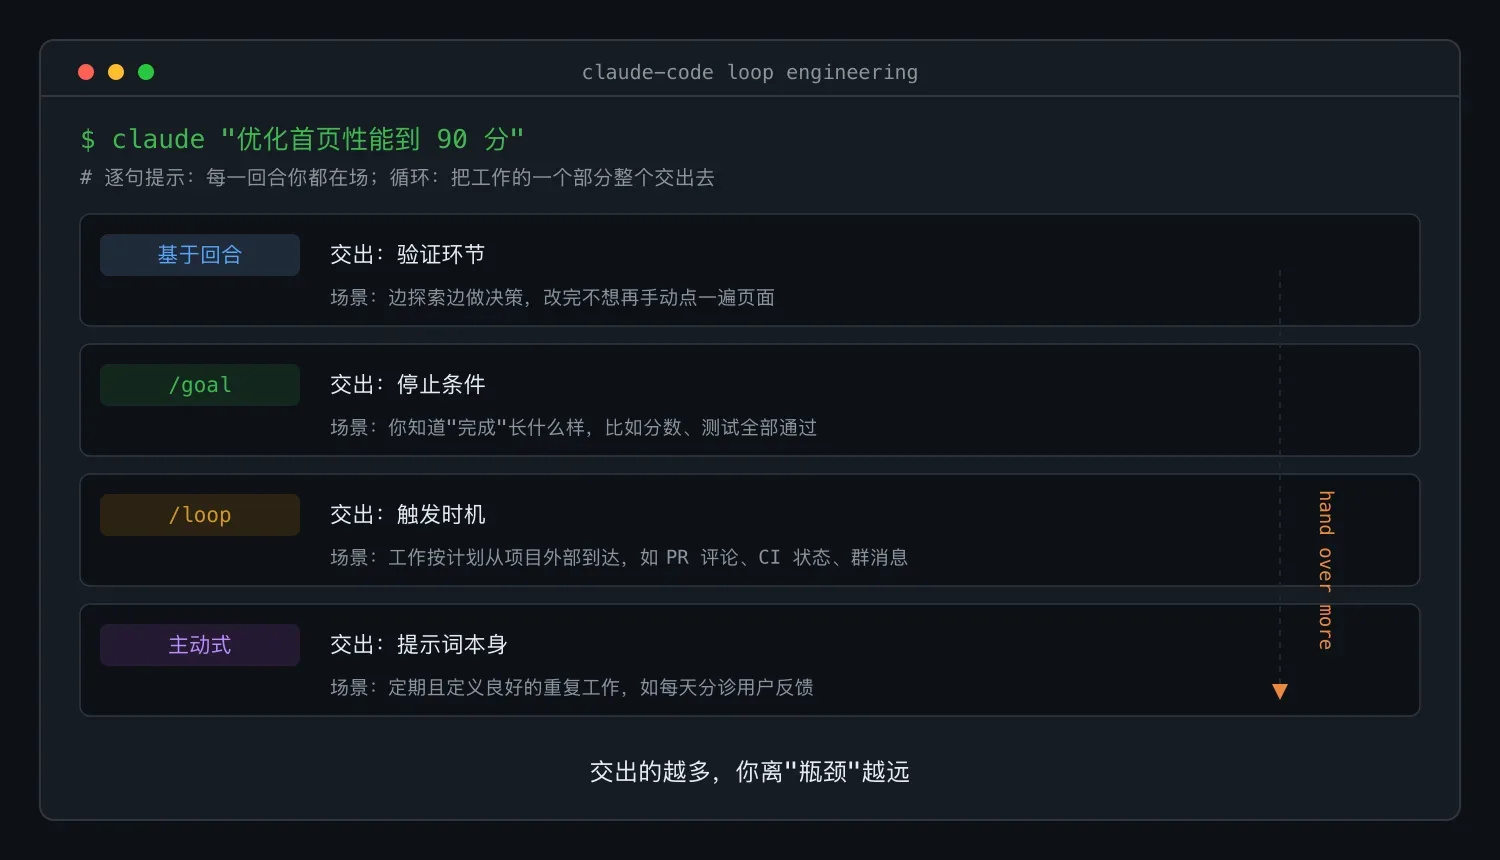
官方把循环分成四类,核心逻辑可以用一张表说清楚:
| 循环类型 | 你交出去的是什么 | 适用场景 |
|---|---|---|
| 基于回合 | 检查环节(验证) | 你在探索、做决策时 |
| 基于目标 | 停止条件 | 你知道"完成"长什么样 |
| 基于时间 | 触发器 | 工作按计划发生在项目外部 |
| 主动式 | 提示词本身 | 定期、定义良好的重复工作 |
这张表看一眼就懂,但真到要用的时候,大多数人会卡在:"这玩意儿到底怎么落地?"
所以这篇文章,我用我自己真实跑过的 4 个案例,把每一类循环掰开揉碎讲给你听。读完你应该能立刻在自己的项目里用起来。
案例一:基于回合的循环,把"验证环节"交给 AI
痛点:你永远是验证的瓶颈
我接了一个私活,给一个本地生鲜电商做官网。某天产品说:商品详情页要加一个"加入购物车"按钮。
听起来很简单,对吧?我把需求丢给 Claude Code:
帮我在商品详情页加一个"加入购物车"按钮,点击后商品数量 +1,购物车图标显示气泡。
Claude 几秒钟就改完了。然后呢?我得自己验证:
- 启动 dev server
- 打开浏览器,进商品页
- 点那个新按钮,看数量变没变
- 看购物车气泡出没出来
- 打开控制台,有没有报错
- 跑一遍单元测试
这一套下来,十分钟没了。而一天里我可能要让它改十几次。真正耗时间的不是写代码,是验证代码。
解法:把验证写进 SKILL.md
Anthropic 的建议是:把你的验证步骤编码成一份 SKILL.md,让 Claude 自己端到端地验证。
我写了一个 verify-frontend-change.md:
---
name: verify-frontend-change
description: 在宣布完成之前,端到端验证任何 UI 变更。
---

# 验证前端变更

永远不要只凭"编辑成功"就报告 UI 变更完成。要像人类审查者那样验证:

1. 启动开发服务器(npm run dev),打开改动涉及的页面。

2. 直接与变更交互。对于新控件(按钮、输入框、开关):
   点击它,确认预期的状态变化,截取交互前后的对比图。

3. 检查浏览器控制台:零新增 error 或 warning。

4. 用 Chrome DevTools MCP 跑一次性能追踪,确认没有明显的回归。

如果任何一步失败,修复后从第 1 步重新运行,
不要返回只验证了一半的工作。
效果
现在我再提需求,Claude 改完代码后,自己会:
- 启动 dev server
- 用浏览器打开商品页
- 点"加入购物车"按钮,截图确认数量从 0 变 1
- 确认购物车图标弹出气泡
- 查控制台无报错
- 全部通过才回来告诉我"完成了"
我从"保姆式验证"里彻底解放了。我交出去的不是写代码,而是"判断代码对不对"这件事。
我踩过的坑:别把 SKILL.md 写成"愿望清单"
第一次我写的 SKILL.md 里有一句"确保用户体验流畅"。结果 Claude 改完按钮直接跟我说"已完成,体验很流畅",它根本没启动浏览器。
模糊词是循环的天敌。 "流畅"不可测量,Claude 只能"声称"它流畅。后来我把每一句都改成可执行的动作:
- 把"确保用户体验流畅"改成"点击按钮后,截图中数字必须从 0 变为 1"
- 把"检查有没有问题"改成"控制台输出中不得出现新增的 error 级别日志"
- 把"性能要好"改成"Chrome DevTools 性能追踪中,LCP < 2.5s"
记住一个原则:SKILL.md 里的每一句话,都应该是一个可以被另一个程序"执行"或"判定真假"的指令。 凡是 Claude 只能"声称"而不能"证明"的,都是漏洞。
关键点:验证越量化,Claude 自我验证就越容易。"检查控制台有没有报错"比"看看有没有问题"有效一百倍。
案例二:基于目标的循环(/goal),把"什么时候停"交给 AI
痛点:Claude 总是"改一下就停"
生鲜电商官网上线后,我用 Lighthouse 测了一下首页性能,分数惨不忍睹:62 分。老板拍桌子:一周内提到 90。
我把任务丢给 Claude:
优化首页性能,把 Lighthouse 分数提上去。
Claude 改了几处,压缩了图片、开了个懒加载,然后跟我说"应该好多了"。
我跑一下:68 分。还差得远。
问题出在哪?Claude 不知道"完成"的标准是什么。 它倾向于"做一点就停",因为它默认觉得"差不多就行"。
解法:/goal 定义明确的退出条件
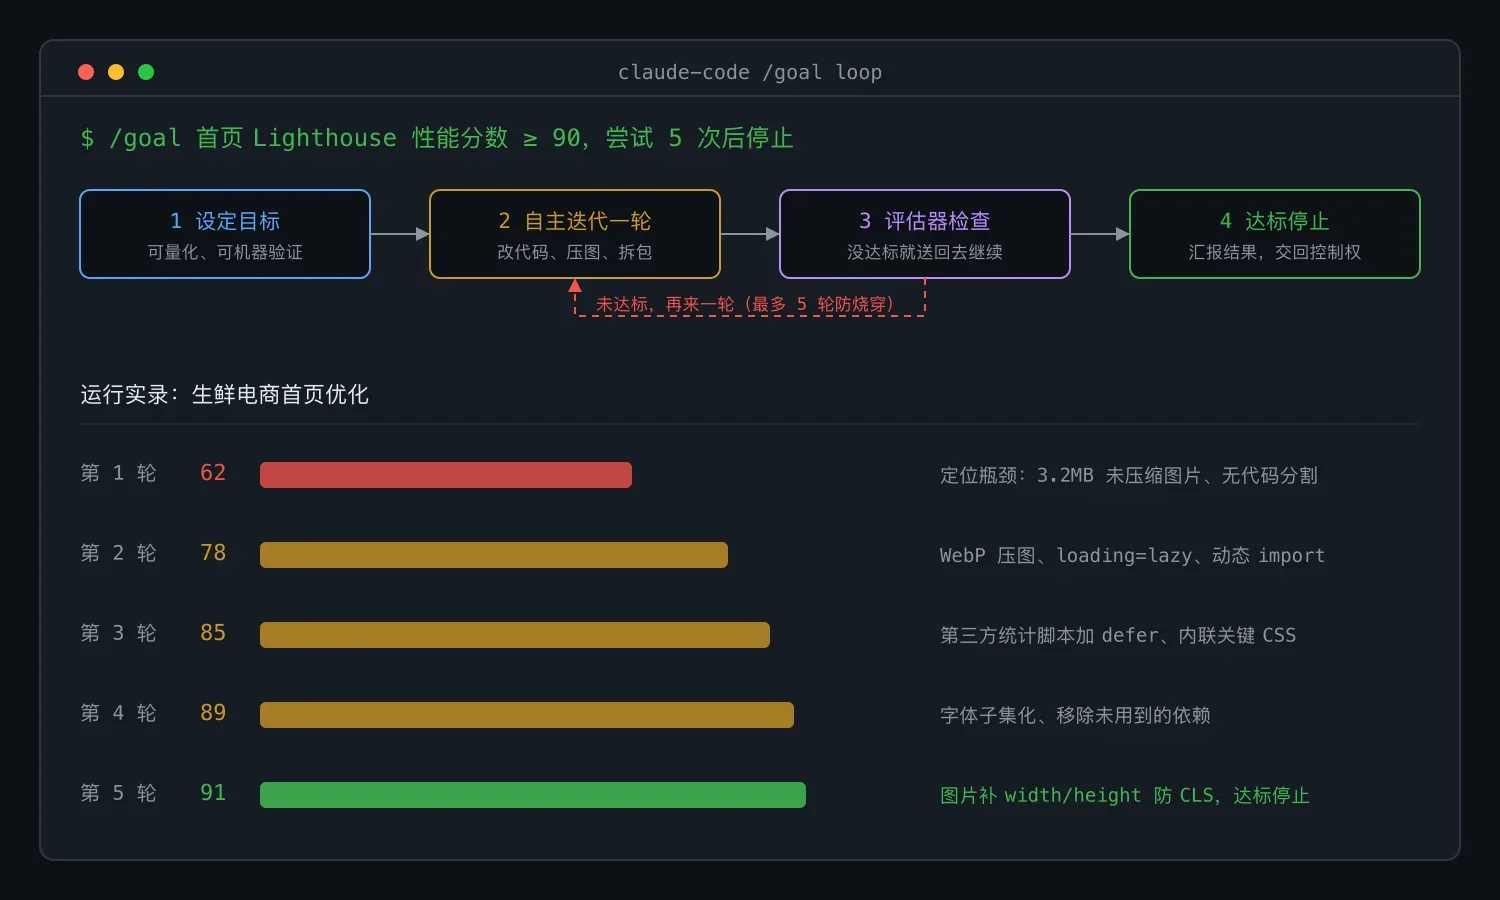
Anthropic 的 /goal 命令专门解决这个。我把提示词改成:
/goal 将首页 Lighthouse 性能分数提升到 90 或以上,
尝试 5 次后停止。
这一句话干了两件事:
- 明确了成功标准:分数 ≥ 90,这是可量化的、可机器验证的
- 明确了回合上限:最多 5 轮,防止它无限烧 token
Claude 是怎么跑的
接下来发生的事让我大开眼界。Claude 进入了自我迭代循环:
- 第 1 轮:分析性能瓶颈:发现首屏加载了 3.2MB 的未压缩图片,JS bundle 没有做代码分割。
- 第 2 轮:把商品图转成 WebP、加
loading="lazy"、对路由做动态 import。分数跳到 78。 - 第 3 轮:发现一个第三方统计脚本阻塞渲染,加了
defer;又内联了关键 CSS。分数 85。 - 第 4 轮:把字体子集化、移除未用到的依赖。分数 89,还差一点。
- 第 5 轮:给图片加合适的
width/height防止 CLS 偏移。分数 91,达标。
整个过程,我一次都没插手。
我差点翻车的一次
第二天我故技重施,想让首页"可用性(Accessibility)分数也上 90"。我打了:
/goal 把首页 Accessibility 分数提到 90 以上,尝试 5 次后停止。
结果 Claude 跑了 5 轮,分数卡在 72。它反复加 aria-label、改颜色对比度,但有个根本问题:商品图全是运营上传的图,没有 alt 文本,而这是无障碍分数的大头。Claude 改不了图,只能动代码,自然上不去。
这次失败的教训是:/goal 解决不了"瓶颈不在代码里"的问题。 在启动目标循环前,先花两分钟想想:这个目标,Claude 真的有能力达成吗?还是说卡点在它够不着的地方(数据库、第三方图、人工内容)?
后来我把任务拆成两步:先让我用脚本批量给历史图片补 alt,再用 /goal 做代码层面的无障碍优化,这一次一轮就过了 90。
为什么这个案例特别重要
它揭示了一个反直觉的真相:确定性标准(如"分数超过 90""测试全部通过""覆盖率 ≥ 80%")是循环最理想的燃料。
因为每次 Claude 想停下时,一个评估器模型会检查你的条件,没达标?送回去继续干。Claude 不需要自己猜"什么叫够好",你用数字告诉它了。
反面教材:如果你的目标是"把这个页面做得更好看一点",循环就跑不起来,因为"好看"不可验证。先把模糊目标翻译成可量化指标,是循环工程的第一课。
案例三:基于时间的循环(/loop 和 /schedule),把"什么时候触发"交给 AI
痛点:外部世界不按你的节奏来
前面两个案例,都是"你主动喊一声,AI 才动"。但现实里很多工作是定期的或依赖外部系统的。
我的生鲜电商接入了微信支付和顺丰物流。某天我提了个 PR,合并不久 CI 就挂了,一个依赖版本冲突。同时 reviewer 留了 3 条意见。但我那会儿正在开会,整整两小时没人理这个 PR。
这种"工作按时发生,但我没空"的场景,就是时间循环的主场。
解法 A:/loop 本地定时巡逻
我在本地跑了:
/loop 5m 检查我的 PR:
- 如果有新的 review 意见,逐条处理
- 如果 CI 失败了,定位原因并修复
- 修复后重新推送,直到 CI 通过
Claude Code 每 5 分钟醒一次,去 GitHub 看一眼。reviewer 留意见了?它读、改、推。CI 红了?它查日志、修依赖、再推。
我从"开会间隙偷偷刷手机看 PR"变成了"开完会发现 PR 已经绿了、意见都回了"。
真实对话:它怎么处理一条 review 意见
我截了一段 /loop 跑起来后的日志给你看,直观感受一下它的"思考":
[巡逻 #3] 检测到 PR #128 有 1 条新意见。 reviewer:"这里的
useEffect缺少 cleanup,组件卸载后会内存泄漏。"[Claude 行动] 读取
ProductDetail.tsx,定位到第 47 行的useEffect。 发现订阅了一个 WebSocket 但没在返回函数里关闭它。 添加 cleanup:return () => ws.close()。 运行npm test,18 passed。 推送 commit "fix: add useEffect cleanup to prevent memory leak"。 回复 reviewer:"已修复,请重新查看 47-52 行。"
你看,它不只是"改代码",它还懂得在 PR 里礼貌地回复 reviewer。这种端到端的处理,手动操作至少要切 4 次上下文。
/loop 的一个特点要记住:它跑在你电脑上,你关机它就停了。 适合白天工作时段。
解法 B:/schedule 把循环搬到云端
但有些工作是 24 小时的,比如生鲜电商的客服群,半夜也有用户反馈订单问题。我需要"关机也在跑"的循环。
这时候用 /schedule:
/schedule 每天 09:00:
总结昨天客服群里的所有订单异常,
按"已解决 / 待跟进 / 需人工"分类,
生成一份简报发到我的晨会频道。
它会在云端按时触发,即使我的 Mac 是关着的。
两种命令的分工
| 命令 | 跑在哪 | 适合 |
|---|---|---|
/loop | 你的电脑 | 白天工作时段、临时巡逻 |
/schedule | 云端 | 24 小时例程、不受关机影响 |
省 token 心法:别让循环跑得太勤。如果你的 PR 一天才更新 5 次,没必要每分钟巡逻一次,5 分钟甚至 10 分钟足够。把间隔匹配到对象的变化频率上。
案例四:主动式循环,把"整个工作流"交给 AI
痛点:有的工作,连"提示词"你都不想写
生鲜电商做大了,每天涌入大量用户反馈:商品图加载慢、支付失败、配送超时、App 闪退……以前我是这么处理的:
- 客服在群里找我
- 我手动判断是 Bug 还是误报
- 是 Bug 的话开 issue、分诊、排期
- 排到我了,我再修
整条链路,我全是瓶颈。 而且这种工作是"定期且定义良好的",每天都来,流程都一样。这正是主动式循环的主场。
解法:把四种原语组合成一条流水线
Anthropic 说,主动式循环可以把前面所有原语拼起来。我设计了一条自动处理用户反馈的流水线:
/schedule 每小时:检查用户反馈群里的新报告。

/goal 在本次运行中发现的所有报告,
必须完成"分诊 + 处理 + 回复"三步才能停止。

处理 Bug 时,用动态工作流在并行的工作树里
探索 3 种解决方案,再让一个裁判 agent 做对抗性审查,
选出最优方案合入。

开启自动模式,无需暂停请求我许可。
这条命令里藏着四个原语的协作:
/schedule(触发器):每小时自动醒来,不用我喊。/goal(停止条件):定义了"分诊+处理+回复"三步全完成才算结束,防止 Claude 草草了事。- 动态工作流(编排):对于真正的 Bug,它并行开 3 个工作树,让 3 个子 agent 各试一种修法。
- 自动模式(无人值守):整条链路不需要点"同意"就能跑完。
它实际跑起来是什么样
假设群里来了 4 条反馈:
- "商品图加载慢":Claude 分诊为性能问题,用
/goal驱动自己优化图片加载,跑通后自动回复用户"已修复,请刷新试试"。 - "iPhone 上点付款没反应":分诊为 Bug,启动动态工作流:3 个子 agent 分别尝试"加 touchend 事件""修 z-index 遮挡""换支付 SDK 版本",裁判 agent 审查后选了第二个方案合入。
- "能不能加个收藏功能":分诊为功能建议(非 Bug),记进需求池,回复用户"已记录,感谢建议"。
- "你们配送真慢":分诊为运营问题,转给物流同学,不触发代码改动。
全程我没碰键盘。 我从"反馈链路的瓶颈"变成了"早上一杯咖啡看一眼 Claude 给我的处理报告"。
动态工作流的"3 个 agent 投票"为什么有效
案例四里"3 个子 agent 各试一种修法 + 1 个裁判审查"的设计,是我反复验证后觉得最稳的配置。为什么是 3 个而不是 1 个?
我专门对比过。同一个支付 Bug,三种方案跑下来:
| 方案 | 子 agent 1 | 子 agent 2 | 子 agent 3 |
|---|---|---|---|
| 思路 | 给按钮加 touchend 事件 | 修被弹窗遮挡的 z-index | 降级支付 SDK 版本 |
| 能修复吗 | 偶发有效 | 彻底修复(根因) | 能修复,但引入新警告 |
如果只跑 1 个 agent,它有 1/3 概率选到第一种"偶发有效"的烂方案,然后这个 Bug 就会像幽灵一样时有时无。而 3 个方案并排摆在裁判 agent 面前时,裁判能一眼看出方案 2 是根因修复、方案 1 只是治标。
并行的价值不在于"快",而在于"提供对比"。 单个 agent 容易陷入"我第一个想到的办法就是最好的"这种思维定势,而多个独立 agent 的方案差异,反而暴露了问题的本质。裁判 agent 的对抗性审查,就是利用这种差异做决策。
代价是 token 用量大约是单 agent 的 3.5 倍。所以我的原则是:只有"会复现的真实 Bug"才上动态工作流,一次性小改动绝不启用。
这个案例最狠的地方
注意那条命令里有个细节:"让一个裁判 agent 做对抗性审查"。
这是 Anthropic 反复强调的一条质量原则:用第二个智能体做 code review。
为什么?因为主 agent 干活时会有"沉没成本偏见",它倾向于觉得自己改的对。而一个带着新鲜上下文的审查 agent没有这个包袱,它只看代码本身。你可以用 Claude Code 内置的 /code-review 技能,或 GitHub 版的 Code Review。
进阶心法:别止步于修单个问题。当某个结果不符合标准时,把它编码进系统,比如把"裁判 agent 审查"固化进 SKILL.md,让所有未来迭代都受益。这是从"打地鼠"到"系统化改进"的关键一跃。
两条不能忽略的纪律:代码质量与 Token 用量
跑循环很爽,但有两件事不做好,循环会变成"烧钱机器"和"代码垃圾场"。
一、保持代码质量(循环输出的质量,取决于它周围的系统)
Anthropic 给了四条建议,我用大白话翻译:
-
代码库本身要整洁。 Claude 是"近朱者赤"的,它会模仿代码库里已有的模式。你的代码乱七八糟,它生成的也乱七八糟。
-
给 Claude 验证自己的手段。 这就是案例一里 SKILL.md 的作用。把"我和团队认为什么是好的"写成可执行的检查清单。
-
让文档随手可得。 把框架、库的最新文档放进上下文,Claude 就不会用过时的写法。
-
永远用第二个 agent 审查。 新鲜上下文意味着更少偏见。这是案例四里"裁判 agent"的由来。
二、管理 Token 用量(循环没有边界,就是漏水的管子)
-
选对原语和模型。 一个小 bug 修复,别上多 agent 动态工作流,杀鸡用牛刀。某些任务还能用更便宜的小模型跑。
-
定义明确的成功和停止标准。 案例二的"5 次后停止"就是防呆设计。没有上限,Claude 可能为了提升 1 分烧掉你半个月的额度。
-
大规模运行前先试点。 动态工作流一次能生成几百个 agent。先在一个小切片上试,看看烧多少,再放开。
-
确定性工作用脚本,别用推理。 比如填一个 PDF 表单,写个固定脚本让 Claude 调用,比每次让它重新推导怎么填便宜得多。
-
审查用量。 这几个命令是你的仪表盘:
/usage:按技能、子 agent、MCP 分解近期用量/goal(不带参数):显示回合数和 token 用量/workflows:显示每个 agent 的 token 用量,随时能停
落地路线图:你该从哪里开始?
讲了四个案例,最后给你一条可操作的入门路径。
别一上来就搞案例四的完整流水线,那会吓退你。 Anthropic 自己也建议:从最简单的方案开始,有选择地叠加。
第一周:先外包"验证"
挑一个你每天重复做的验证动作(比如"改完前端要手动点一遍"),写成一份 SKILL.md。这是门槛最低、见效最快的一步。你会立刻感受到"我不用再当保姆了"的爽感。
第二周:找一个有明确目标的事,用 /goal
比如"把某个测试覆盖率提到 80%""把某个函数的复杂度降下来""让某个页面 Lighthouse 过 90"。前提是目标可量化、可机器验证。
第三周:把一件定时工作交给 /loop
比如每 10 分钟巡逻一次 PR、每天总结一次群消息。先从本地 /loop 开始,习惯后再考虑云端的 /schedule。
第四周以后:组合成主动式流水线
等你熟悉了前三种,再挑一个"定期、定义良好、你一直是瓶颈"的工作流(比如用户反馈处理、Bug 分诊、依赖升级),把多个原语拼起来。
写在最后
回到开头那张表,你会发现一个递进关系:
提示词:你什么都自己干,AI 只是打字员。 基于回合的循环:你交出"验证"。 基于目标的循环:你交出"停止条件"。 基于时间的循环:你交出"触发"。 主动式循环:你交出"提示词本身"。
每交出去一层,你就离"瓶颈"远一步。
Claude Code 的循环工程,本质上不是教你写更好的提示词,而是教你重新设计你和 AI 的分工。从"你是瓶颈"的任务开始,一步一步把工作交出去。
正如官方文章最后说的:
挑一个你是瓶颈的任务,问问自己:你能写验证检查吗?目标足够清晰吗?工作是否按计划到达?
一旦有了答案,跑起来,观察结果,迭代它。
别怕把工作交给循环,怕的是你永远停在"逐句提示"的那一层。
本文案例基于 Anthropic 官方博客《Getting started with loops》整理扩写,完整文档可查阅 code.claude.com/docs。