字节笔记本
2026年10月5日 · 约 2 分钟读完
两百道题训好扩散模型:盯住关键落子
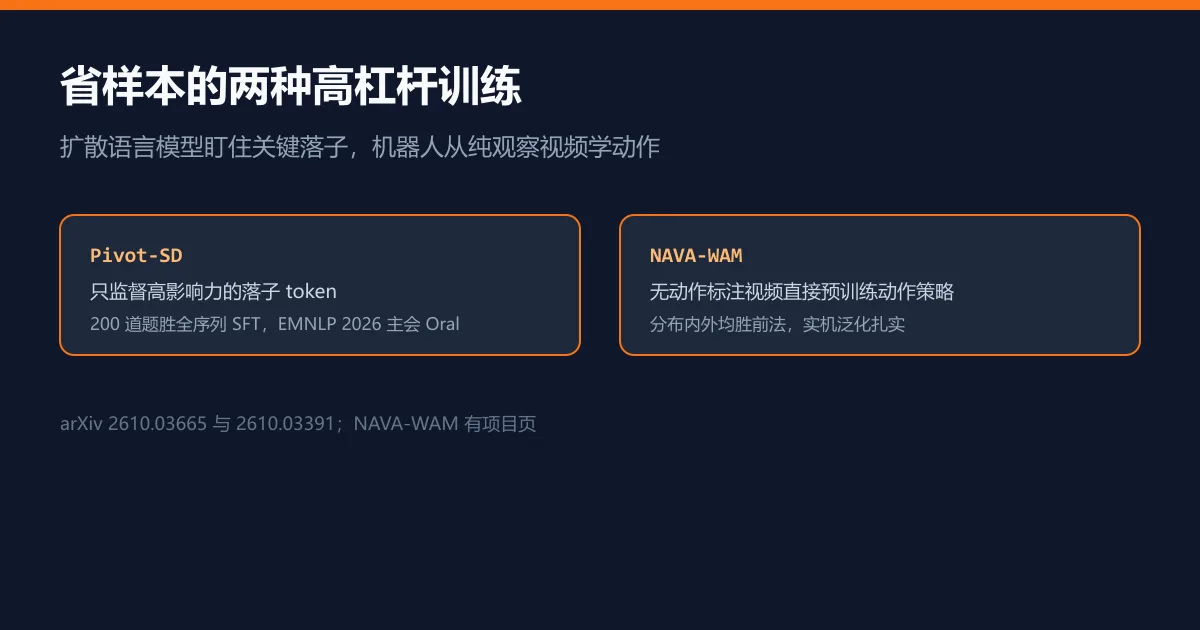
训练一个模型动辄百万样本,但两篇 10 月 2 日提交的新论文都在问:监督能不能花在刀刃上?一篇挑扩散语言模型里的关键 token,一篇让机器人看纯观察视频学动作,都把样本账算出了新境界。
Pivot-SD:只监督关键落子
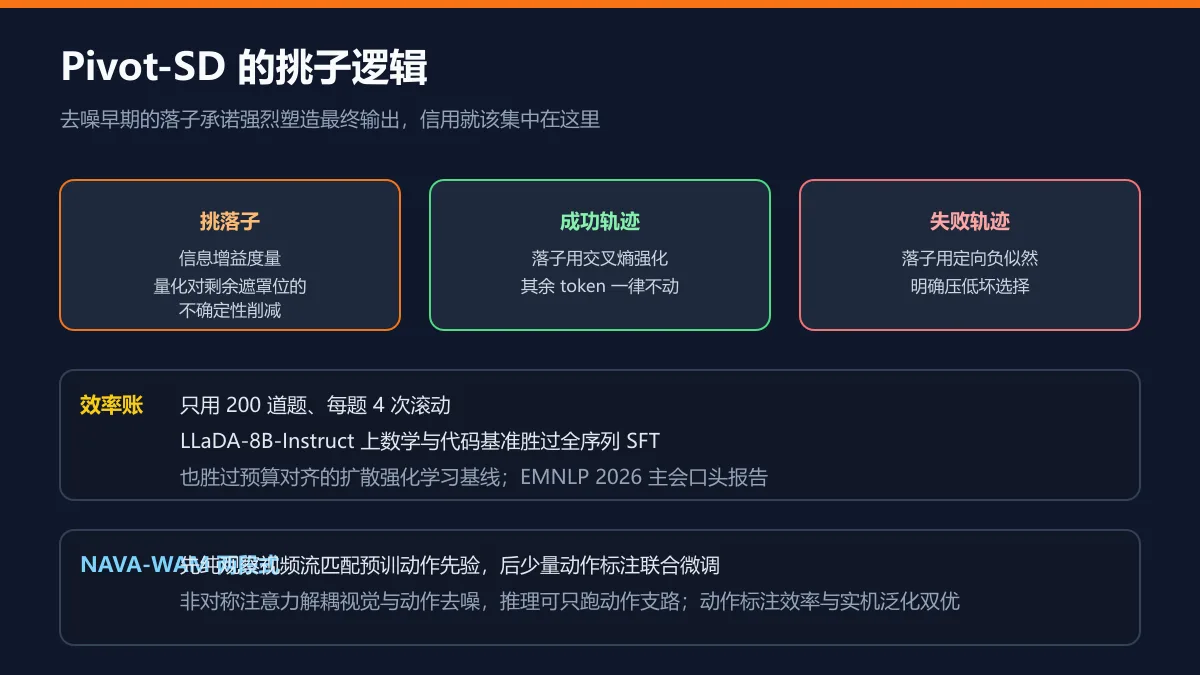
遮罩扩散语言模型去噪时,早期敲定的 token 会强烈塑造最终输出,就像棋局的关键落子。Seo Hyun Kim 等人的 Pivot-SD(arXiv:2610.03665,入选 EMNLP 2026 主会口头报告)把信用分配对准了这些高影响力承诺:用信息增益度量挑选落子 token,量化标准是对剩余遮罩位置的不确定性削减。
训练规则很干净:成功轨迹里的落子用交叉熵强化,失败轨迹里的落子用定向负似然压低,轨迹其余部分一律不碰。效率账令人印象深刻:只用 200 道题、每题 4 次滚动,就在 LLaDA-8B-Instruct 的数学与代码基准上胜过全序列 SFT,也胜过预算对齐的扩散强化学习基线。对做扩散语言模型后训练的团队,这是条立刻可试的路线。页面未见代码链接。
NAVA-WAM:看视频学动作
世界动作模型的规模被动作标注的机器人轨迹卡着脖子,纯观察视频里明明有丰富的交互动态。Zhaochong An 等人的 NAVA-WAM(arXiv:2610.03391)选择直接从观察视频预训练动作策略,不做表征到控制的间接迁移,也不另建隐动作模型。
训练分两段:第一段在纯观察视频上,用未来视频的流匹配监督经过渡结构联合注意力传到 Action-DiT,学出动作相关先验;第二段用少量带动作标注的示范做视频动作联合流匹配微调,非对称注意力把视觉支路与迭代动作去噪解耦,推理时可以只跑动作支路省算力。分布内与分布外实验都稳定胜过此前方法,动作标注效率与真机泛化同样出色。项目页已开放,代码以项目页为准。
放在一起读
一篇把语言侧的监督集中到信息增益最大的落子,一篇把机器人侧的监督来源扩到无标注视频,思路同源:与其堆数据,不如改监督的结构。这与本周信用分配系列(DepGPO、递归自改进)连成一条线,训练效率的竞争正在从算力转向监督设计。