字节笔记本
2026年10月5日 · 约 2 分钟读完
马拉地语里的 32B,只当英语里的 10B 用
模型的泛化能力到底怎么量?10 月初的两篇论文分别给了跨语言与跨物理参数两把新尺子,一把量能力迁移,一把量物理泛化,数字都很有画面感。
Multilingual GSM-Symbolic:同题等价才有可比性
Kenneth Enevoldsen 等 24 位作者的工作(arXiv:2610.03367)先修方法论的坑:以往跨语言评测用的基准不可比且已饱和,结论自然靠不住。他们构建了三万对题目完全等价的问答,覆盖 15 种语言,全部基于符号模板生成,一个样本能变出百万级高质量变体,把过拟合的路堵死。
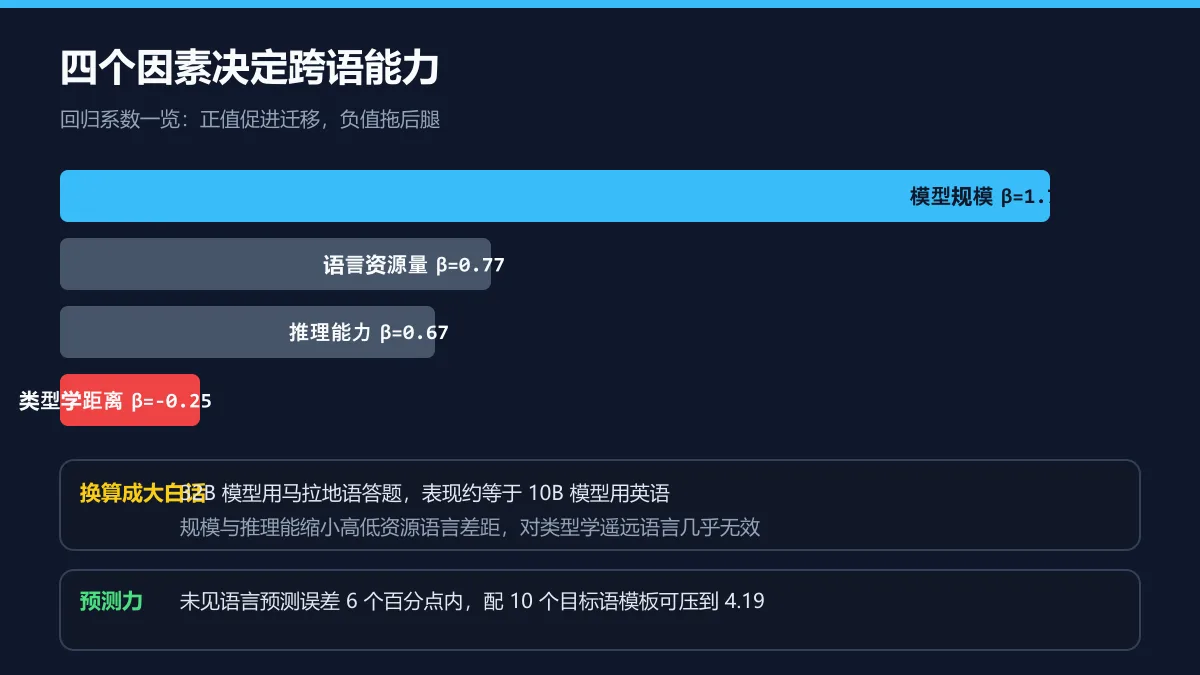
回归分析给出四个决定因素:模型规模系数 1.77 最大,语言资源量 0.77,推理能力 0.67,类型学距离 -0.25 是唯一的负项。换算成大白话:32B 模型用马拉地语答题的表现,约等于 10B 模型用英语。规模与推理能力能缩小高低资源语言间的差距,但对类型学上遥远的语言几乎无效。整个框架解释了 92% 的跨语言差异,对未见语言的预测误差在 6 个百分点以内,只要 10 个目标语言模板就能压到 4.19。做 multinational 产品的团队,这套框架可以直接用来预估小语种上线效果。页面未见代码链接。
PDE-JEPA:预测代替重建
Zhentao Tan 等人的 PDE-JEPA(arXiv:2609.34715)处理参数化偏微分方程的表征学习。主流路线靠重建损失,作者换成预测式:编码器用遮罩潜空间预测训练,几何投影器把潜轨迹对齐物理演化几何,物理结构化的潜预测器把动力学拆成参数无关的演化分量与参数相关的响应分量。
这个拆分带来漂亮的泛化:九个 PDE 基准上平均超越现有方法 33.4%,对未见过的控制参数场景提升 51.4%。对做科学机器学习的团队,这是从重建范式转向预测范式的一份扎实证据。项目页已开放,代码入口见项目页。
放在一起读
一篇证明语言侧的能力迁移可以被四个因素定量预测,一篇证明物理侧的参数泛化可以靠表征结构设计拿到。加上本周的结构密集监督线,泛化这件事正在从玄学变成工程:选对表征、量对因素,迁移就能算出来。