字节笔记本
2026年10月5日 · 约 16 分钟读完
VPS 买完别急着用:TCP 调优一键脚本,把网络性能榨干
VPS 买完别急着用:TCP 调优一键脚本,把网络性能榨干
很多人买了 VPS(虚拟专用服务器)之后,直接就开跑服务了。但你可能不知道:Linux 内核默认的网络参数,是为"通用场景"调的,不是为"服务器高速网络"调的。
默认设置下,你的 VPS 可能只能发挥出六七成的网络性能。尤其是跨境线路、高延迟、大带宽场景,没调优和调优过的速度能差出一倍。
最近有开发者分享了一个 TCP 调优一键脚本,把这套原本属于专业运维的操作做成了菜单式面板。本文就来拆解:它到底改了什么,为什么改了能变快,以及使用前必须注意的安全事项。
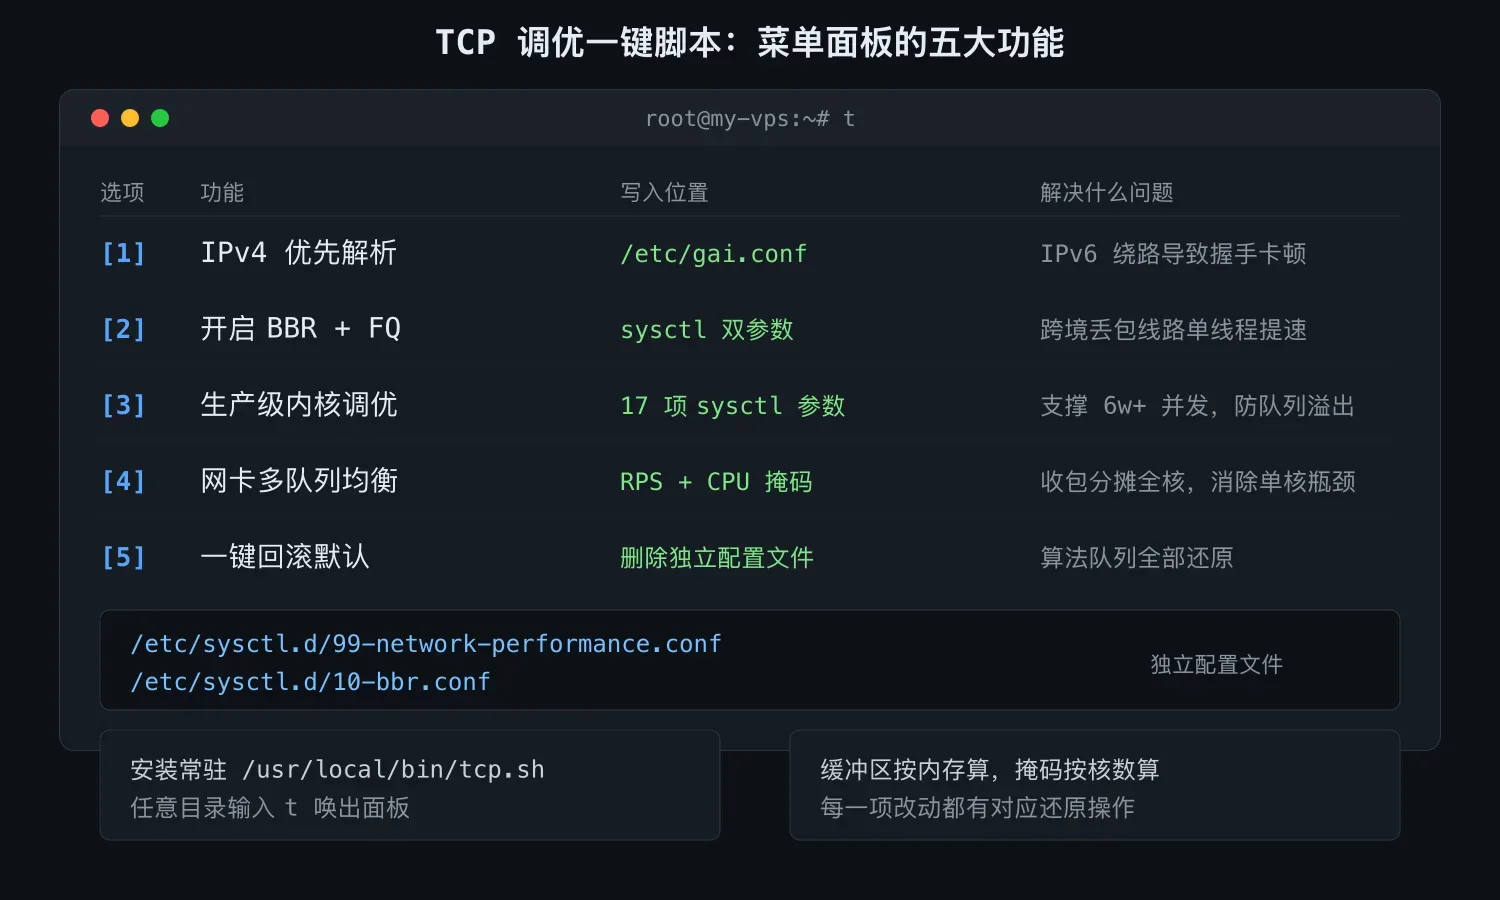
脚本的五个功能模块,覆盖了从 IPv4 优先到网卡多队列均衡的完整调优链路。
一、为什么 VPS 需要调优
先理解问题在哪。Linux 内核的网络栈有几百个可调参数,默认值是"安全但不激进"的:它能保证在各种环境下正常工作,但不会针对你的服务器场景做优化。
几个典型的默认瓶颈:
1. 拥塞控制算法是老的。 Linux 默认用 cubic,这是 2006 年的算法,设计时主要考虑的是数据中心内的低延迟网络。对跨境高延迟、有丢包的线路(很多人 VPS 的实际场景),它不够激进,带宽利用率低。
2. 网络缓冲区太小。 默认的 rmem_max(最大接收缓冲区)只有约 200KB。对高带宽乘高延迟的链路(高 BDP,Bandwidth-Delay Product),这点缓冲根本喂不饱管道,导致单线程速度上不去。
3. 连接队列短。 默认的 somaxconn、tcp_max_syn_backlog 都不大,并发上来容易丢连接。
4. 网卡中断只打在一个 CPU 核上。 多核机器上,网卡收包中断默认绑在单个核,那个核打满就成了瓶颈,其他核闲着。
5. IPv6 可能优先导致绕路。 很多 VPS 同时有 IPv4 和 IPv6,系统默认可能优先走 IPv6,而 IPv6 路由有时反而绕远,导致握手卡顿。
这个脚本,就是针对这五个问题逐一开刀。
二、脚本的五大功能
脚本装好后会创建一个快捷命令 t,在任何地方输入 t 就能打开面板。菜单有 5 个选项:
选项 1:设置 IPv4 优先解析
解决 IPv6 绕路导致的握手卡顿
它修改 /etc/gai.conf,让系统优先解析 IPv4。原理是:很多服务的 IPv6 路由质量不如 IPv4(尤其跨境),优先走 IPv4 能避开绕路,握手更快。
适合你的 VPS 的 IPv6 线路质量不好的情况。
选项 2:开启 BBR + FQ
降低跨境丢包,提升单线程速度
这是最关键的一项。它写入:
net.core.default_qdisc = fq
net.ipv4.tcp_congestion_control = bbr
BBR 是 Google 开发的拥塞控制算法(2016 年),跟传统算法(cubic/Reno)的根本区别在于:它不靠"丢包"判断拥塞,而是靠测量实际带宽和延迟来建模。对跨境高延迟、弱丢包的线路,BBR 能把单线程速度提升几倍。
FQ(Fair Queue)是配合 BBR 的队列调度算法,能让多条 TCP 流公平分享带宽,避免某条流饿死其他流。
BBR + FQ 是目前公认的"跨境线路最佳组合",几乎所有专业 VPS 运维都会开。
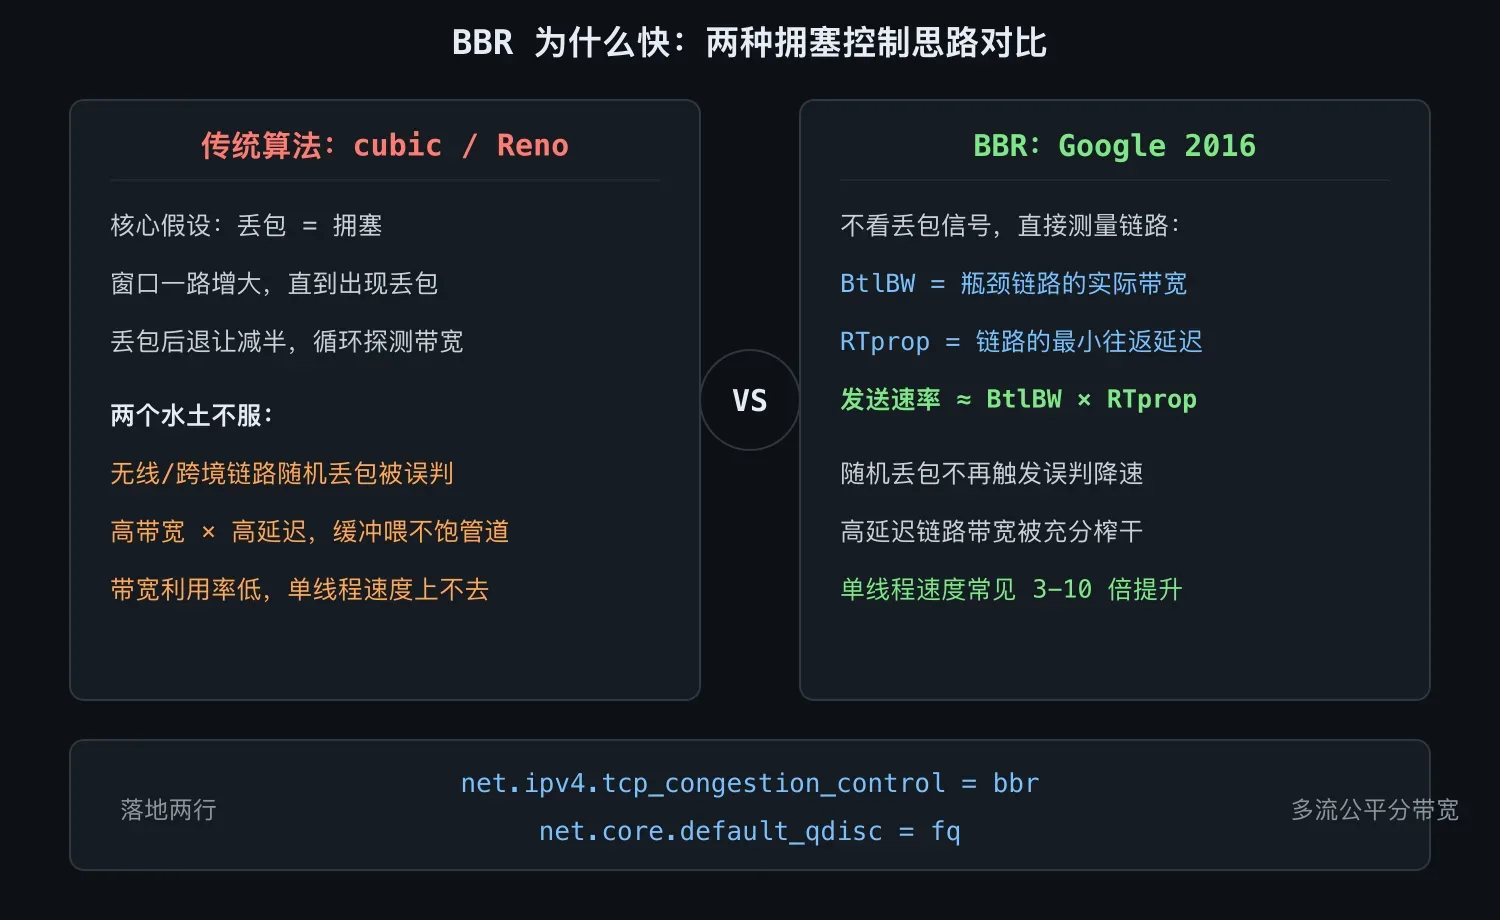
传统算法把丢包当拥塞信号,BBR 直接测量瓶颈带宽与最小往返延迟来计算发送速率。
选项 3:生产级内核调优
支撑 6w+ 并发连接,防止队列溢出
这是脚本的核心。它会根据你的内存大小动态计算缓冲区大小,然后写入一组 sysctl 参数。逐条解释它改了什么:
net.core.somaxconn = 65535              # 监听队列,默认128,太小
net.core.netdev_max_backlog = 65535     # 网卡到内核的包队列
net.ipv4.tcp_max_syn_backlog = 16384    # SYN 队列,防半连接溢出
net.ipv4.ip_local_port_range = 1024 65535  # 可用端口范围拉满
net.core.rmem_max = ${buf_bytes}        # 最大接收缓冲(按内存动态算)
net.core.wmem_max = ${buf_bytes}        # 最大发送缓冲
net.ipv4.tcp_rmem = 4096 87380 ${buf_bytes}  # TCP 接收缓冲三级
net.ipv4.tcp_wmem = 4096 65536 ${buf_bytes}  # TCP 发送缓冲三级
net.ipv4.tcp_notsent_lowat = 16384      # 缓解缓冲膨胀(buffer bloat)
net.ipv4.tcp_mtu_probing = 1            # MTU 探测,防黑洞
net.ipv4.tcp_ecn = 1                    # 显式拥塞通知
net.ipv4.tcp_max_orphans = 32768        # 孤儿连接上限
net.ipv4.tcp_slow_start_after_idle = 0  # 关闭空闲后慢启动
net.ipv4.tcp_tw_reuse = 1               # TIME_WAIT 端口快速复用
net.ipv4.tcp_fin_timeout = 15           # FIN 等待缩短
net.ipv4.tcp_retries2 = 8               # 重传次数
net.ipv4.tcp_fastopen = 3               # TCP Fast Open(客户端+服务端)
几个值得注意的设计:
- 缓冲区按内存动态计算:不是写死一个大数,而是根据你 VPS 的内存算出合理的
buf_bytes,避免内存小的机器被撑爆。这是"智能调优"的体现。 tcp_slow_start_after_idle = 0:默认情况下连接空闲一段时间后会重新慢启动,关掉它能让长连接保持速度。对代理、长连接服务很有用。tcp_fastopen = 3:开启 TFO,允许在握手第一个包就带数据,省一个 RTT。3 表示客户端和服务端都开。tcp_tw_reuse = 1:允许复用 TIME_WAIT 状态的端口。对高频短连接场景能避免端口耗尽。
选项 4:网卡多队列均衡
消除单核 CPU 瓶颈,平摊全核负载
这一步解决"网卡中断只打在一个核"的问题。它会:
- 开启 RPS(Receive Packet Steering),把收包处理分发到多个 CPU 核
- 设置
rps_sock_flow_entries - 根据你有多少核,给每个接收队列分配对应的 CPU 掩码
效果是:网卡的收包负载从"单核扛"变成"全核平摊"。多核 VPS 上,这个优化能让网络吞吐随核数线性扩展,而不是卡在一个核上。
选项 5:一键回退到默认设置
清理所有独立调优配置文件
这一步很重要。任何调优都必须能回滚。脚本的 rollback_tcp_tune 函数会:
- 删除所有写入的独立配置文件(
99-network-performance.conf、10-bbr.conf) - 恢复
/etc/gai.conf的 IPv6/IPv4 优先级 - 把拥塞算法强行恢复为
cubic,队列恢复为pfifo_fast - 清理 RPS 设置
- 删除 MSS 钳制的 iptables 规则
- 清理网卡中断分发设置
改了能改回来,是专业脚本的标志。 那些只管改不管回的脚本,出问题时会让你很被动。
三、脚本做对了什么:三个专业细节
读完整个脚本,它有几个超越"普通一键脚本"的专业之处:
第一,配置文件分离。 它把改动写进 /etc/sysctl.d/ 下的独立文件(99-network-performance.conf、10-bbr.conf),而不是直接改 /etc/sysctl.conf。好处是:回滚时删文件就行,不会污染系统原有配置。这是干净的配置管理习惯。
第二,参数动态计算。 缓冲区大小根据内存算,CPU 掩码根据核数算,不是写死的一套参数硬套所有机器。1G 内存的 VPS 和 16G 内存的 VPS 用同一套参数显然不合理,动态计算解决了这个问题。
第三,完整回滚。 如前文选项 5 所述,每一项改动都有对应的还原操作,卸载脚本时还能顺带回退网络设置。
四、使用前必须注意的安全事项
这类"一键脚本"用起来方便,但有几点必须强调:
1. 你在以 root 身份执行远程脚本
bash <(curl -sL <脚本分发地址>)这条命令的本质是:下载一个脚本并以 root 权限立即执行,你事先看不到内容。这是所有 curl | bash 模式的固有风险。虽然本文拆解的这份脚本完整源码可先行获取审查,但作为一个通用原则:
更安全的做法是先下载再审查:
# 先下载,不执行
curl -sL <脚本分发地址> -o tcp.sh

# 看一眼内容(至少扫一遍有没有可疑的 curl/wget/rm)
less tcp.sh

# 确认没问题再执行
sudo bash tcp.sh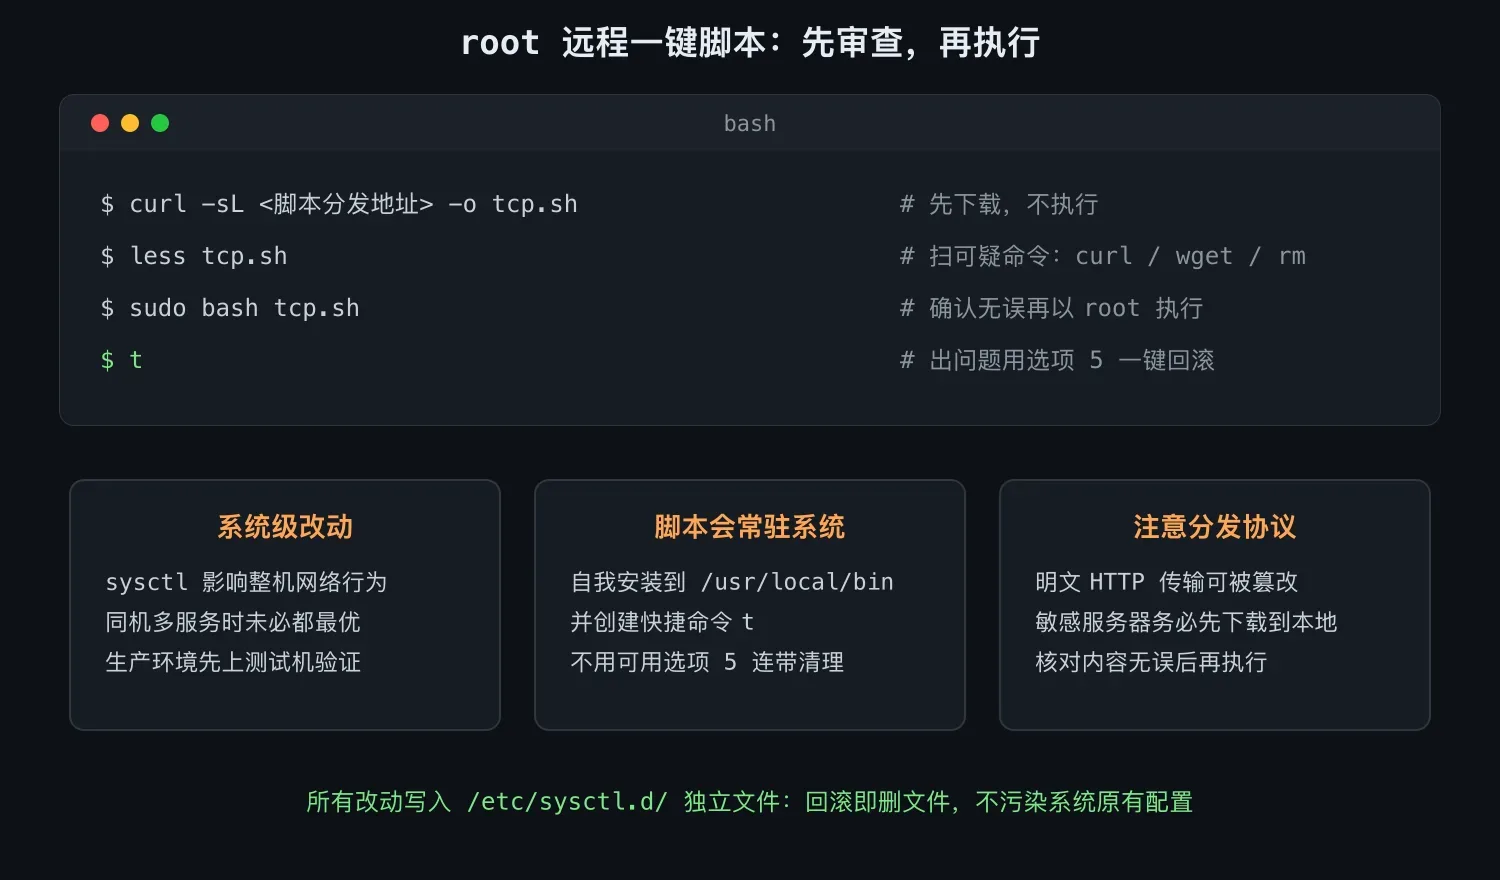
先下载、再审查、后执行;所有改动落在独立配置文件里,随时可以一键回滚。
2. 脚本会自我安装到系统
它会把自己复制到 /usr/local/bin/tcp.sh,并创建快捷命令 t(软链到 /usr/local/bin/t)。这意味着它会常驻系统。不想要了用选项 5 卸载,会连同快捷命令一起清理干净。
3. 改的是系统级网络参数
这些 sysctl 改动影响整个系统的网络行为。如果同一台机器上跑了多个服务(比如数据库、其他对网络延迟敏感的服务),调优参数可能对某些服务不一定最优。生产环境建议先在测试机验证。
4. 注意分发地址是不是明文 HTTP
这套脚本的分发地址是明文 HTTP 而非 HTTPS,理论上传输过程中可被中间人篡改。虽然 CDN 通常会有基础防护,但从严谨角度,敏感服务器上务必先下载到本地核对内容再执行。
五、动手前的判断:你需要调优吗
不是所有 VPS 都需要调。一个简单的判断:
建议调优的场景:
- 跨境线路(美西、日本、欧洲到国内),延迟高、偶有丢包
- VPS 跑代理、中转类服务
- 高并发 Web 服务(连接数大)
- 大流量下载/传输场景
可能不需要的场景:
- 国内机房,低延迟局域网环境
- 只是跑个轻量博客,流量很小
- VPS 内存极小(512MB 以下),大缓冲反而有风险
最简单的判断标准:跑一次 speedtest,如果速度明显低于你购买的带宽,那调优大概率有帮助。
六、调完怎么验证效果
调优后,可以用这几个方法验证:
1. 拥塞算法确认
sysctl net.ipv4.tcp_congestion_control
# 应该显示 bbr
2. 速度测试
# 用 speedtest-cli 或 curl 下载测速
curl -o /dev/null -w "%{speed_download}\n" http://speedtest.tele2.net/100MB.zip
对比调优前后的下载速度。
3. 单线程长连接测试
BBR 对单线程长连接提升最明显,可以用 iperf3 对测。
4. 并发连接压测
# 用 ab 或 wrk 压测 Web 服务,看队列参数是否生效
ab -n 100000 -c 1000 http://localhost/
如果调完速度反而变差,别慌:用选项 5 回滚,回到默认。
七、原理速查:BBR 为什么这么神
既然 BBR 是这套调优的核心,多说两句它的原理。
传统拥塞控制(Reno、Cubic)的逻辑是:"丢包 = 拥塞"。它们靠不断加快速率直到丢包,再退下来,循环往复探测带宽。问题在于:
- 在有随机丢包的链路上(比如无线、跨境),丢包不一定是拥塞,但算法会误判而降速
- 探测带宽靠"撞墙",效率低
- 对高 BDP 链路(高带宽乘高延迟),缓冲区填不满,利用率低
BBR 完全换了个思路:它不靠丢包,而是直接测量瓶颈链路的"实际带宽"和"最小往返延迟",用这两个值算出最优发送速率。结果就是:
- 不怕随机丢包(不靠丢包判断)
- 能把高延迟链路的带宽榨干
- 单线程速度经常提升 3-10 倍
BBR 目前是 Google 内部和 YouTube 的标配,也是几乎所有跨境优化场景的首选。如果你只开一个调优项,就开 BBR。
八、小结
一句话:VPS 默认网络参数是保守的,TCP 调优(尤其是开 BBR)能把跨境和高延迟线路的性能榨干,这个脚本把专业运维操作做成了菜单面板,改完还能一键回滚。
但记住几个原则:
- 先备份/了解回滚方法再改:这个脚本的选项 5 就是干这个的
curl | bash有固有风险:重要服务器先下载审查再执行- 不是所有场景都需要:国内低延迟环境收益有限
- 调完要验证:用 speedtest 和实际业务对比,不行就回滚
网络调优是个深坑,这个脚本帮你踩平了最关键的那几步。但理解它为什么这么改,比会用它更重要:因为换一台不同环境的机器,你可能需要不同的判断。
本文基于公开分享的开源调优脚本整理,拆解其技术原理供学习参考,不对任何第三方脚本的安全性背书。在自己的服务器上以 root 权限执行任何远程脚本前,请务必先下载审查。所有 sysctl 改动以实际系统内核版本支持为准,生产环境建议先在测试机验证。