字节笔记本
2026年10月5日 · 约 2 分钟读完
一秒钟判断水务告警,一步出图看网络深度
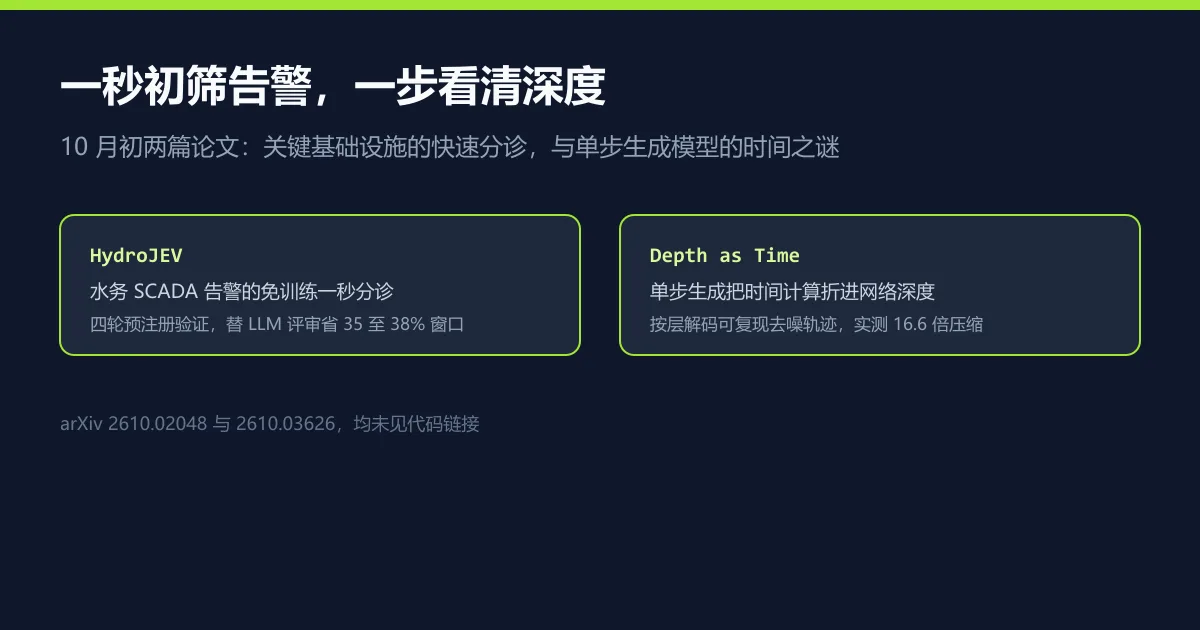
两个看似无关的新工作,都在回答同一个问题:计算量能不能被搬到一个更便宜的地方去?一篇把关键基础设施的告警分诊从 LLM 搬到一秒级免训练模型,一篇把扩散模型摊在采样步上的计算折进网络深度。
HydroJEV:给水务 SCADA 配个秒级分诊台
供水网络的调度员看到告警,要在网络攻击、物理故障、正常暂态、坏传感器四类里快速判断。有监督分类器缺标注,大模型又太慢。Tianwei Mu 等人的 HydroJEV(arXiv:2610.02048)给出一个免训练模型,约一秒返回类别概率,再配一道门控级联:良性判定必须同时被规则树确认,双确认放行,剩下的疑难窗口才交给 LLM 评审。
验证做得相当讲究:四轮密封预注册,宏 F1 约 0.62 至 0.64,胜过手写规则树的 0.56 至 0.61;在未见事件子型上胜过有监督分类器;比前沿 LLM 快 20 至 40 倍;级联为 LLM 评审省下 35 至 38% 的窗口且不掉精度;不做任何改动迁移到另外两个水网,非劣效边界内成立。对运维告警量大的平台,这个三道分级诊的架构直接可以抄。页面未见代码链接。
Depth as Time:单步生成没有丢掉时间
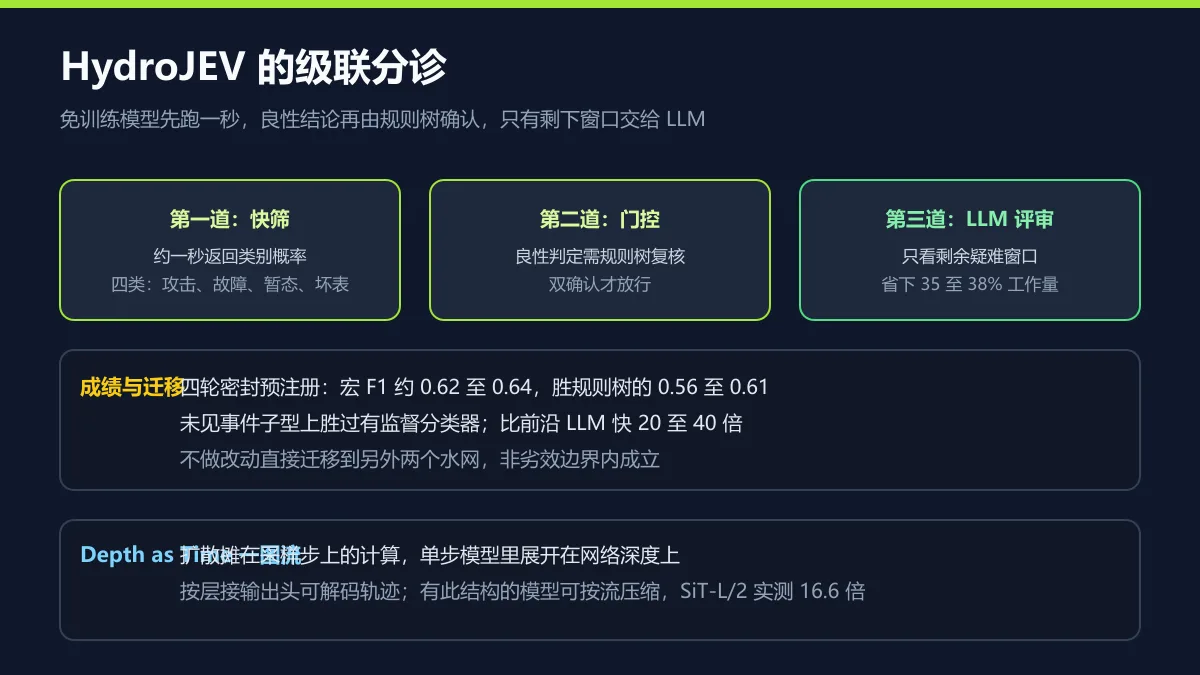
扩散模型蒸馏成单步生成后,原本摊在采样步上的去噪轨迹去哪了?Arnold Caleb Asiimwe 等人的论文(arXiv:2610.03626)给出一个漂亮的实证发现,命名为 depth as time:这些计算没有消失,而是展开在了单次前向传播的网络深度上,用模型自己的输出头逐层解码就能把去噪轨迹复现出来。
这个层内行为取决于训练任务:MeanFlow 模型在单次评估里同时呈现去噪与再加噪;没有时间索引传输任务的模型则没有这种深度方向结构。更有工程味的是可压缩性:把逐层计算显式当作流来处理,MeanFlow SiT-L/2 被压缩 16.6 倍参数塞进单个时间条件块。单步生成不是消除了扩散的时间计算,而是把它重排进了深度。该篇未见代码链接。
放在一起读
一篇用级联把昂贵计算留到最后,一篇把时间计算搬进深度省掉整段采样。算力紧张时期,计算的位置比计算的总量更值得设计,这条工程直觉在两篇论文里各自成立。