字节笔记本
2026年10月5日 · 约 10 分钟读完
WhisperX:语音转文字提速70倍,还能分清说话人
OpenAI 的 Whisper 是目前使用最广的开源语音识别模型之一:识别准确、支持多语言、可以完全在本地运行。但它在工程上一直有三个明显的短板:
- 慢:不原生支持批处理,长音频要等很久
- 时间戳不准:只精确到句子级,误差可能达到数秒
- 不区分说话人:多人对话的内容全部混在一起
开源项目 WhisperX 把这三个问题一并解决了:70 倍实时速度、词级时间戳、说话人分离,本地运行,免费开源。
一、WhisperX 是什么
WhisperX 是 Whisper 的增强版语音识别管线,其论文被语音技术会议 INTERSPEECH 2023 接收,作者团队还在 Ego4D 转录挑战赛中获得第一名。
它做的事可以一句话概括:用 Whisper 的准确率,加上批处理推理的速度、wav2vec2 的词级时间戳和 pyannote 的说话人分离,组成一条完整管线。
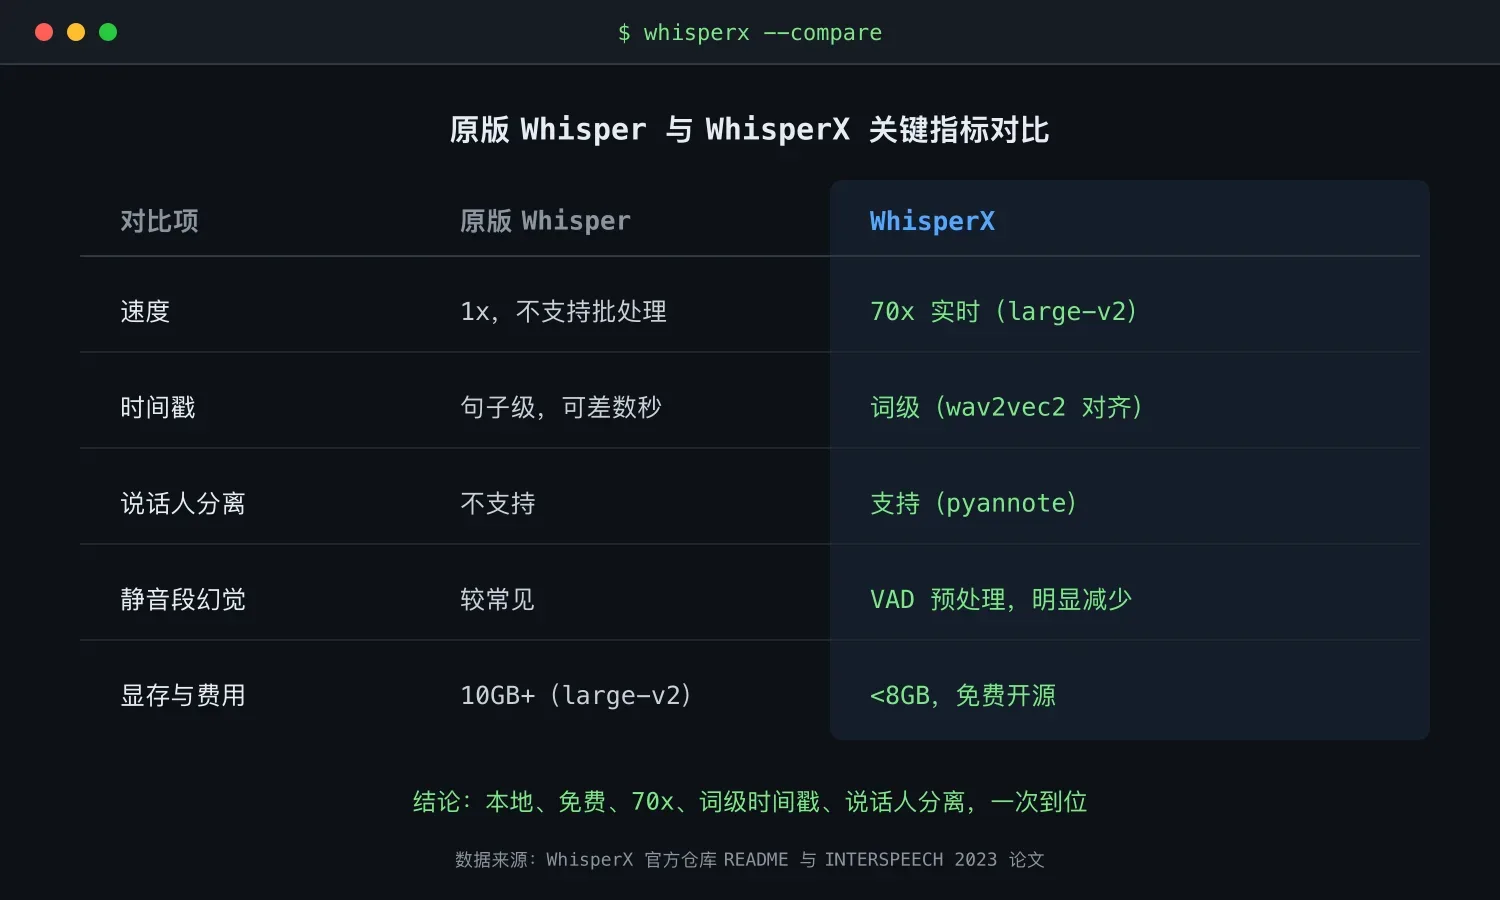
| 能力 | 原版 Whisper | WhisperX |
|---|---|---|
| 速度 | 1x(不批处理) | 70 倍实时(批处理 + faster-whisper 后端) |
| 时间戳精度 | 句子级(可能差几秒) | 词级(wav2vec2 强制对齐) |
| 说话人识别 | 不支持 | 支持(pyannote-audio 分离) |
| 幻觉控制 | 静音段容易幻觉 | VAD 预处理减少幻觉 |
| 显存占用 | 大(large-v2 需 10GB 以上) | 小于 8GB(large-v2、beam_size=5) |
二、四个核心技术
1. 批处理推理:70 倍加速
原版 Whisper 逐段处理音频,一小段一小段串行推理,GPU 大量时间在空转。WhisperX 换用 faster-whisper 后端并引入批处理,把多段音频打包一起推理,GPU 利用率拉满。官方给出的成绩是 large-v2 模型达到 70 倍实时速度:1 小时的音频不到 1 分钟转完。
2. 词级时间戳:wav2vec2 强制对齐
原版 Whisper 的时间戳是句子级的,只告诉你这句话大概在第 10 秒到第 15 秒之间,误差可能有几秒,做字幕同步时经常对不上。WhisperX 的解法是两步走:先用 Whisper 转录文字,再用 wav2vec2 做强制对齐。wav2vec2 是音素级模型,能定位每个词在音频中的具体位置。这样每个词都有精确时间戳,做字幕、剪辑标记、语音搜索都能精确到毫秒级。
3. 说话人分离:pyannote-audio
会议、播客、采访这类多人对话场景,原版 Whisper 会把所有人说的话混在一起,分不清哪句是谁说的。WhisperX 集成 pyannote-audio 做说话人分离,分析音频特征并给每段话标注 SPEAKER_00、SPEAKER_01 等标签,转录结果自动按说话人整理。
4. VAD 预处理:减少幻觉
Whisper 有一个知名缺陷:在静音段容易产生幻觉,明明没有人声也会编造出内容。WhisperX 在转录前先用 VAD(Voice Activity Detection,人声活动检测)扫描音频,只对有人声的段落做识别,静音段直接跳过。按论文的测试结果,幻觉大幅减少,且没有 WER(词错误率)退化。
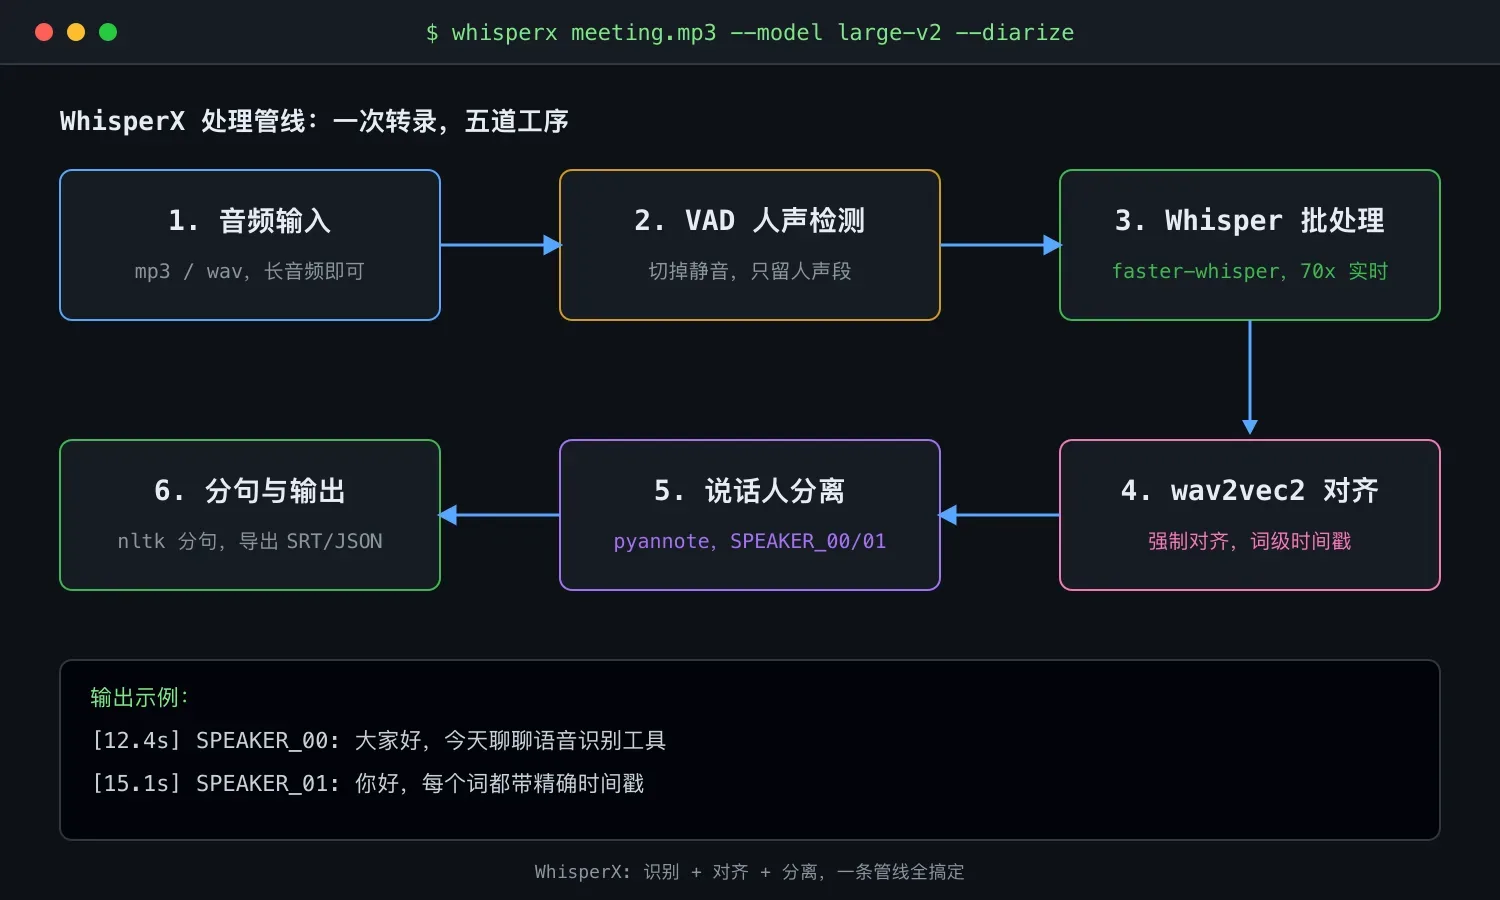
三、完整管线
音频输入
  |
  +-- VAD 预处理(检测人声段,去掉静音)
  |
  +-- Whisper 批处理转录(faster-whisper 后端,70 倍速度)
  |
  +-- wav2vec2 强制对齐(生成词级时间戳)
  |
  +-- pyannote 说话人分离(SPEAKER_00/01/...)
  |
  +-- 句子分段(nltk sent_tokenize,方便做字幕)
       |
       +-- 输出:带词级时间戳与说话人标签的转录文本
四、怎么用
安装
# PyPI 安装
pip install whisperx

# 或用 uvx 免安装直接运行
uvx whisperx
需要 GPU 加速时,先安装 CUDA 12.8 工具包(Linux 与 Windows 均有官方安装指南),只用 CPU 则可跳过这一步。
命令行用法
# 基础转录
whisperx audio.mp3

# 指定模型与批大小
whisperx audio.wav --model large-v2 --batch_size 4

# 开启说话人分离(需 HuggingFace token)
whisperx audio.mp3 --hf_token YOUR_HF_TOKEN --diarize

# 输出 SRT 字幕并高亮词级时间点
whisperx audio.mp3 --output_format srt --highlight_words True
Python API
import whisperx

# 1. 加载模型
model = whisperx.load_model("large-v2", device="cuda")

# 2. 转录(批处理)
audio = whisperx.load_audio("meeting.mp3")
result = model.transcribe(audio, batch_size=16)

# 3. 词级对齐
model_a, metadata = whisperx.load_align_model(
    language_code="en", device="cuda"
)
result = whisperx.align(
    result["segments"], model_a, metadata, audio, device="cuda"
)

# 4. 说话人分离
diarize_model = whisperx.DiarizationPipeline(
    use_auth_token="YOUR_HF_TOKEN", device="cuda"
)
diarize_segments = diarize_model(audio)
result = whisperx.assign_word_speakers(diarize_segments, result)

# 输出每句的说话人与时间
for segment in result["segments"]:
    speaker = segment.get("speaker", "?")
    text = segment["text"]
    start = segment["start"]
    print(f"[{start:.1f}s] {speaker}: {text}")
五、和其他方案怎么比
| 原版 Whisper | WhisperX | faster-whisper | 云端 API | |
|---|---|---|---|---|
| 速度 | 1x | 70 倍 | 约 4 倍 | 快(含上传耗时) |
| 时间戳 | 句子级 | 词级 | 句子级 | 词级 |
| 说话人分离 | 不支持 | 支持 | 不支持 | 支持(付费) |
| 幻觉 | 较严重 | 少 | 较严重 | 少 |
| 部署 | 本地 | 本地 | 本地 | 云端 |
| 费用 | 免费 | 免费 | 免费 | 按量付费 |
WhisperX 的甜蜜点在于同时拿到本地、免费、70 倍速度、词级时间戳和说话人分离:原版太慢太糙,faster-whisper 快但没有对齐与分离,云端 API 功能全但要付费且音频必须上传。对数据敏感、不能出本机的场景,WhisperX 几乎是唯一的全能解。
六、适用场景与注意事项
适合谁:
- 做播客或视频字幕:需要精确时间戳做同步
- 做会议记录:需要区分说话人
- 做语音搜索:需要词级时间戳定位
- 批量处理音频:70 倍速度大幅缩短等待
- 隐私敏感场景:音频不出本机
注意点:
- 想跑得快需要 GPU,最佳是 NVIDIA CUDA;只有 CPU 也能运行,但速度优势会缩水
- 说话人分离需要 HuggingFace token:免费注册后接受 pyannote 模型的使用协议即可
- 显存门槛不高:large-v2 配 beam_size=5 也只要小于 8GB,更小的模型占用更低
- 中文场景:Whisper 本身中文识别不错,但词级对齐依赖对应的 wav2vec2 中文模型,使用前建议先小样本验证
七、小结
WhisperX 的思路值得所有工具开发者参考:不重复造模型,而是把每个环节的最优组件缝合起来。Whisper 负责识别、faster-whisper 负责推理速度、wav2vec2 负责音素对齐、pyannote 负责说话人分离、VAD 负责人声检测,每个组件都是各自领域的成熟方案,组合在一起就是一个远超单模型的完整管线。
如果你要处理语音,做字幕、做会议记录、做播客转录,WhisperX 是目前本地免费方案里的优先选择。慢、糙、混这三个原版痛点,它一次性解决。
参考资料:
- 仓库:https://github.com/m-bain/whisperX
- 论文:https://arxiv.org/abs/2303.00747
- 许可证:BSD-2-Clause