字节笔记本
2026年10月5日 · 约 19 分钟读完
别再给 AI 写提示词了:让系统自己提示自己的循环工程
2026 年 6 月,三个互不通气的人在同一周说了同一句话:"不要再给 AI 写提示词了。"
他们是 Peter Steinberger(OpenClaw 作者,帖子浏览量 800 万)、Boris Cherny(Anthropic Claude Code 负责人)和 Addy Osmani(Google Chrome 工程师)。
然后有人把这件事写成了一篇论文。不是学术象牙塔的理论,而是来自 Anthropic 内部、用真实案例和数据堆出来的工程方法论。
论文叫《Loop Engineering: The Anthropic Playbook for Designing Systems That Prompt Your Agents》。本文就来完整解析它。
一、这篇论文到底在说什么
用一句话概括整篇论文的核心主张:
循环让生成几乎免费,判断力成为唯一的稀缺资源。同样的循环,两个人构建,可以产生截然相反的结果。
这不是"又一个 XX 工程"概念炒作。论文开篇就承认:过去两年,提示词工程、上下文工程、框架工程接连出现,"想翻白眼是可以理解的"。
但这一次不同。 之前的所有术语都假设人坐在键盘前,逐行指挥 Agent。循环工程删除了这个假设:人不再在循环内部,而在循环外部,构建循环。
从"操作 Agent 的人"变成"设计 Agent 的人"。从"做发动机"变成"设计发动机"。
二、四层栈:循环在哪里
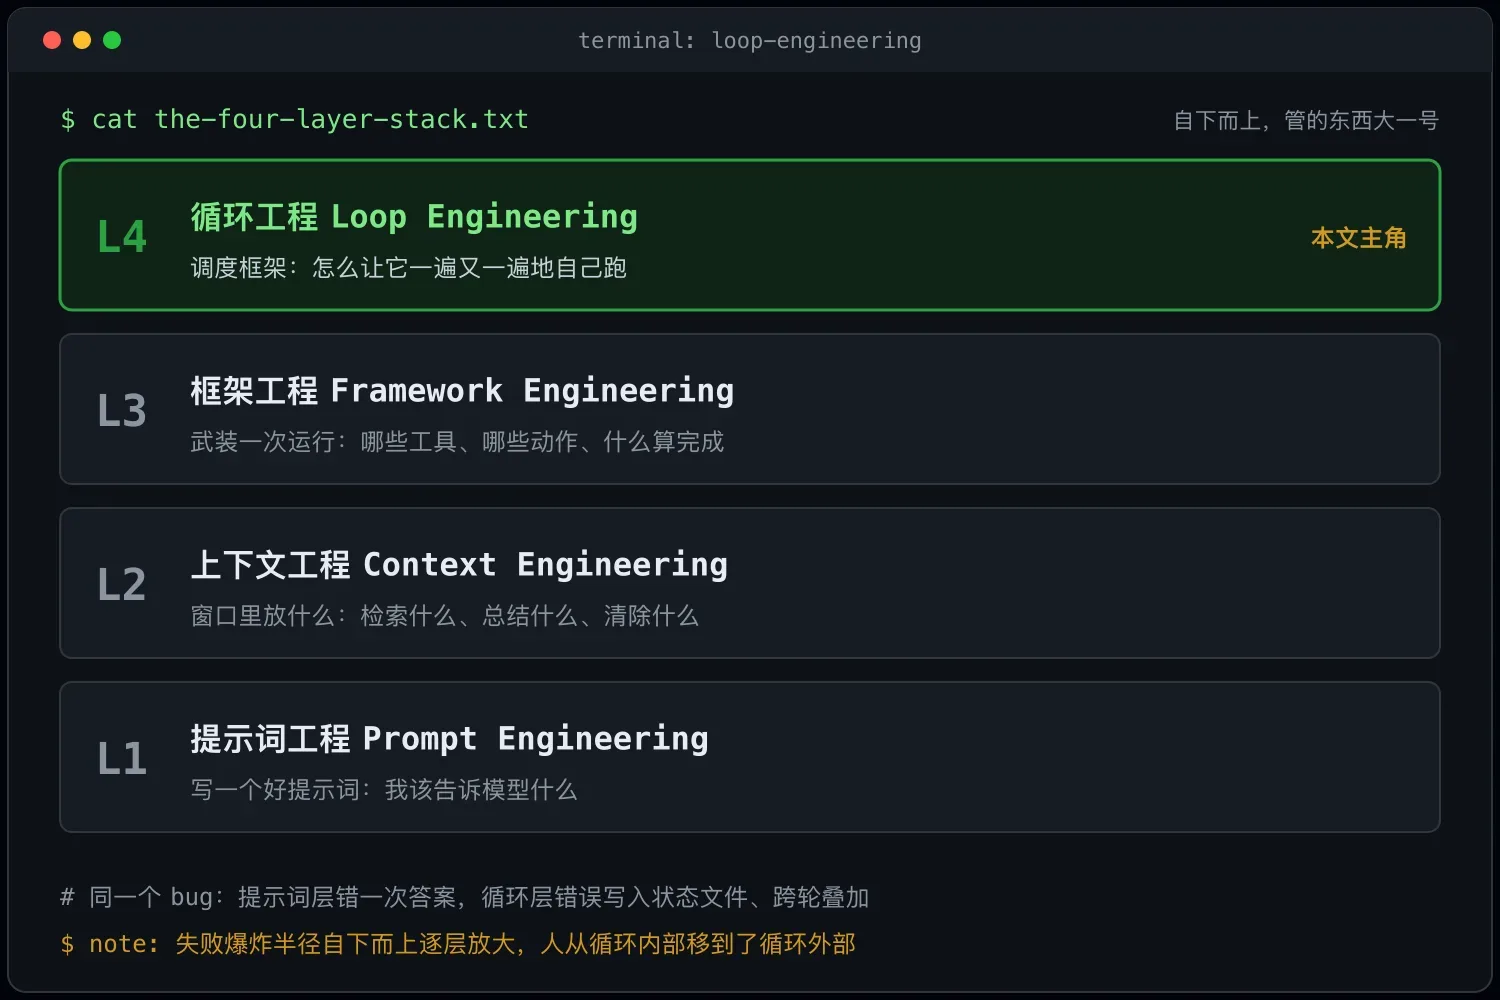
论文把 AI 编程的演进画成一个四层栈:
| 层 | 管理什么 | 核心问题 |
|---|---|---|
| 提示词工程 | 写一个好提示词 | 我该告诉模型什么 |
| 上下文工程 | 窗口里放什么 | 检索什么、总结什么、清除什么 |
| 框架工程 | 武装一次运行 | 哪些工具、哪些动作、什么算完成 |
| 循环工程 | 调度框架 | 怎么让它一遍又一遍地自己跑 |
每一层向上,关注的东西大一号:从一句话,到一个窗口,到一次运行,最后到一个自运行的循环。
关键在于,每层的失败爆炸半径不同。
考虑同一个 bug(Agent 误读函数返回值):
- 提示词层:一次错误答案,人立即看到,改提示词
- 上下文层:答案自信地错了,人清掉过时上下文
- 框架层:Agent 改了文件,但 diff 可见,人发布前审查
- 循环层:误读被写入状态文件,第二天被当作既定事实读回,在多轮中层层叠加。等人发现时,错误已成承重结构
循环工程中最重要的直觉:错误的代价与它在被发现前存活的轮次成正比,而循环按其构造就是一个最大化轮次的机器。
后面所有内容,评估器、检查点、预算上限,都是为了缩短错误与发现之间的距离。
三、循环的五个动作
论文把一轮循环拆成五个动作,丢掉任何一个循环就不转:
调度(Scheduling)
    │ 定时器或触发器启动
    ▼
发现(Discovery)
    │ Agent 自己找值得做的工作
    │ 读 CI / issue / 提交 / 上次状态
    ▼
交接(Handoff)
    │ 每个发现开一个隔离的 git worktree
    │ 多个 Agent 并行互不干扰
    ▼
验证(Verification)
    │ 第二个 Agent 审查第一个的产出
    │ 不同指令,有时是不同模型
    │ 这就是"能说不的东西"
    ▼
持久化(Persistence)
    │ 结果写到磁盘(PR / 状态文件 / 收件箱)
    │ Agent 会遗忘,仓库不会
    ▼
回到调度:下一轮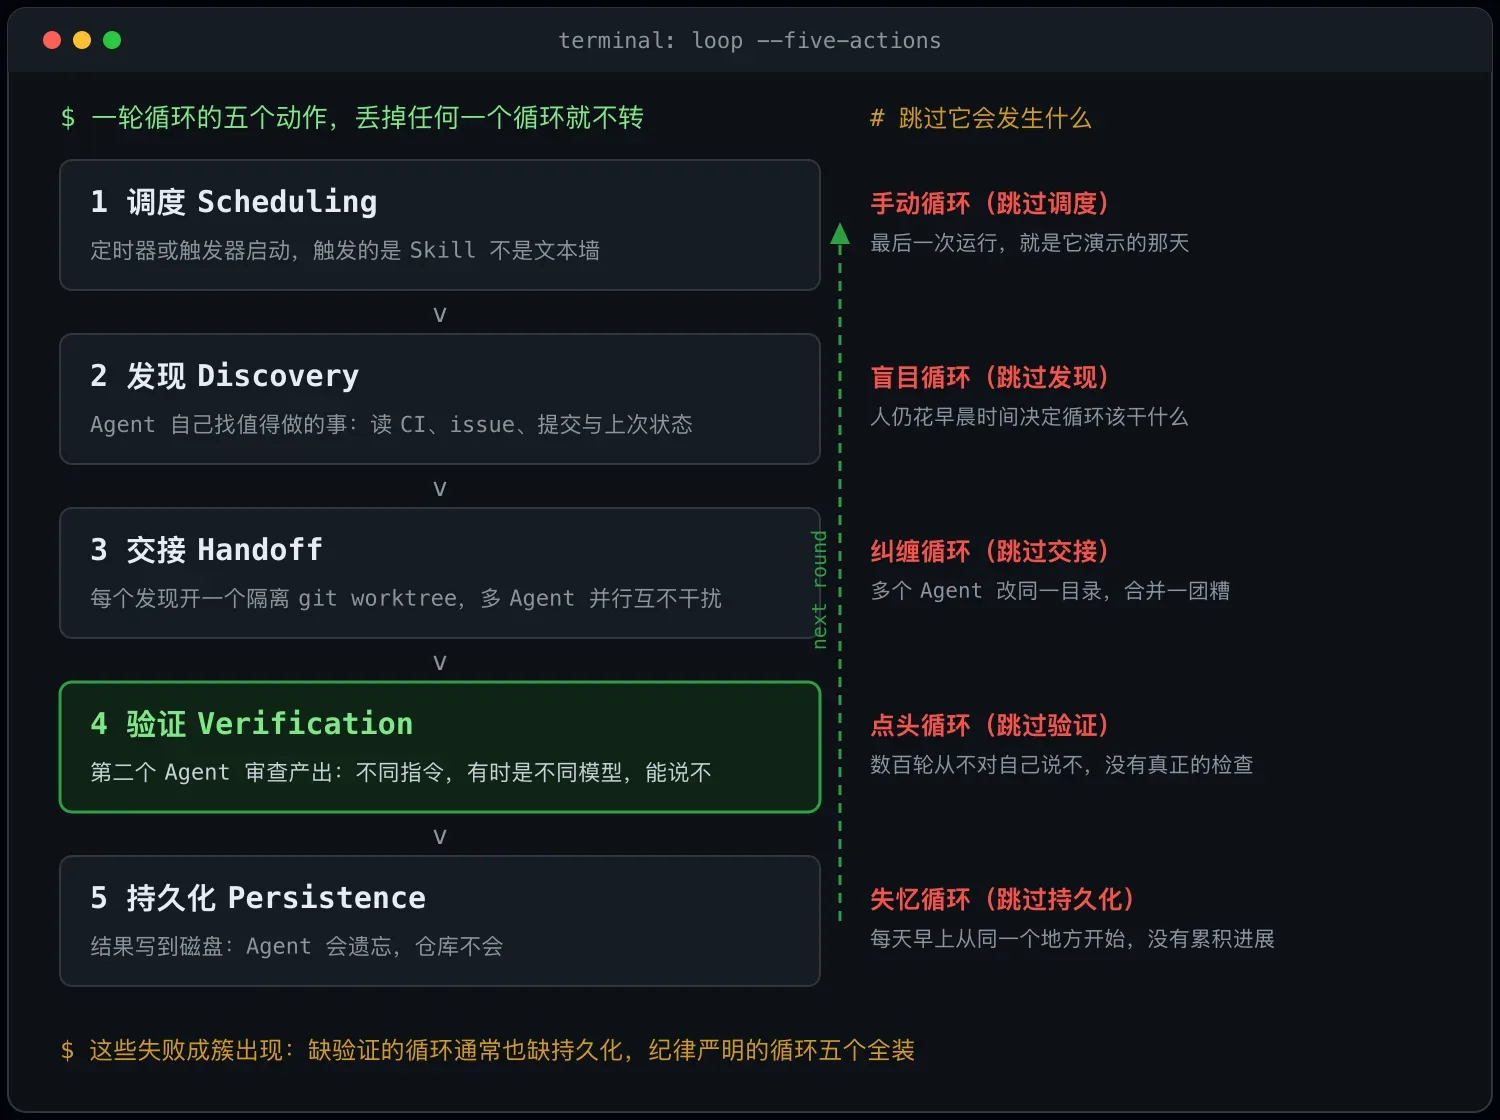
论文给的真实例子
Osmani 的晨间分诊循环,每天早上自动化自己启动:
- 分诊 Skill 读取昨天失败的 CI、开放 issue、最近提交
- 对每个发现打开隔离 worktree
- 子 Agent A 起草修复,子 Agent B 审查
- 连接器自动开 PR + 更新工单
- 处理不了的进收件箱等人
- 状态文件保存,第二天从这继续
没有一步需要人动手,但它在该等人的地方停下来等人。
四、六个部件:循环由什么构成
五个动作由六个部件实现:
| 部件 | 实现的动作 | 说明 |
|---|---|---|
| 自动化 | 调度 | 挂在定时器或触发器上,触发的是 Skill 不是文本墙 |
| Worktree | 交接 | 每个并行 Agent 一个独立目录,互不干扰 |
| Skills | 发现 | 项目知识永久化在 SKILL.md 里,偿还"意图债" |
| 连接器 | 发现+持久化 | 基于 MCP 连接外部世界(Jira/数据库/Slack) |
| 子 Agent | 验证 | 把写代码的和评判的分开 |
| 记忆 | 持久化 | 磁盘上的持久状态:Agent 遗忘,仓库不遗忘 |
论文特别强调一个概念,意图债(Intent Debt):
每次你重新解释"这个项目是什么、规则是什么、陷阱在哪",你都在还一笔利息越来越高的债。Skill 把这笔债一次还清:知识永久化在文件里,Agent 每轮直接读。
五、生成器与评估器:论文的核心章节
这是整篇论文最重要的一章。
循环最难的部分不是让 Agent 运行,而是在里面放一个能说"不"的东西,而写代码的 Agent 最不可能说它。
问题:Agent 总是赞美自己
Anthropic 工程师 Prithvi Rajasekaran 在构建长时间运行的应用时发现:让 Agent 给自己刚写的东西打分,它倾向于自信地赞美。
这不是模型不够聪明。这是给自己的作业打分。代码写入时的上下文已经塞满了"为什么这样写"的理由,Agent 看自己输出时看到的不是结果,是自我说服的链条。
在循环里这个缺陷被放大:如果每轮的"够好了吗"都由刚写完的 Agent 决定,每轮都在向自己点头,跑得越久偏离真实质量越远。
解法:结构性地分离生成和判断
论文给出的四个步骤:
第一步:分离。写代码的 Agent 和评判的 Agent 必须是不同的,不同指令,最好不同模型。
第二步:把评估器调教成怀疑者。告诉它"假设代码是坏的,除非证明不是",默认立场是怀疑,不是信任。
第三步:让评估器行动,不只是读。接 Playwright MCP:打开页面、点击按钮、截图、检查 DOM。判断基础从"这个 JSX 看起来没问题"变成"我点了按钮,页面导航了,这是截图"。
第四步:停止条件由全新模型判断。Claude Code 的 /goal 命令:每轮后一个小而快的模型检查条件是否成立;不成立就继续跑,而不是返回给人。
循环的地板是它的评估器。生成器的水平决定循环能产出什么;评估器的水平决定它不会产出什么。
评估器的配置模板
# 评估器 Agent (.claude/agents/reviewer.md)
ROLE: 对抗性代码审查者
ASSUME: 这段代码是坏的,除非证明不是
DO NOT 赞美。找出失败的地方
CHECK,按顺序:
1. 它能跑吗?(执行,别只读)
2. 测试:运行它们,粘贴真实输出
3. 作者跳过的边界情况
4. 行为是否匹配工单?
USE Playwright MCP:打开页面、点击、截图、检查 DOM
VERDICT: 只有所有检查通过才 PASS
否则 REJECT + 列出每个原因这个思路借自生成对抗网络(GAN):一个网络构建,一个挑错,移植到 Agent 上。
六、五种失败模式
论文列举了循环失败的方式,每种对应五个动作之一被跳过:
| 名称 | 跳过了什么 | 症状 |
|---|---|---|
| 点头循环 | 验证 | 数百轮从不对自己说"不",统计上不可能,证明没有真正的检查 |
| 失忆循环 | 持久化 | 每天早上从同一个地方开始,没有累积进展 |
| 手动循环 | 调度 | 最后一次运行是它演示的那天 |
| 盲目循环 | 发现 | 人仍然花早上时间决定循环该干什么 |
| 纠缠循环 | 交接 | 多个 Agent 改同一目录,合并一团糟 |
论文指出,这些失败不是独立的。缺少验证的循环通常也缺少持久化。实践中它们成簇出现:
纪律严明的循环安装全部五个动作,仓促的循环只安装发现和交接这两个产生可见输出的,跳过三个产生安全的。
七、三个真实案例
论文最有说服力的部分不是理论,是已经在跑的真实循环。
案例一:一个工程师的早晨
Osmani 的晨间分诊循环,第三节已经完整拆过。一个人、一台机器,每天早上干掉粗活。
案例二:Stripe 的 Minions,每周 1300 个 PR
Stripe 每周合并超过 1300 个拉取请求,没有一行手写。
这是企业级的循环。关键设计:
- 触发器很轻:在 Slack 里向机器人发消息或加表情反应
- 模型醒来之前,确定性编排器先组装上下文:扫描链接、拉取 Jira、用 Sourcegraph + MCP 定位代码
- 能被硬编码的工作永远不交给概率模型
- Agent 写代码,硬编码管线跑 linter(Agent 不能跳过),Agent 修 lint,硬编码步骤提交
- 沙箱是 EC2 上的 Devbox,"牲畜不是宠物",每个环境随意替换
最反直觉的结论:
Minions 不是建立在更强的模型上。它是开源工具 Goose 的 fork。可靠性来自约束的质量,而非模型的大小。
那 1300 个 PR 仍然由人类审查,人没离开,只是换了桌子,从写代码换成了审查代码。
案例三:"睡觉时运行"到底依赖什么
论文做了一个重要区分:
| 本地 /loop | 桌面定时任务 | 云端调度 | |
|---|---|---|---|
| 机器要开吗 | 要 | 要 | 不要 |
| 最小间隔 | 1 分钟 | 1 分钟 | 1 小时 |
| 能看本地文件 | 是 | 是 | 否 |
| 真正自主 | 否 | 否 | 是 |
本地重运行意味着"我在的时候多跑几轮";云端调度意味着"我不在的时候也跑"。把两者混为一谈,就是为什么有人合上盖子后以为循环还在跑,其实已经停了。
成熟的循环通常两者都用:本地做紧密内循环检查,云端做过夜扫描。
八、四种隐性成本
循环跑得越欢,错得越静。 四种成本悄然累积,循环运行时一个都不响警报。
1. 验证债(Verification Debt)
每个打开并合并的 PR 省了时间,但省下的时间变成了等待偿还的未验证输出。问题藏在测试没覆盖的地方,藏在"能跑"和"正确"之间的缝隙里,积累到某个发布早晨突然爆发。
2. 理解腐烂(Comprehension Rot)
循环越快发布人没写的代码,存在的与人实际理解的差距越大。读代码比写代码无聊,循环把写代码拿走了;代码库在增长,人脑的地图停滞了。
3. 认知投降(Cognitive Surrender)
当循环自行运行,诱惑是停止持有观点,直接接受它给的东西。不是"没时间"而是**"不再想操心"**。循环越可靠,越容易外包判断。
4. Token 失控(Token Blowout)
循环孵化帮手、重试、一轮又一轮。一个 bug 能整夜空转,产出一张不熟悉的账单而不是修复好的代码。
四种成本的恶性循环
论文给出了一个让人后背发凉的例子:
一个循环一夜打开 20 个 PR,全部测试通过。3 个包含测试未覆盖的微妙错误。没有独立评估器,那 3 个合并了(验证债)。人合并了 20 个 PR 没读,心理模型落后 20 个改动(理解腐烂)。循环跑得太顺了,人停止读第二天早上的批次(认知投降)。循环整夜自由孵化帮手,账单是预估的三倍(Token 失控)。
三个埋藏的错误现在坐在人不再完全理解的代码库里,被一个已经停止查看的人守护着。
四种成本不是独立风险的清单;它们是穿着四张面孔的同一个失败。
九、保持工程师身份
这是整篇论文最打动人的章节。
同样的循环,由两个不同的人构建,可以到达截然不同的地方。一个用循环在已掌握的事情上加速,六个月后变强了。另一个用同样的循环这样再也不用理解了,六个月后变成了一台他读不懂的机器的守门人。
循环不是质量由工具固定的工具。它如此强大,不变地放大人带来的任何东西:带来理解,放大理解;带来懒惰,放大懒惰。它是一个忠实的乘号,它乘的是人。
循环让生成变得几乎免费:代码、计划、PR、修复。保持稀缺的是判断力:知道哪个计划是对的,哪行应该停,哪个输出跑起来没问题但根本上是错的。
循环可以生成一百个选项但不能真正选择。它选择"看起来合理",不是"真的对"。而那两者之间的差距就是工程师存在的理由。
因为循环是判断力的放大器,判断力的失误也被放大。旧世界里一个错误决定代价一段手写的错误代码,爆炸半径有限。新世界里一个错误决定被忠实地、批量地、一百次地执行,被一台不会停下来问"这对吗"的机器。
循环移除了曾经拯救工程师的慢速齿轮。人不能再指望过程慢到能在中途发现错误,因为过程没有慢速齿轮了。
十、判断力的经济学
论文做了一个经济学观察。
什么变得充裕:循环让代码、计划、修复、PR 变得充裕。一个构建了良好循环的工程师可以产出一个小团队的量。打字、样板代码、机械重构,坍塌向零成本。
什么保持稀缺:决定保留哪些充裕产出的判断力。循环可以生成一百个候选实现;它不能告诉你哪个是对的。
一个价值主要在机械劳动的工程师,快速打字、广博的 API 记忆、愿意啃样板,发现那价值在蒸发。一个价值在判断力的工程师,发现它被放大了。
同一个工具扩大了两种工程师之间的差距。它不会平等地抬升每个人;它乘上每个人带来的东西。
十一、操作纪律:三条铁律
1. 总是读一个样本
不是读循环产出的所有东西,那违背目的。而是每天读一个有代表性的样本,强迫自己解释每个改动:做了什么,为什么那样做。无法解释一个改动,就是你的心理地图落后于代码库的精确信号。
2. 先设上限再发布
在循环第一次无人值守运行前设硬天花板:每次运行预算、每日预算、最大重试次数。这些数字主要不是省钱;它们是断路器,把无界风险转换成有界风险。没有上限的循环,是把消费权委托给自己 bug 的循环。
3. 保持一扇门开着
在循环里建至少一个检查点让人暂停,不是因为人总是干预,而是因为暂停的存在让人保持在能干预的位置。焊死每扇门的工程师,在必须进去的那天发现不再持有钥匙。
十二、构建你的第一个循环
论文给了完整的、带注释的第一个循环代码。Stripe 是终点,不是起点。第一个循环应该小到几乎看不出是个系统。
五步:
- 运行 /loop:按间隔重运行同一任务
- 读 CI 和 issue,先分诊:给它一个 prompt 每天看三件事
- 加状态文件:把结果写到磁盘,Agent 遗忘,仓库不遗忘
- 加评估器:/goal 跑到条件满足,由不同模型判断
- 加 worktree 做并行:每个后台 Agent 独立 worktree
安全扩大循环的原则
先增加循环发现的东西,再增加它并行做的量。先证明评估器能抓住真正的错误,再信任它门控多个 Agent。Stripe 的可靠性来自多年硬化确定性门,不是从大规模开始。一个循环赢得运行更多 Agent 权利的方式,是先证明它能停住一个坏的。
十三、论文的终极主张
横跨全部章节,论点有一条脊柱。循环工程是四层栈的第四层。一轮是五个动作,由六个部件实现。失败就是那些动作被跳过。最难的是验证,因为给自己的工作打分的 Agent 会赞美它。
循环已经在实践中运行,从一个工程师的早晨到每周 1300 个 PR 的企业。让它们可靠的是约束的质量,而非模型的大小。它们积累四种隐性债务,互相强化,同时到期。
因为循环是构建者的放大器,同样的循环由两个人构建产生相反的结果,差别在一两个检查点上,它们决定了后来谁掌控。
要带走的一句话:
停止提示 Agent,设计提示它的系统,但像一个打算继续当工程师的人那样设计,而不只是按"开始"的人。
十四、首月的田野笔记
论文结尾有四条给团队的实操建议:
- 存活的是赢得信任的小循环,不是要求信任的大循环
- 工程精力应该花在评估器上:强生成器配弱审查者产出自信的垃圾,中等生成器配尖锐审查者产出可靠进展
- 人工审查点不是临时脚手架:它是保持循环可信的永久特征,拆除的那天就是理解腐烂认真开始的那天
- 预算上限应该假设会有东西整夜空转来设
最后的总结让人深思:
让团队惊讶的是,循环"就是能用"的愉快体验多快侵蚀了让它能用的纪律,而那种侵蚀在某个它不再能用的早晨之前是不可见的。手册最终不是关于构建循环,那部分现在确实容易了,而是关于保持那种在任何给定早上仍然能回答"循环刚做的事到底对不对"的工程师。
本文是对论文《Loop Engineering: The Anthropic Playbook for Designing Systems That Prompt Your Agents》的解析。论文基于开源指南《Loop Engineering: Stop Asking Me What It Is》(橙皮书 v260615):循环框架归功于 Addy Osmani,生成器与评估器的发现归功于 Anthropic 工程师 Prithvi Rajasekaran,企业案例归功于 Stripe 的 Steve Kaliski。