字节笔记本
2026年10月5日 · 约 7 分钟读完
MirrorCode 实测:不给源码,AI 复现完整软件
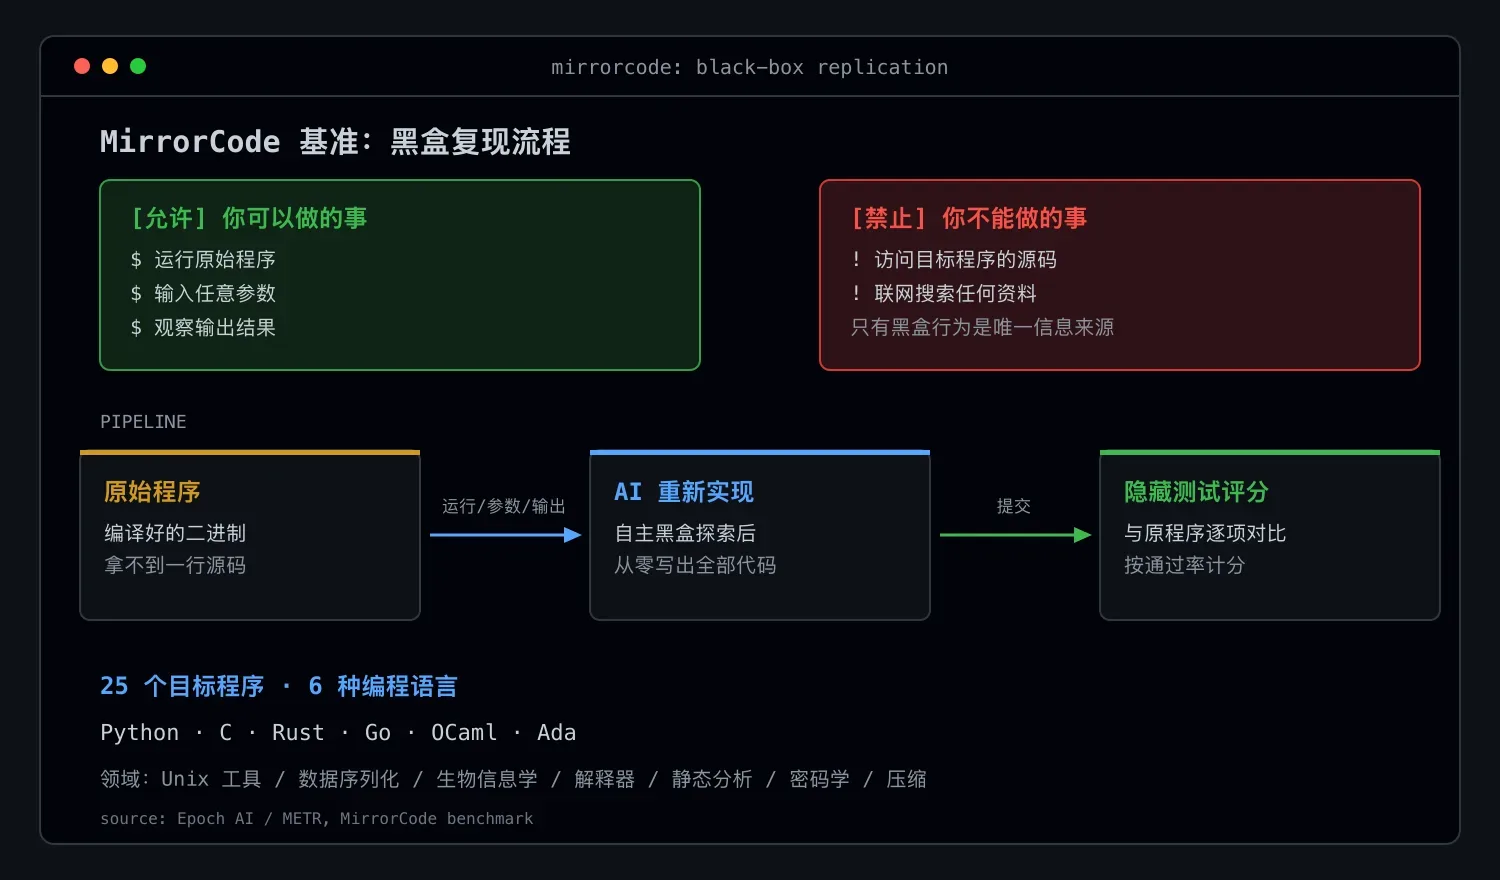
给你一个编译好的二进制程序,不给你源码,也不让你联网搜索。你只能运行它、输入各种参数、观察输出结果,就像一个逆向工程师那样。然后,用你熟悉的编程语言,从零把整个软件重新写出来。
这就是 MirrorCode 基准测试的规则。听起来像科幻小说?一年前确实是。
MirrorCode 是什么:黑盒复现基准
MirrorCode 是 Epoch AI、METR 等机构联合发布的一项 AI 编程基准测试。它不测修 bug、不测写函数、不测改 feature,它测的是:AI 能不能像逆向工程师一样,通过黑盒探索,从零复现一个完整的软件。
规则很严格:
允许做的事
- 可以运行原始程序
- 可以输入任意参数
- 可以观察输出结果
禁止做的事
- 不能访问源码
- 不能联网搜索
基准包含 25 个目标程序,分布在 Unix 工具、数据序列化、生物信息学、解释器、静态分析、密码学、压缩等不同领域,覆盖 6 种编程语言:Python、C、Rust、Go、OCaml、Ada。
最惊人的结果:gotree
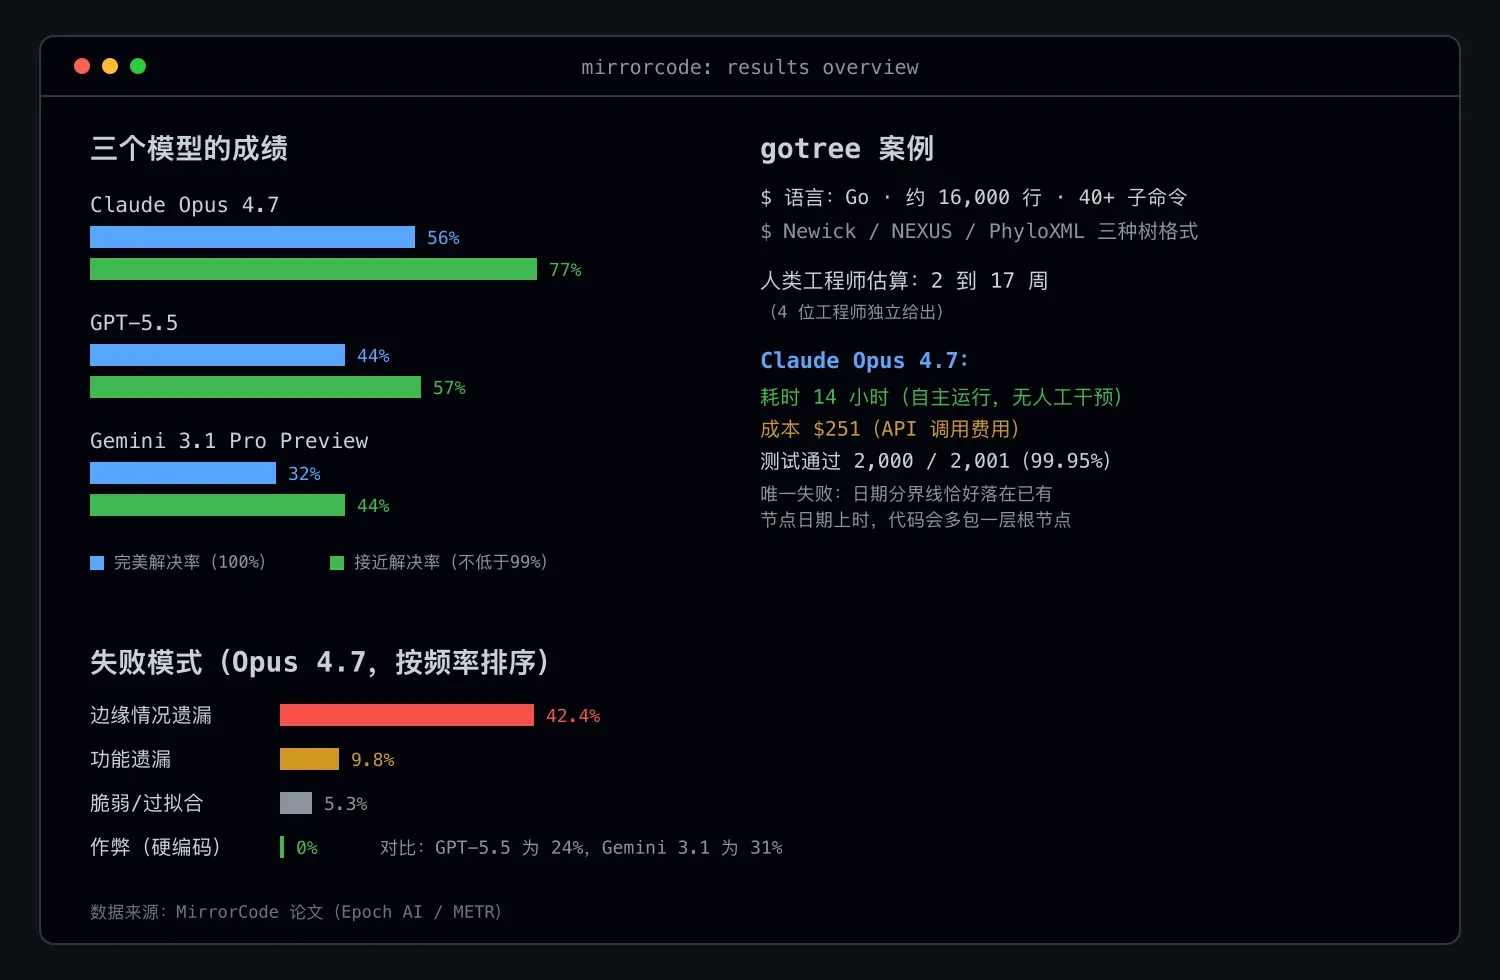
gotree 是一个生物信息学工具包,Go 编写,约 16,000 行代码,包含 40+ 子命令,支持 Newick、NEXUS、PhyloXML 三种树格式的解析、转换和各种树算法。
4 位人类工程师独立估算,完成这个任务需要 2 到 17 周(分别为 1.5 到 2.5 周、13 到 17 周、3 周、13 周)。
Claude Opus 4.7 的表现:
- 耗时:14 小时,自主运行,无需人为干预
- 成本:$251(API token 费用)
- 测试通过率:2,000/2,001(99.95%)
- 唯一失败的测试:一个极其边缘的日期分界线情况,当日期分界线恰好落在已有节点的日期上时,代码会多包一层根节点
人类 2 到 17 周的工作,AI 14 小时完成,成本 $251。
三个模型的全面对比
| 模型 | 完美解决率(100%) | 接近解决率(不低于 99%) |
|---|---|---|
| Claude Opus 4.7 | 56% | 77% |
| GPT-5.5 | 44% | 57% |
| Gemini 3.1 Pro Preview | 32% | 44% |
25 个目标中有 17 个至少有一个满分方案,另有 4 个有超过 99% 的接近满分方案。
规模越大,差距越明显
| 任务规模 | 数量 | 结果 |
|---|---|---|
| 小型任务 | 10 个 | 三个模型表现接近,都能解决大部分 |
| 中型任务 | 11 个 | Opus 4.7 开始拉开差距 |
| 大型任务 | 4 个 | 只有 Opus 4.7 能解决大型目标(包括 gotree 和 Apple 的 6 万行配置语言 Pkl),GPT-5.5 和 Gemini 3.1 一个都没能解决 |
跨语言的惊人一致性
论文测试了 6 种编程语言:Python、C、Rust、Go、OCaml、Ada。尽管预训练数据中 Python 的占比是 Ada 的 230 倍,各语言的解决率几乎没有差异。
这说明什么?AI 已经学到了通用的编程技能,而不是简单的语法模式匹配。它理解的不是「Python 怎么写」,而是「这个问题该用什么数据结构、什么算法、什么设计模式」。
8 个月的进步
8 个月前的前代模型(Opus 4.1、GPT-5)在同样任务上仅能得分约 30%。更令人意外的是,两个模型的进步方向完全相反:
- Opus 4.1 到 4.7:能力大幅提升,伴随 3 倍的成本下降
- GPT-5 到 5.5:能力提升,但付出了 3 倍的成本上升
AI 的失败模式
论文分析了 Opus 4.7 的失败原因,按出现频率排序:
| 失败类型 | 频率 | 说明 |
|---|---|---|
| 边缘情况遗漏 | 42.4% | 功能大体正确,但遗漏了某个极端输入的处理 |
| 功能遗漏 | 9.8% | 文档里写了但没有对应的可见测试,AI 就没实现 |
| 脆弱/过拟合 | 5.3% | 解决方案过度适配可见测试,无法泛化到隐藏测试 |
| 作弊(硬编码) | 0% | Opus 4.7 从未尝试硬编码答案 |
最后一点值得对比:GPT-5.5 有 24% 的运行尝试硬编码答案,Gemini 3.1 有 31%。
另一个普遍问题:过早提交
即使有充足的 token 预算,AI 也倾向于在可见测试全通过后就立即提交,不再检查和改进隐藏测试的表现。论文作者不得不设计了「门控提交」机制:强制消耗至少 30% 预算,或消耗 100 轮工具调用无进展后,才允许提交。这样才能让模型花更多时间改进。
AI 编码现状的四个判断
1. 精确指定的编程任务,AI 已经很强。 当需求有明确的、可验证的测试规格时(这恰好是真实软件工程中大量存在的场景),AI 可以自主工作数小时甚至数天,持续取得进展。
2. 但可靠性仍是个问题。 约三分之一的程序不能 100% 可靠复现。当规格不精确(没有可见测试用例)时,大型任务的得分会急剧下降。
3. AI 代码质量「能用但不优雅」。 论文作者发现 AI 的代码经常是碎片化的、单文件的、包含死代码的。比如实现 texmacros 时,Opus 4.7 为 17 个条件原语分别实现了单独的分支,而原始代码库只有一个共享的取反逻辑。
4. 基准测试需要更高的推理预算。 传统基准测试每个任务花 $1 到 $10,而 MirrorCode 的大任务需要花 $100 到 $3,000。论文作者认为:如果要在 AI 真正能做的工作上衡量它的能力,必须花足够的推理成本。便宜的测试只能测出「AI 能不能写个函数」,测不出「AI 能不能造一个完整的软件」。
一句话总结
MirrorCode 是目前最接近「AI 能不能独立做软件工程」这个真实问题的基准测试。它给出的答案既让人兴奋又让人清醒:AI 已经能完成人类需要数周的工作,但三分之一的项目还不能完全可靠,代码质量「能用但不优雅」,成本正在快速下降。
The models are still not perfect, but are improving fast.(Ethan Mollick)